매번 다 퍼올 필요 없잖아? 당근의 MongoDB CDC 구축기
MongoDB 덤프의 DB 부하와 SLO 문제를 해결하기 위해 CDC를 도입했습니다. Flink CDC와 Spark, 이중 테이블 구조로 적재와 스키마 변경, 정합성 검증을 묶었습니다.
#MongoDB#CDC#Flink
17200
매번 다 퍼올 필요 없잖아? 당근의 MongoDB CDC 구축기
MongoDB 덤프의 DB 부하와 SLO 문제를 해결하기 위해 CDC를 도입했습니다. Flink CDC와 Spark, 이중 테이블 구조로 적재와 스키마 변경, 정합성 검증을 묶었습니다.
Karrot 데이터팀이 BigQuery SQL 로그를 파싱해 컬럼 단위 데이터 계보를 구축한 과정을 소개했습니다. 테이블 단위 한계를 보완하고 영향 분석과 PII 추적을 정교하게 만든 사례입니다.
BigQuery 쿼리 로그를 SQL 파싱해 컬럼 레벨 리니지를 구축한 사례를 소개했습니다. 테이블·컬럼 의존 관계를 빠르게 추적해 데이터 신뢰성과 운영 효율을 높였습니다.
다앙근페이 FDS가 규칙 엔진을 기반으로 이상거래 탐지 체계를 확장한 과정을 소개했습니다. 이후 LLM을 붙여 검토 속도와 판단 일관성을 높이려는 시도를 설명했습니다.
당근페이는 FDS에 룰엔진을 먼저 구축해 이상거래를 유연하게 탐지하도록 만들었습니다. 이후 LLM과 RAG를 붙여 거래 맥락까지 반영하는 AI Powered FDS로 확장했습니다.
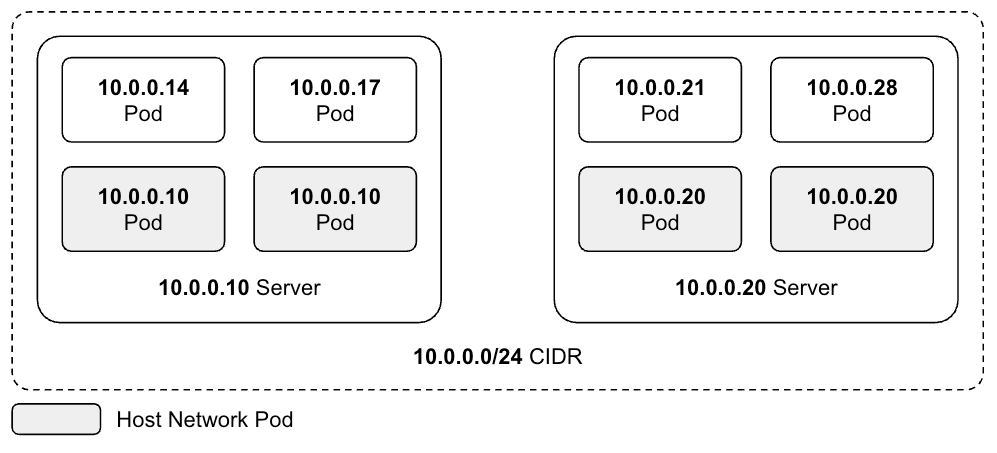
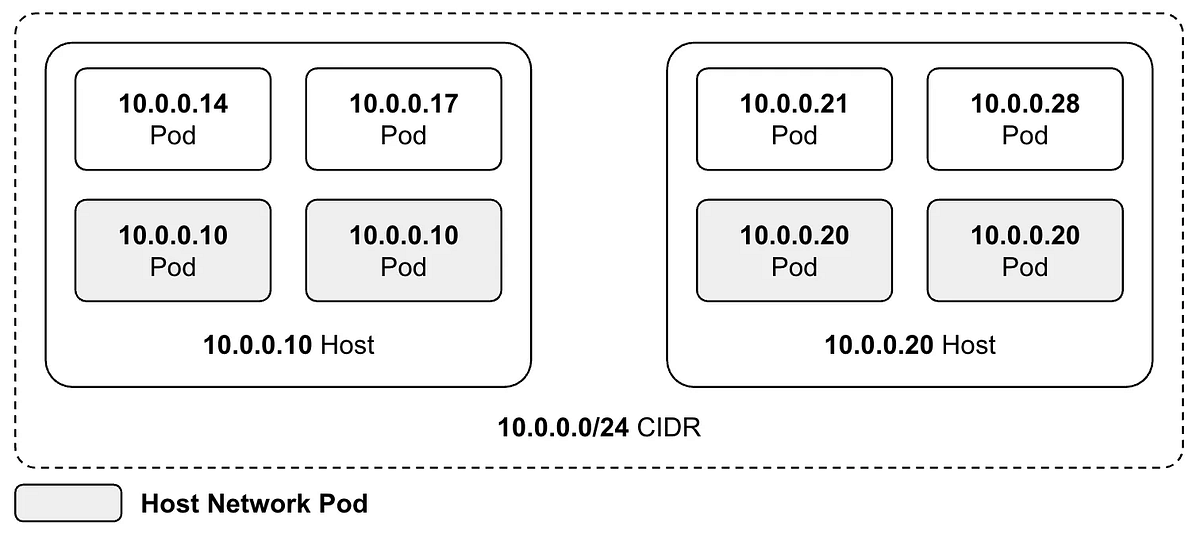
Kubernetes Pod의 Host Network 설정 개념과 장단점을 설명하고, DaemonSet과 Job Pod에 적용한 사례를 공유했습니다. IP 절감과 시작 속도 개선 효과를 얻었지만 포트 충돌 예외 처리가 필요했습니다.
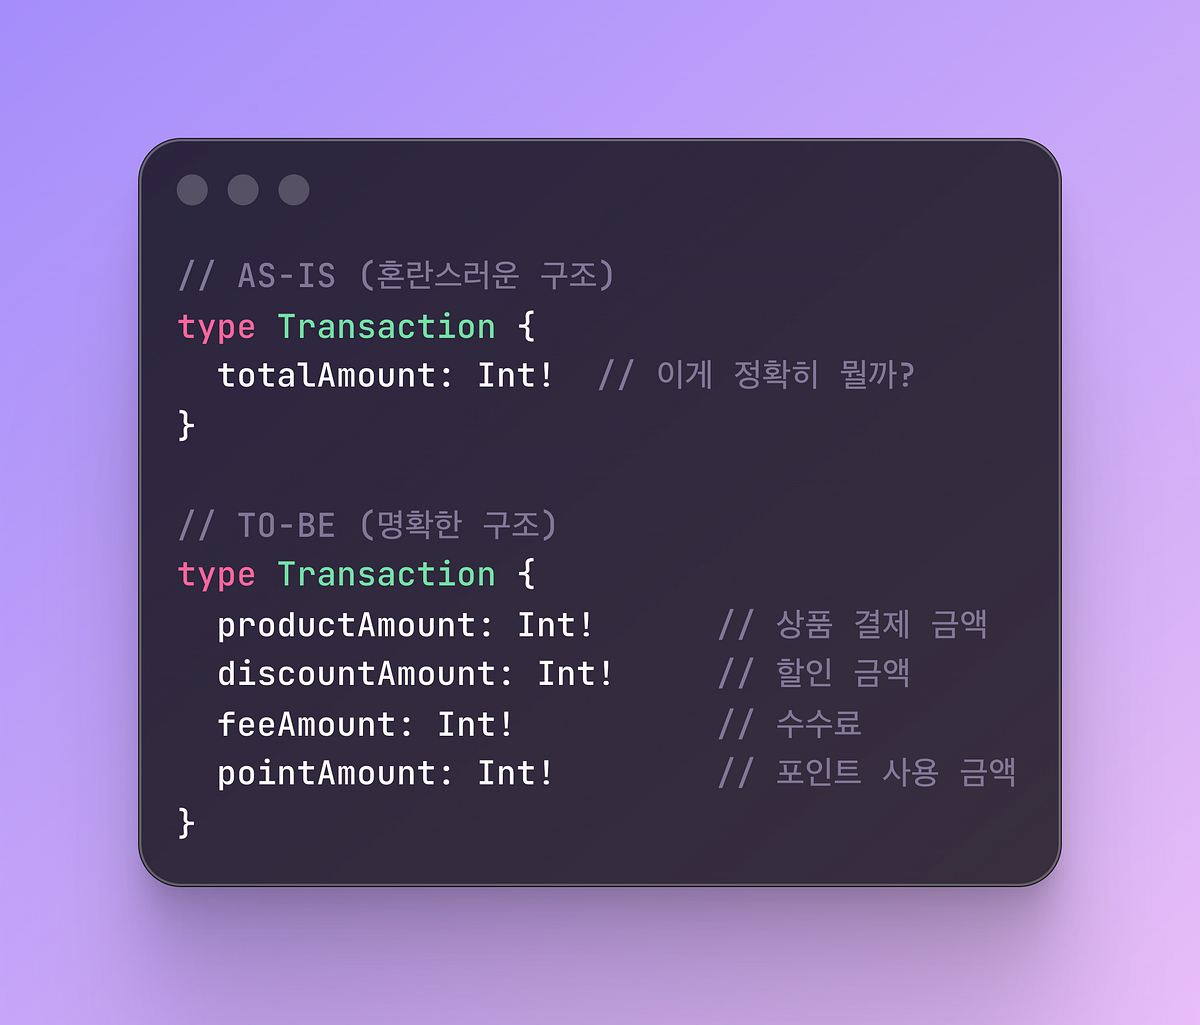
당근페이는 이용내역 개편을 위해 서버 드리븐 UI에서 클라이언트 주도 구조로 전환하고 GraphQL을 도입했습니다. 단계적 마이그레이션과 명확한 스키마 원칙으로 안정성과 확장성을 함께 확보했습니다.
당근페이가 기존 카드망과 EMV QR 표준을 활용해 오프라인 QR 결제를 구현한 과정을 설명했습니다. 또한 세션 기반 QR 발급과 단말기 호환성 대응 등 실전 설계 포인트를 공유했습니다.

쿠버네티스 파드에 Host Network를 적용한 배경과 효과를 정리했습니다. DaemonSet의 IP 절약과 Job 파드의 생성 지연 개선 사례를 함께 소개했습니다.
당근이 AI 활용 경험을 정리한 책 『요즘 당근 AI 개발』을 출간했습니다. 실험적 시도부터 운영 자동화와 플랫폼 구축까지의 실무 경험을 담았습니다.

피드시스템의 반복 장애를 줄이기 위해 프로파일링과 메모리 최적화, 서킷 브레이커를 적용했습니다. 또한 PGO와 SLA/SLO/SLI 기반 모니터링으로 안정성과 성능을 함께 개선했습니다.

비즈니스 가치가 큰 지면부터 p75 LCP를 기준으로 성능 최적화를 진행했습니다. 이미지 경량화, 번들 분리, Preload, Skeleton 적용으로 체감 속도와 지표를 함께 개선했습니다.

웹앱 환경에서 블록 에디터를 직접 개발한 과정을 소개했습니다. ProseMirror를 선택하고 삭제 방지와 스크롤 문제를 해결하며 확장성을 확보했습니다.

서버 로깅 포맷을 통일해 유저·요청 단위 추적과 호출 위치 확인이 쉬워지도록 개선했습니다. 메타데이터와 트레이스를 더해 디버깅과 모니터링 효율을 높였습니다.

DataHub로 메타데이터의 수집과 신선도 관리를 먼저 정비했습니다. 이후 DataWiki와 SSOT를 더해 도메인 맥락까지 담는 데이터 탐색 환경을 구축했습니다.

광고 추천 ML 파이프라인 분리 프로젝트에서 긴밀한 협업 방식을 소개했습니다. 데일리 스레드, 페어프로그래밍, 랜덤 코드 리뷰로 맥락 공유와 지식 확장을 이끌었습니다.

시맨틱 캐싱을 도입해 채팅 AI 메시지 추천의 LLM 호출 비용을 크게 줄인 사례를 소개했습니다. 오프라인과 온라인 검증을 통해 약 25% HIT 비율과 연간 2억 원대 절감 효과를 확인했습니다.
여러 경로로 모은 업체 정보의 중복을 병합으로 정리하고, 변경 이력을 바탕으로 대표 프로필의 값을 고도화했습니다. 필드별 정책을 분리해 더 합리적인 정보를 노출하도록 개선했습니다.