스캐터랩 핑퐁2026년 10월 30일AI전문가의 절반을 내보냈습니다MoE 전문가 사용량 편중을 분석해 REAP 기반 절반 프루닝을 적용했습니다. 유저 지표 차이 없이 GPU당 대화 처리량을 1.6배로 높였습니다.#LLM#MoE700
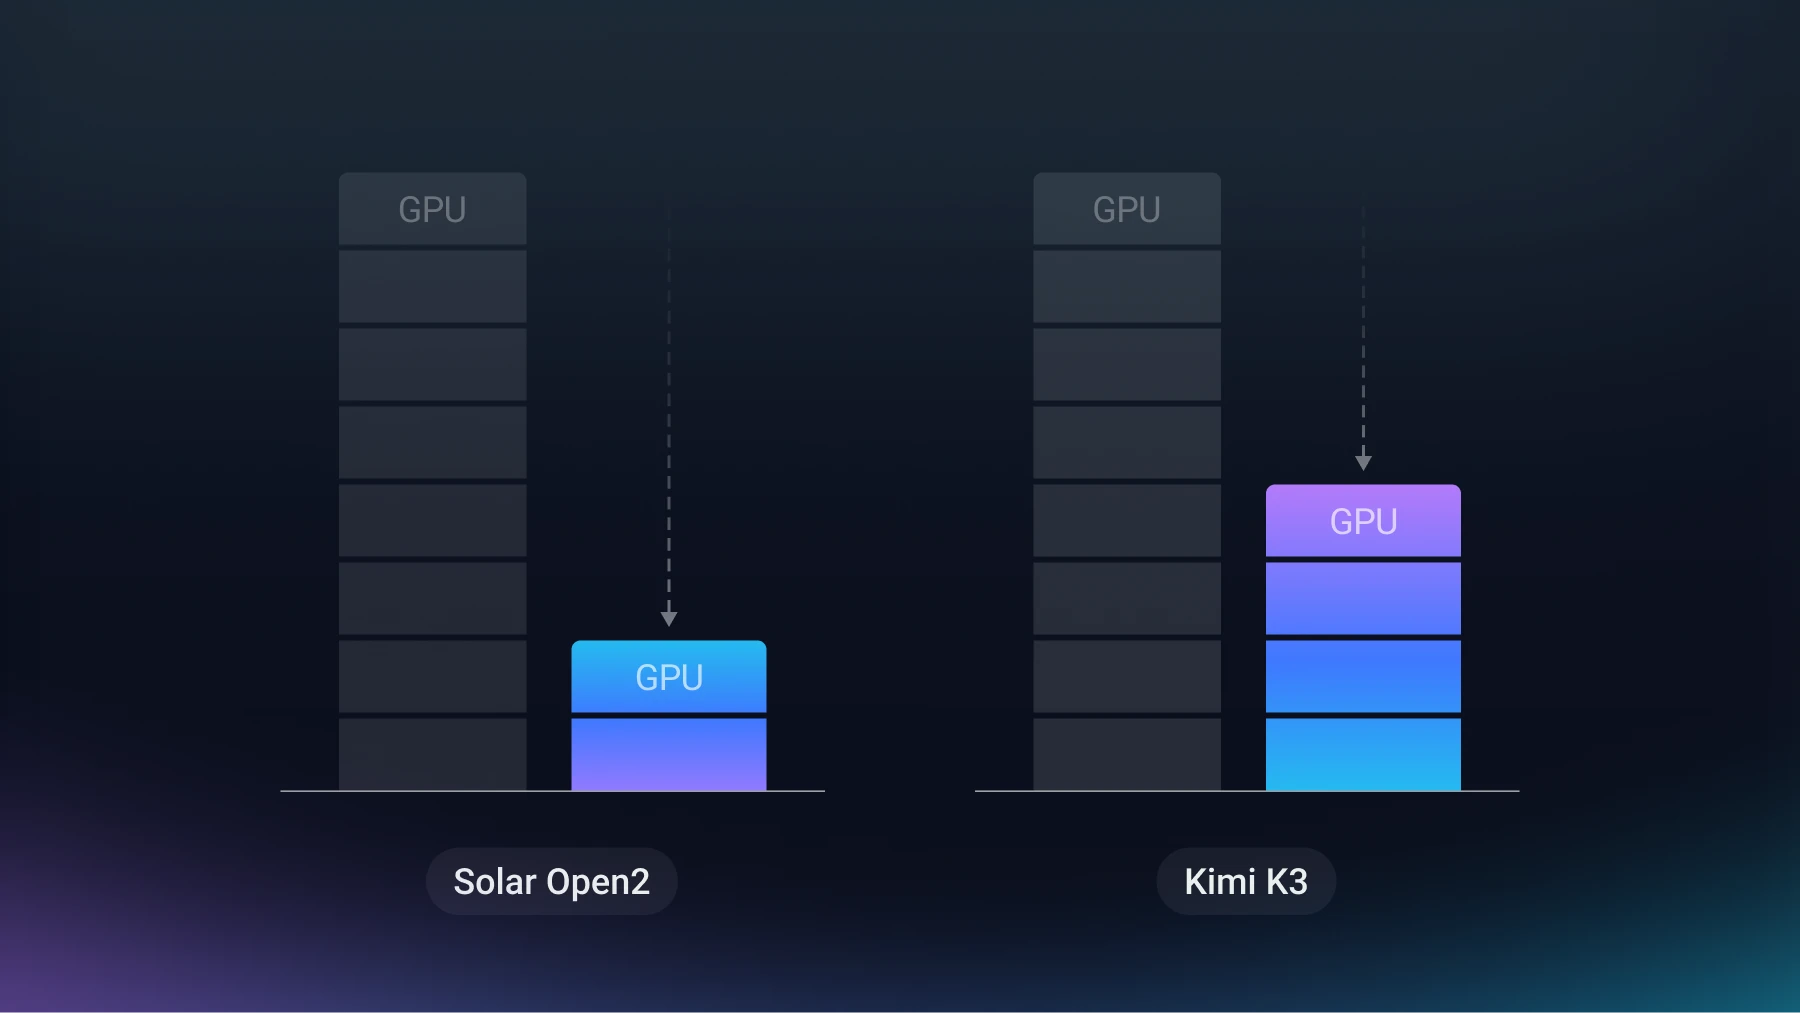
노타2026년 8월 26일AIH100 8장을 2장으로: LLM 경량화가 만든 GPU 비용 절감MoE 양자화와 비균일 전역 프루닝으로 LLM 가중치 메모리를 줄이는 사례를 소개했습니다. Solar Open2와 Kimi K3의 GPU 구성 축소 및 벤치마크 결과를 비교했습니다.#LLM#MoE000