

Claude 토큰 사용량을 줄이고 효율적으로 사용하는 방법
Claude의 비용은 프롬프트 길이보다 매 턴 재전송되는 컨텍스트 크기에 크게 좌우됨을 설명했습니다. 캐싱, 도구 정리, 세션 분리와 측정 기반 모델 선택으로 토큰을 절감하는 방법을 정리했습니다.
#Claude#LLM
1900
Claude의 비용은 프롬프트 길이보다 매 턴 재전송되는 컨텍스트 크기에 크게 좌우됨을 설명했습니다. 캐싱, 도구 정리, 세션 분리와 측정 기반 모델 선택으로 토큰을 절감하는 방법을 정리했습니다.
모델 교체 뒤 자동 프롬프트 캐시 구분점 정책 변화로 비용이 3.2배 증가한 원인을 분석했습니다. 고정부 경계에 명시 구분점을 두고 히트율과 비용을 운영 지표로 관리했습니다.
자동승인 대기 지연을 줄이기 위해 아웃박스 큐를 걷어내고 단일 폴링 구조로 바꿨습니다. 후보 조회와 재시도를 분리해 외부 부하는 유지한 채 처리 시작 시간을 10초 이내로 개선했습니다.
유령 키로 누적되는 MemoryDB OPTIN tracking item 문제를 BCAST 전환으로 구조적으로 차단했습니다. 리허설 후 failover를 두 차례 수행해 7,684만 개 항목과 메모리 사용률을 정상화했습니다.


배치 완료 알림이 너무 일찍 나가는 문제를 해결한 사례를 다루셨습니다. 처리 순간의 사실을 기록하고 실제 조회 가능 시점을 기준으로 완료를 판정하셨습니다.
몇 달 전 풀었던 문제를 다시 만나 같은 시행착오를 겪은 경험을 바탕으로, AI와의 대화를 팀 지식으로 자동 축적하는 필요성을 정리했습니다. 반복 해결을 줄이고 기억에 의존하지 않도록 기록과 재활용 구조를 만들려는 이야기입니다.
`@TransactionalEventListener`는 커밋 이후 실행이 아니라 트랜잭션이 있을 때만 등록됩니다. 트랜잭션 밖 발행 누락은 `fallbackExecution`과 발행 지점의 트랜잭션 검사를 성격에 맞게 선택해야 합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
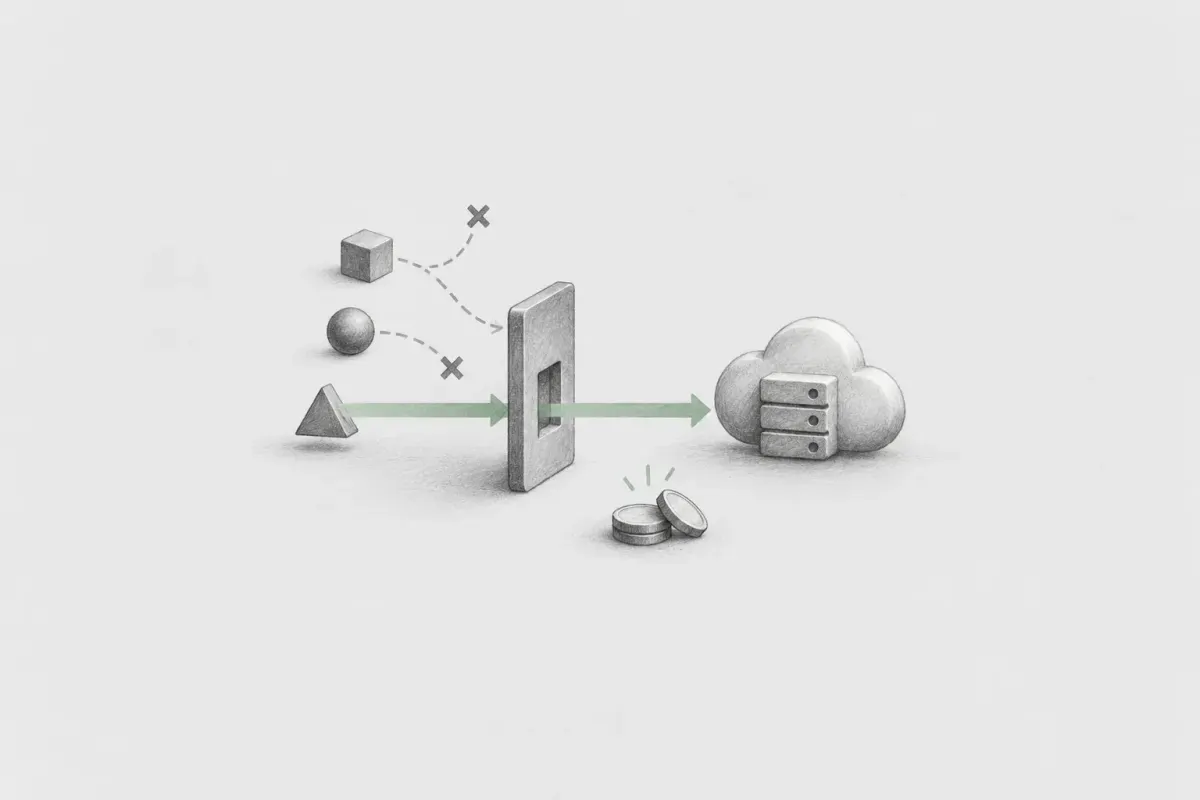
외부 기관 조회 API의 호출 건수 기반 과금 문제를 줄이기 위해 조건부 호출을 적용했습니다. 조회 Timestamp와 배치 갱신, Lazy Loading으로 불필요한 호출을 최소화했습니다.
MemoryDB 메모리 급증의 원인을 Redis 클라이언트 캐싱 tracking item 누적으로 분석했습니다. 존재하지 않는 유령 키 조회가 TTL 없이 기록을 쌓는 구조를 확인했습니다.
IoT 환경에서 Edge Computing을 활용해 현장 데이터 처리와 중앙 통합 처리를 분리한 사례를 소개했습니다. 네트워크 단절 대응, 불필요한 데이터 제거, 데이터 표준화 방식도 함께 설명했습니다.


Claude Code의 토큰 비용을 캐시 경제학과 세션 습관 관점에서 정리한 글입니다. Amazon Bedrock에서는 사용자별 비용 관측과 캐시 효율 관리가 특히 중요하다고 설명했습니다.

EC2에서 EKS로 옮긴 뒤 컨테이너 메모리가 주기적으로 급증하는 현상을 추적했습니다. 원인은 로그 gzip 압축과 페이지 캐시였습니다.

전체 데이터를 브라우저와 Web Worker로 옮겨 광고 대시보드의 필터링과 정렬을 즉시 처리하도록 개선했습니다. 그 결과 속도뿐 아니라 누락 데이터, URL 검증, 정렬 제약 같은 구조적 문제도 함께 해결했습니다.

Java 25의 Scoped Value 설계 원칙과 API 사용 패턴을 정리했습니다. 실무 적용 한계와 전환 판단 기준까지 함께 다뤘습니다.