
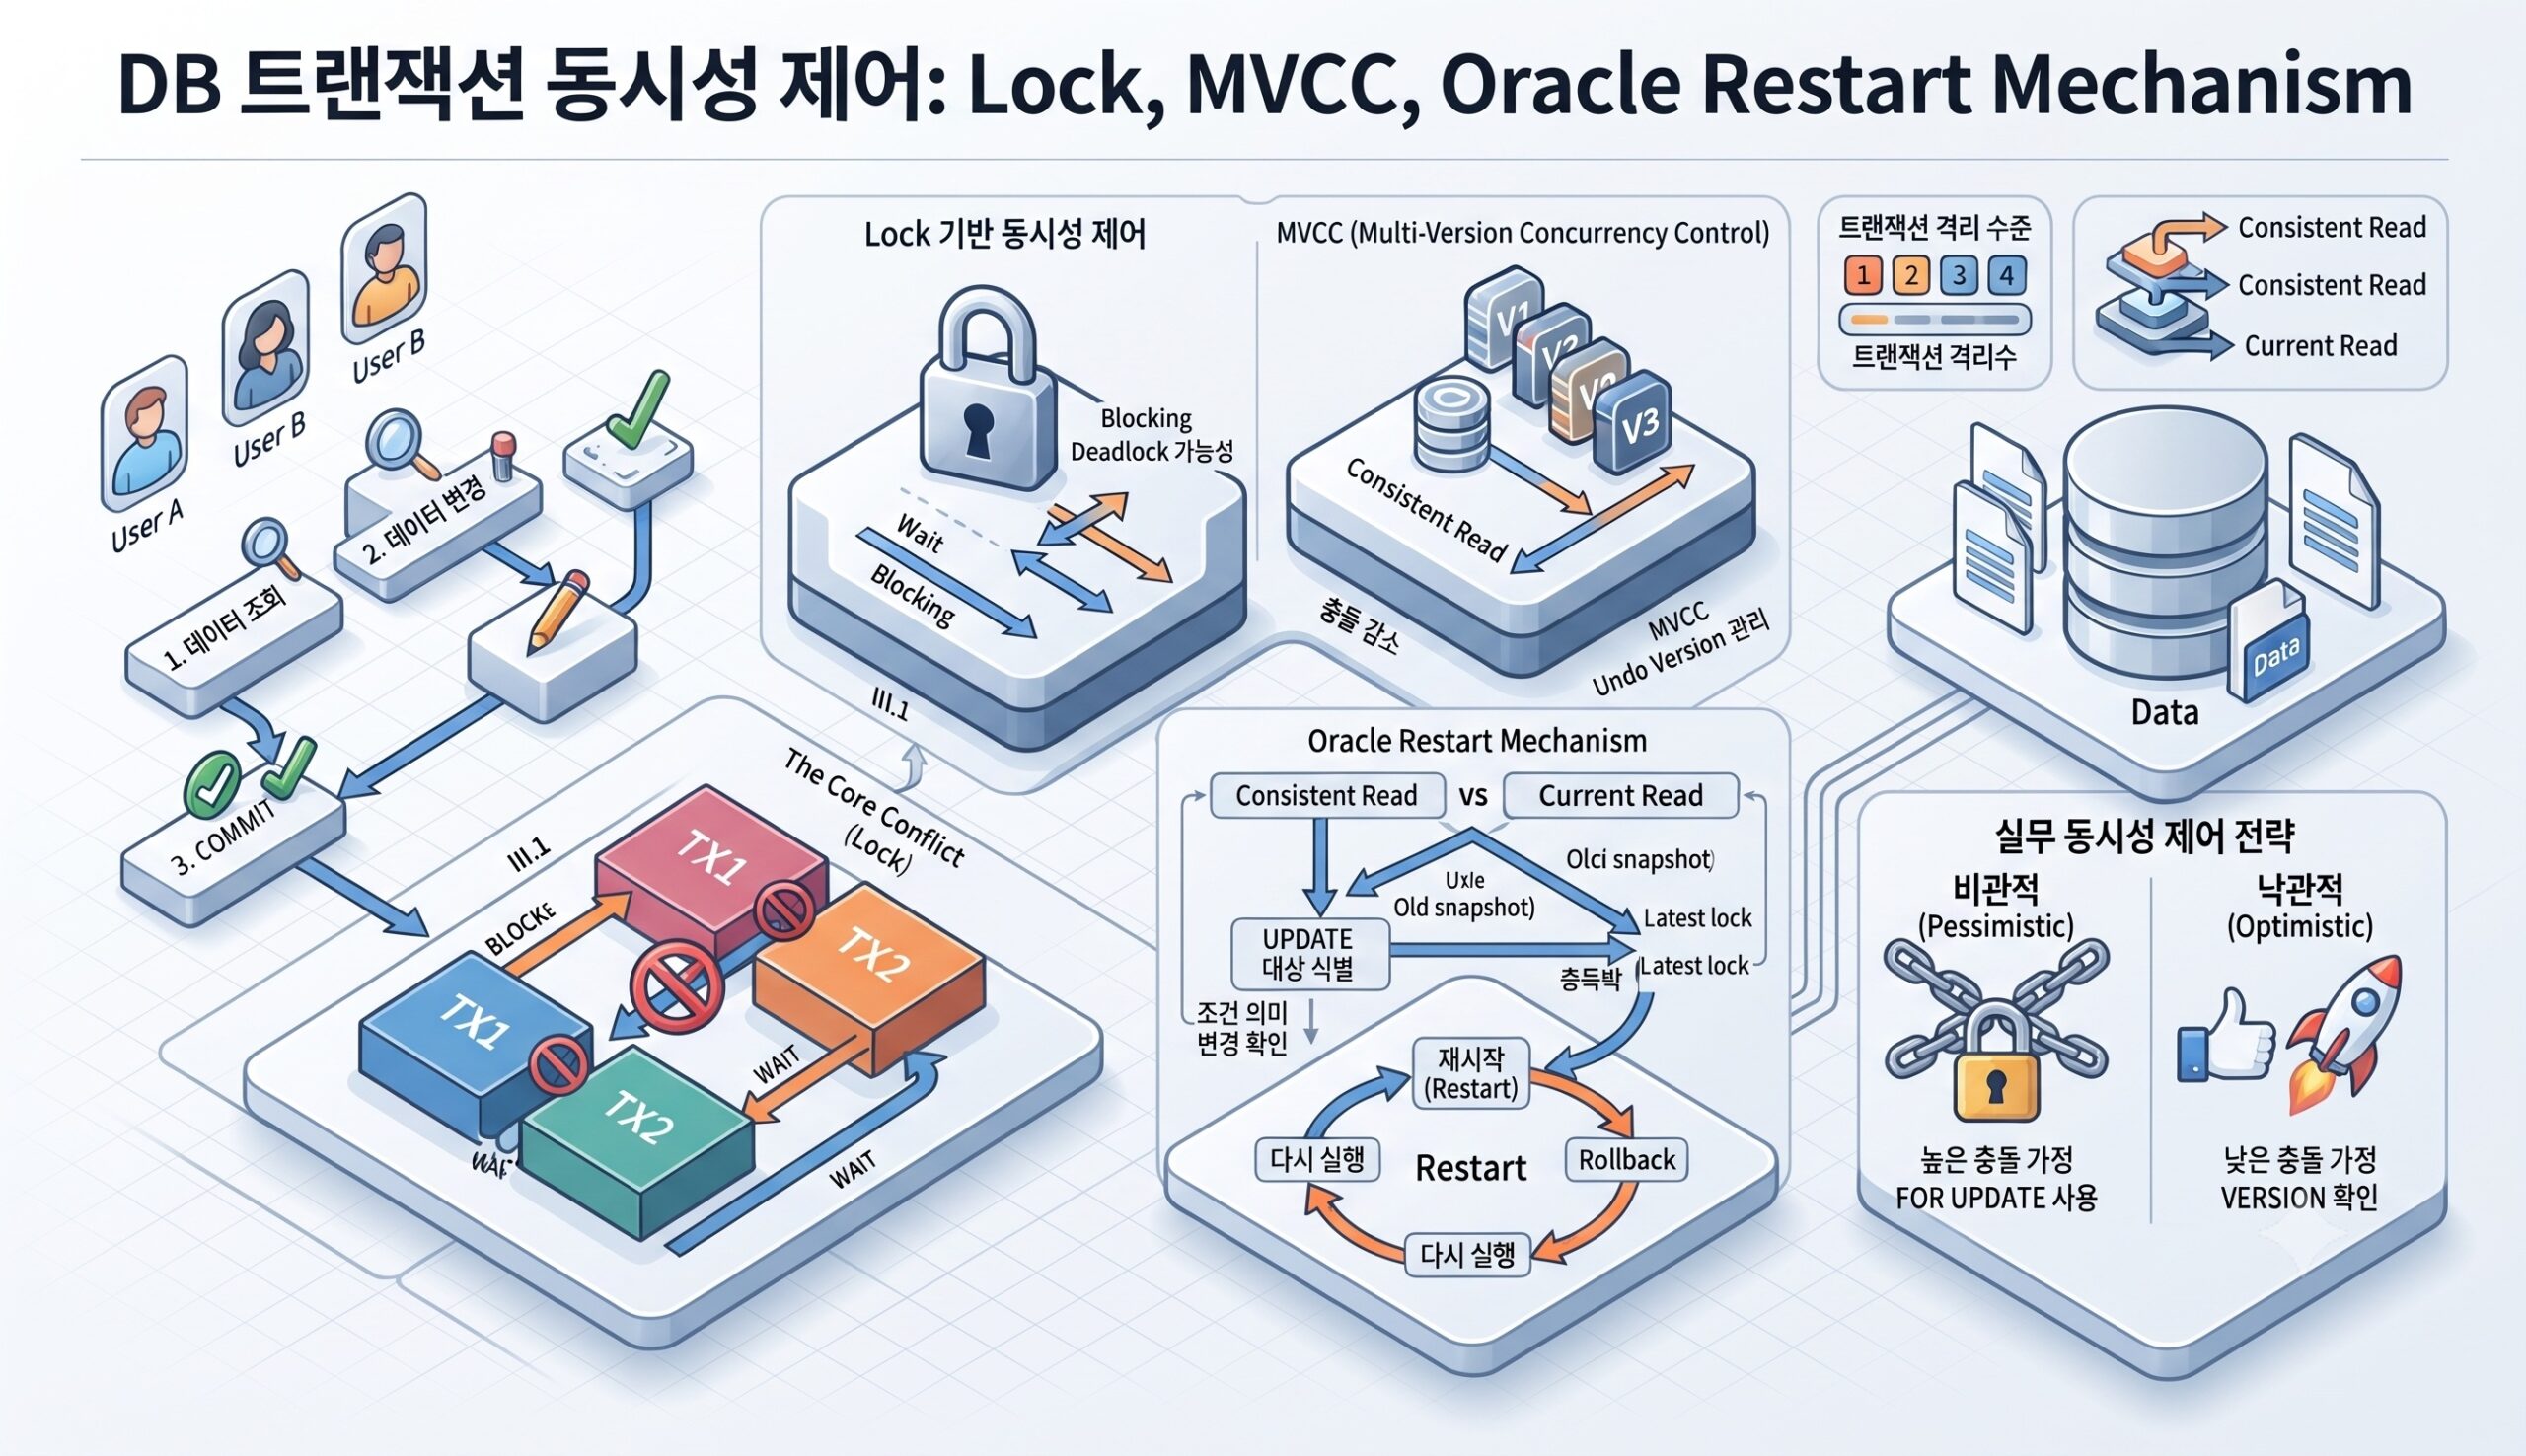

DB 트랜잭션 동시성 제어: Lock, MVCC 그리고 Oracle Restart Mechanism
Lock, MVCC, 격리 수준을 바탕으로 DB 트랜잭션 동시성 제어를 설명했습니다. Oracle Restart Mechanism과 비관적·낙관적 제어의 선택 기준을 정리했습니다.
#transaction#동시성
2300
Lock, MVCC, 격리 수준을 바탕으로 DB 트랜잭션 동시성 제어를 설명했습니다. Oracle Restart Mechanism과 비관적·낙관적 제어의 선택 기준을 정리했습니다.

평균 지표에 가려진 Oracle 커밋 지연을 CPU별 NIC 인터럽트와 LGWR 경합으로 분석했습니다. NIC 슬롯과 본딩 방식을 바꿔 인터럽트를 분산하고 CPU·SQL 성능을 개선했습니다.


Oracle에서 PostgreSQL로의 마이그레이션에서 가장 큰 병목인 저장 프로시저 변환을 멀티 에이전트 GAMMA로 자동화하는 내용을 다뤘습니다. 의존성 분석, 코드 생성, 검증, 지식 축적을 결합해 수동 작업을 줄이고 정확도를 높이는 방법을 소개했습니다.

옴니채널 재고 정합성과 확장성 문제를 해결하기 위해 인벤토리 데이터 파이프라인을 이벤트 기반으로 재설계했습니다. Spring Batch, Kafka Fan-Out, Push/Pull 분리로 리드타임과 부하를 줄였습니다.

Oracle 마이그레이션을 데이터 이전이 아닌 Use Case 이전으로 접근하는 전략을 소개했습니다. Lakehouse Federation, Lakebridge, GenAI Migration으로 단계적 자동화를 제안했습니다.

스마트스토어센터가 Oracle에서 MySQL로 무중단 전환한 방법을 이중 쓰기 중심으로 설명했습니다. JPA와 MyBatis에서의 트랜잭션 처리, PK와 컬럼 타입 조정까지 다뤘습니다.

여기어때컴퍼니의 Oracle to Aurora MySQL 마이그레이션 사례를 소개했습니다. 생성형 AI 기반 OMA로 6주 만에 대규모 전환과 검증을 완료했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

품절 조회를 Oracle 함수 중심 구조에서 Kafka Streams 기반 EDA로 전환해 실시간 재고 처리를 개선했습니다. 그 결과 올영세일 기간 Oracle 함수 호출량을 크게 줄이며 서비스 안정성을 높였습니다.
AWS DMS의 Data Resync 기능으로 마이그레이션 중 데이터 불일치를 자동으로 수정하는 방법을 소개했습니다. Full load와 CDC 작업에서의 구성 방식과 운영 시 주의점도 함께 설명했습니다.

Spring Data JDBC에서 LocalDate 컨버터가 기대와 다르게 동작하는 이유를 JDBC 내부 처리 순서와 Oracle 드라이버 차이로 분석했습니다. 이를 피하기 위해 커스텀 래퍼 타입과 양방향 컨버터로 저장 형식을 제어하는 방법을 정리했습니다.

MySQL 기본 격리 수준인 REPEATABLE READ 때문에 결제 트랜잭션에서 오래된 잔액이 유지되는 문제를 겪었습니다. 락 위치와 격리 수준을 조정해 동시성 이슈를 해결하는 과정을 정리했습니다.
Oracle 복제 전환 과정에서 child cursor 폭증으로 주문 동기화 지연이 발생했습니다. 바인딩 타입 고정과 TIMESTAMP 정규화 등으로 성능을 안정화했습니다.
신규 서비스 ‘꿀템’을 만들기 위한 기획과 테이블 설계 과정을 소개했습니다. 놀이공원 비유로 핵심 개념을 정리하고, 확장성과 운영성을 고려해 데이터 구조를 설계했습니다.
신규 서비스 꿀템 피드를 만들기 위해 개념 정의부터 테이블 설계, ERD 구성까지의 과정을 소개했습니다. 확장성과 정합성을 고려해 커뮤니티 기능과 데이터 구조를 설계했습니다.