
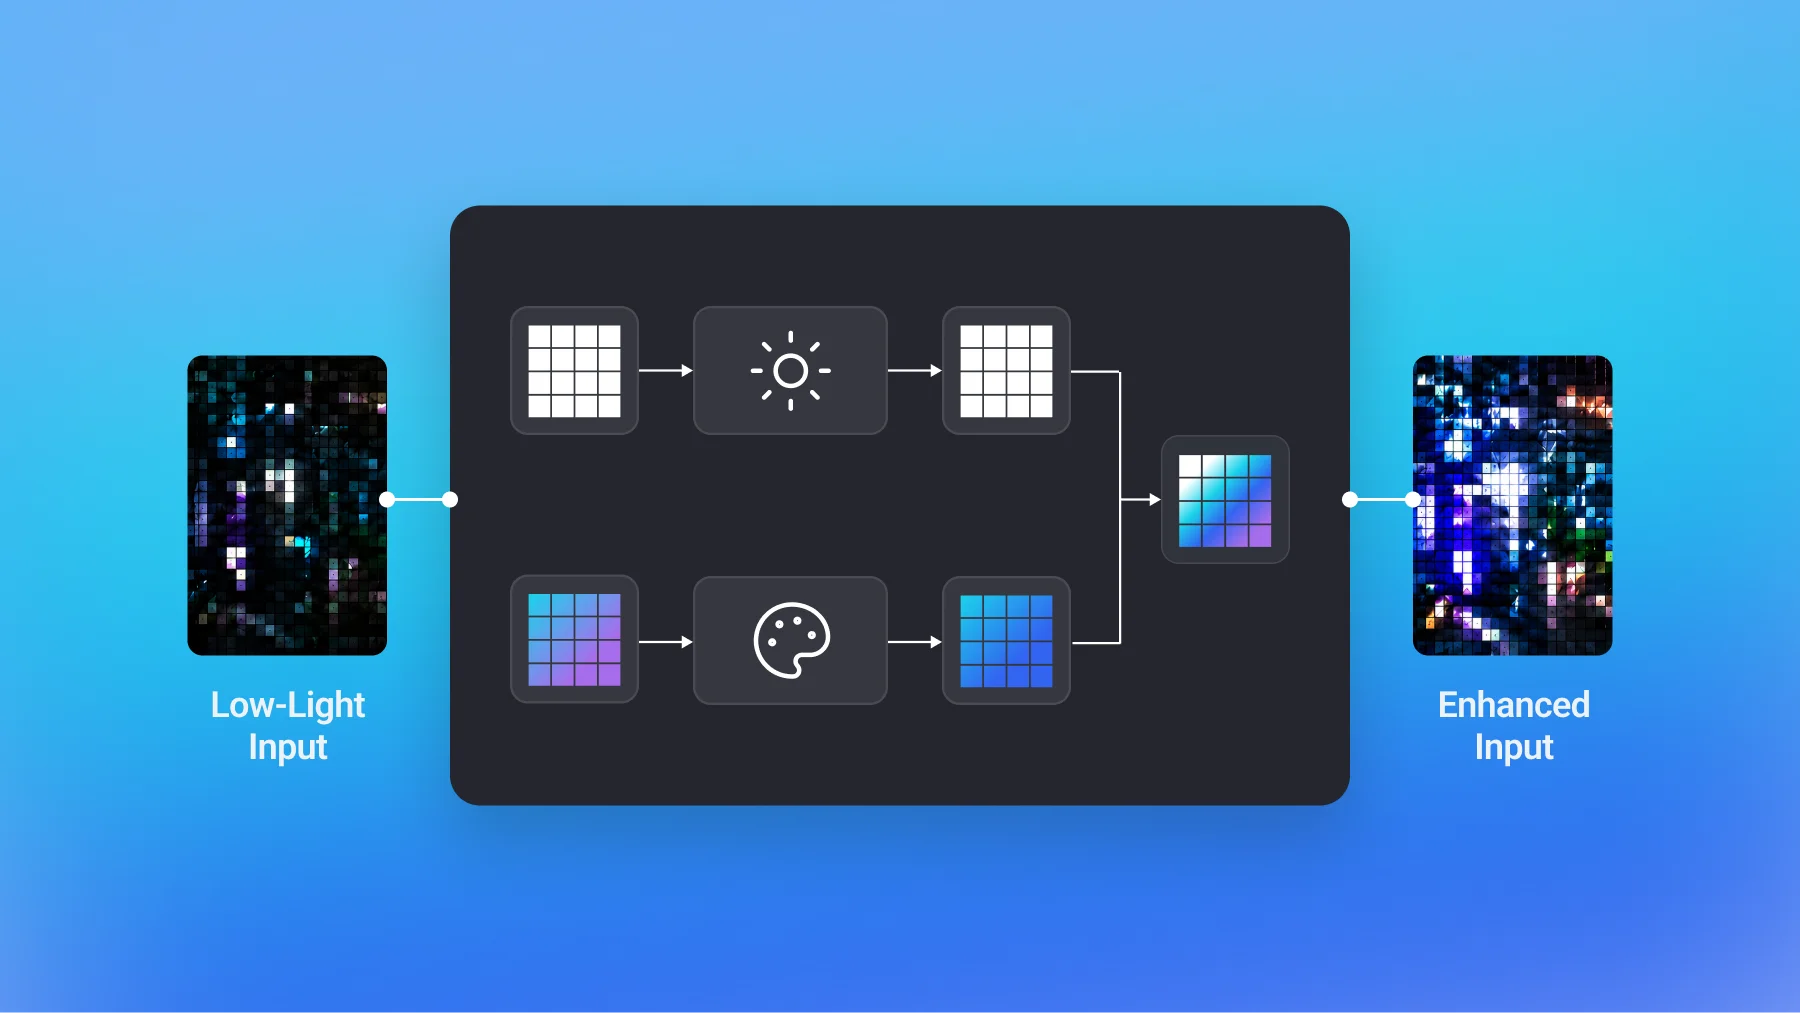
모델 설계부터 최적화까지: 풀스택으로 해결한 Jetson Orin NX 저조도 400 ms → 28 ms
YUV 분리와 경량 DeltaViT 설계로 Jetson Orin NX의 저조도 복원 지연 시간을 400ms에서 28ms 미만으로 단축했습니다. 비참조 화질 지표와 다채널 처리 요구를 함께 검증했습니다.
#Jetson Orin NX#TensorRT
000
YUV 분리와 경량 DeltaViT 설계로 Jetson Orin NX의 저조도 복원 지연 시간을 400ms에서 28ms 미만으로 단축했습니다. 비참조 화질 지표와 다채널 처리 요구를 함께 검증했습니다.

배송 완료 사진 임베딩의 거리 비교로 오배송을 탐지하는 장소 재인식 시스템을 구축했습니다. ONNX 기반 온디바이스 추론과 배치 임베딩 적재로 실시간성과 운영 효율을 확보했습니다.
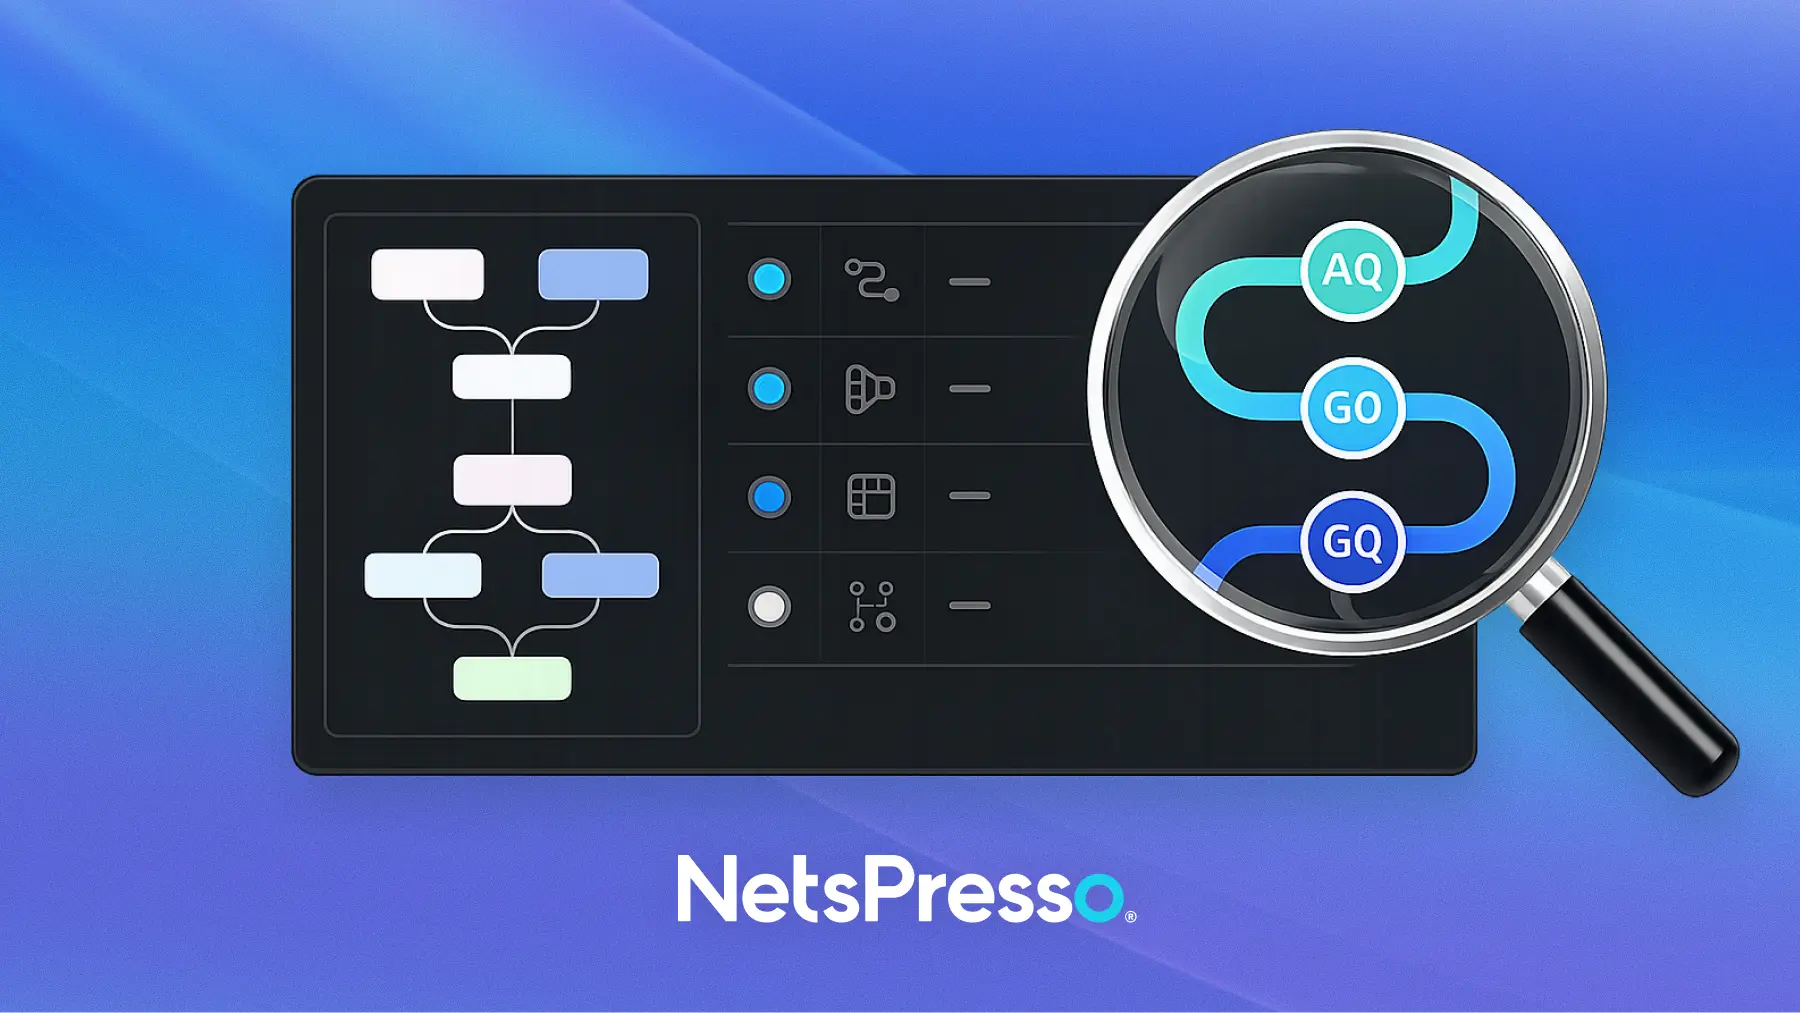
넷츠프레소의 AQ·GO·GQ 기반 모델 배포 파이프라인 구조를 설명했습니다. 양자화부터 그래프 최적화·온디바이스 검증까지의 흐름을 다뤘습니다.
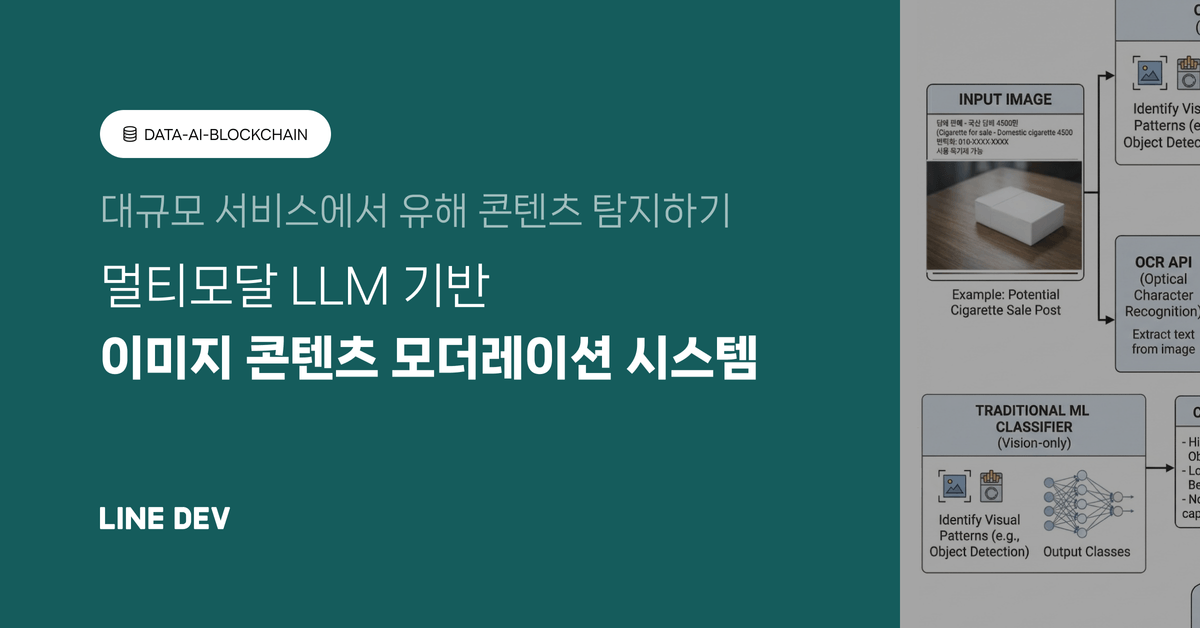
대규모 서비스의 이미지 콘텐츠 모더레이션을 위해 멀티모달 LLM과 전통적 ML을 결합한 구조를 소개했습니다. 정확도, 지연 시간, 비용, 정책 유연성을 함께 개선하는 최적화 과정을 다뤘습니다.


Kubernetes에 GPU 기반 Triton 추론 서버를 구축해 시맨틱 검색을 실시간으로 처리한 사례를 정리했습니다. ONNX 최적화와 배치·모니터링·배포 자동화로 성능과 운영 효율을 높였습니다.

리오(RIO) 명함 촬영 인식을 모바일 기기에서 동작시키기 위해 모델 변환과 안드로이드 적용 과정을 정리했습니다. PyTorch를 TF Lite로 옮기고, JNI와 OpenCV로 후처리를 구성한 실험 내용을 공유했습니다.
실외 자율주행 로봇에서는 서버용 ML 모델을 그대로 쓰기 어려워 경량화가 필요했습니다. 이 글은 PTQ와 TensorRT 기반 최적화, ONNX 변환 흐름을 설명했습니다.
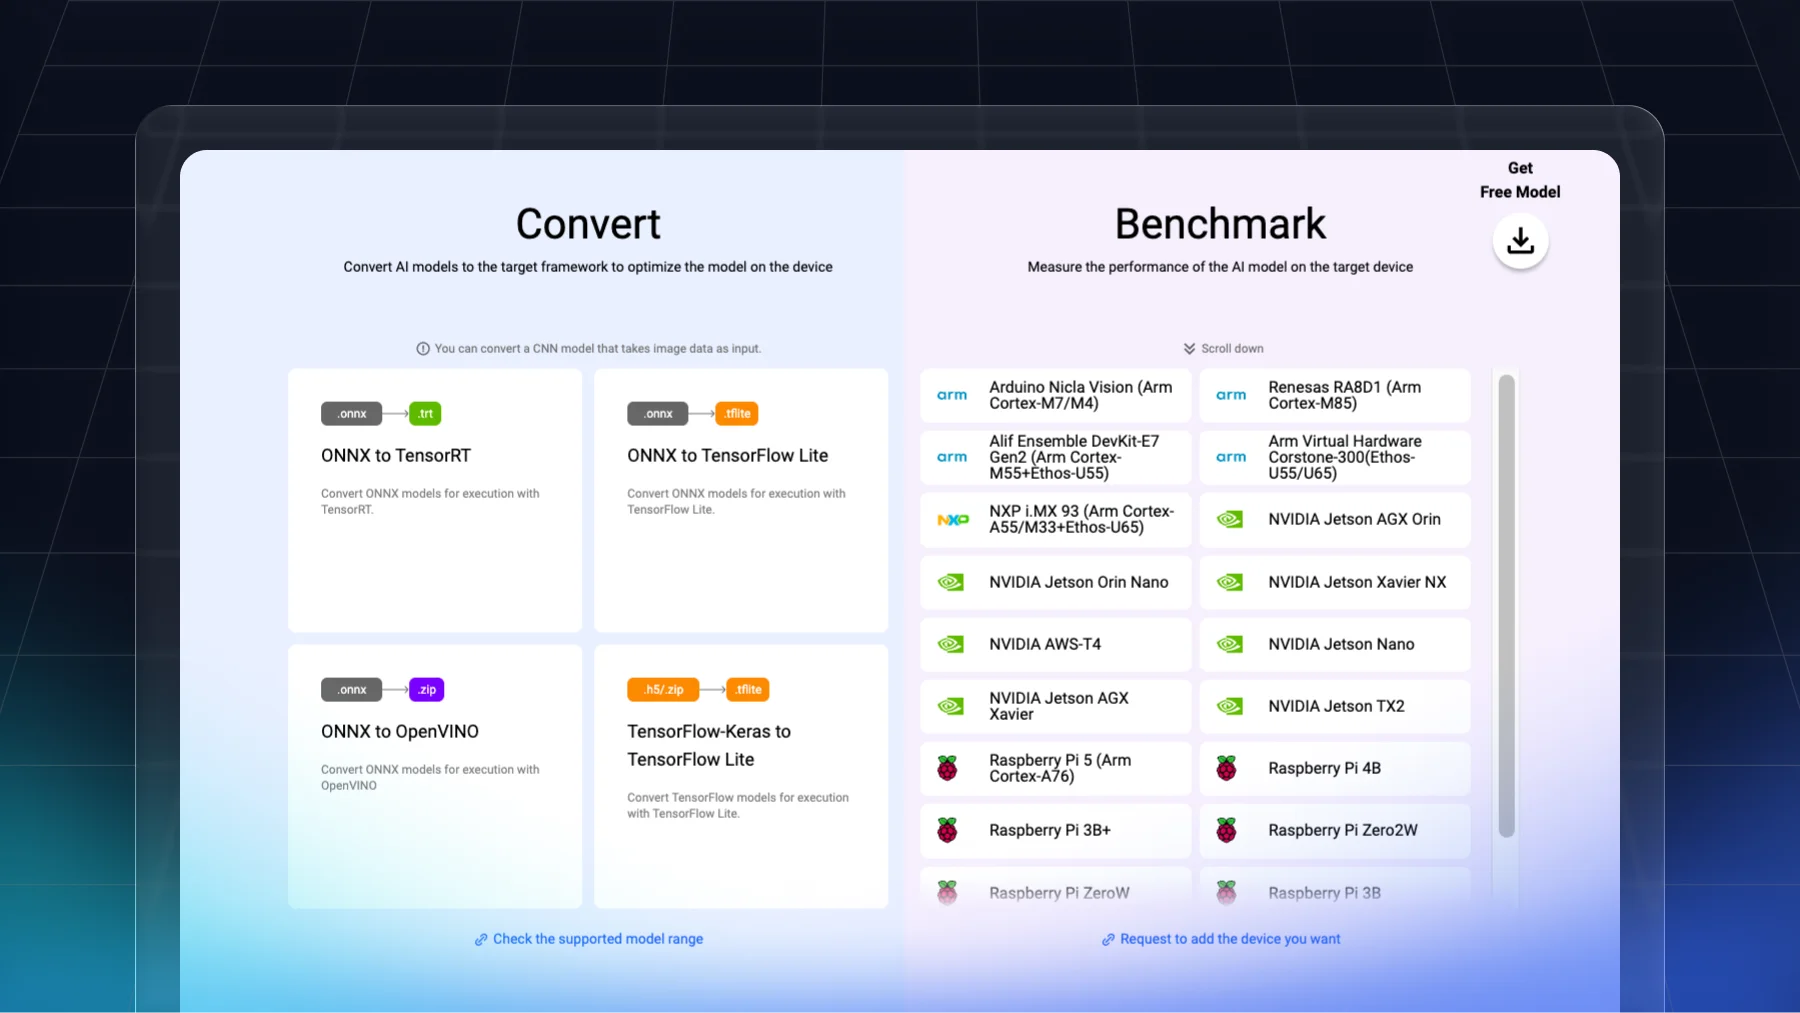
TAO Toolkit 모델을 ONNX로 내보내 LaunchX와 연동하는 과정을 소개했습니다. PyNetsPresso로 여러 엣지 장치의 변환 및 벤치마크를 확인합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
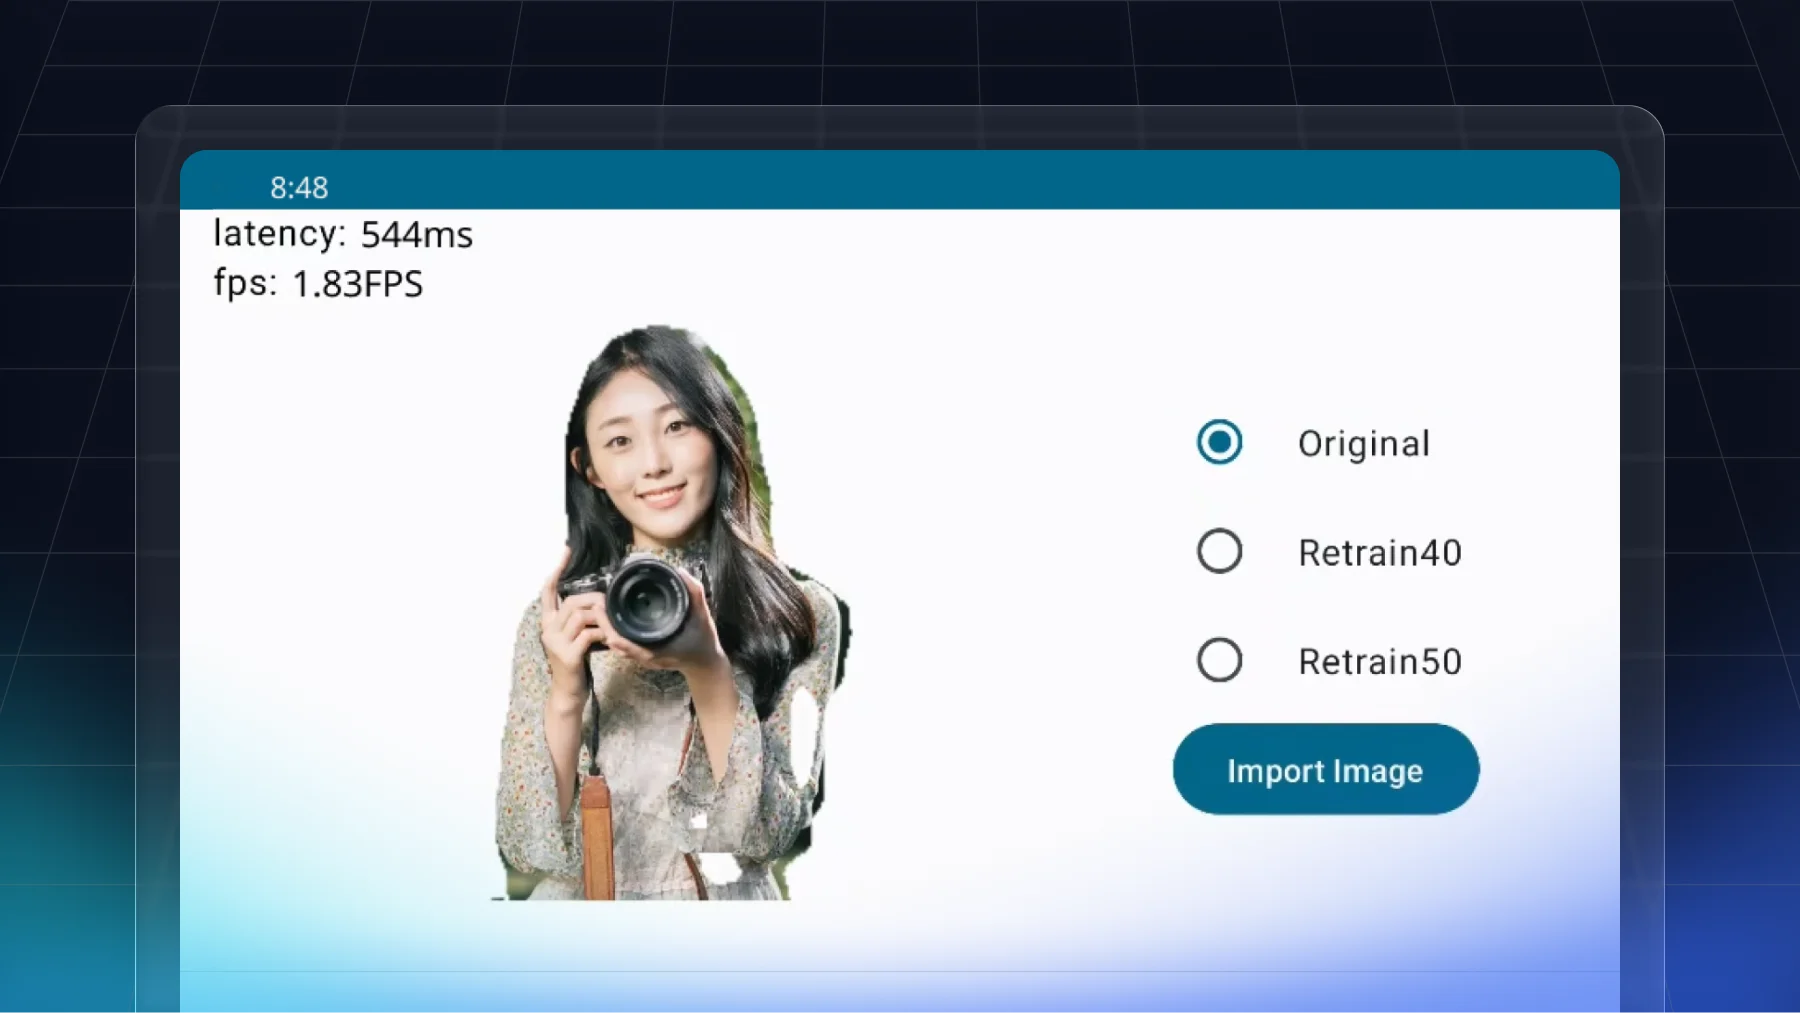
모바일 환경에서 PIDNet 의미론적 분할 모델의 실시간 처리 지연 문제를 다뤘습니다. NetsPresso 구조적 가지치기로 압축률별 정확도와 지연 시간의 균형을 비교했습니다.