



VPC 내 프라이빗 서비스에 AWS DevOps Agent를 안전하게 연결하기
AWS DevOps Agent를 VPC 내부 서비스에 안전하게 연결하는 프라이빗 연결 설정 방법을 설명했습니다. 콘솔과 CLI 절차, DNS 해석, Grafana 연동과 운영 주의점까지 함께 정리했습니다.
#AWS DevOps Agent#VPC Lattice
1100
새로운 기술 블로그가 추가되었어요
AWS DevOps Agent를 VPC 내부 서비스에 안전하게 연결하는 프라이빗 연결 설정 방법을 설명했습니다. 콘솔과 CLI 절차, DNS 해석, Grafana 연동과 운영 주의점까지 함께 정리했습니다.

OpenTelemetry와 ClickHouse로 APM 스캐터 차트를 만들고 Grafana 커스텀 패널로 10만 점 산점도를 그린 사례를 다뤘습니다. 구현 후 드러난 함정 3가지와 대용량 시각화 시 점검 포인트를 정리했습니다.


Cloud Native 운영에서는 모니터링만으로 원인을 찾기 어려워 Observability와 데이터 연결이 중요합니다. kt cloud는 AI가 활용할 수 있는 운영 데이터와 접근 통제 구조를 함께 설계했습니다.
n8n Queue Mode에서 worker만 늘려도 처리량이 오르지 않는 이유를 k6 부하테스트로 검증했습니다. 실제 병목은 worker가 아니라 task runner 한도였고, 두 값을 함께 조정해야 했습니다.

LLM 서빙에서는 단순히 모델을 띄우는 것보다, 지표를 잘 설계하고 원인을 빠르게 추적하는 운영이 중요했습니다. Prefix Cache, finish_reason, KV Cache 같은 신호를 활용해 타임아웃과 처리량 문제를 해결했습니다.

kt cloud가 Observability Alert 플랫폼을 구축한 사례를 정리했습니다. 조직별 격리, 통합관제 연계, 이력 관리를 위한 설계와 운영 포인트를 다뤘습니다.
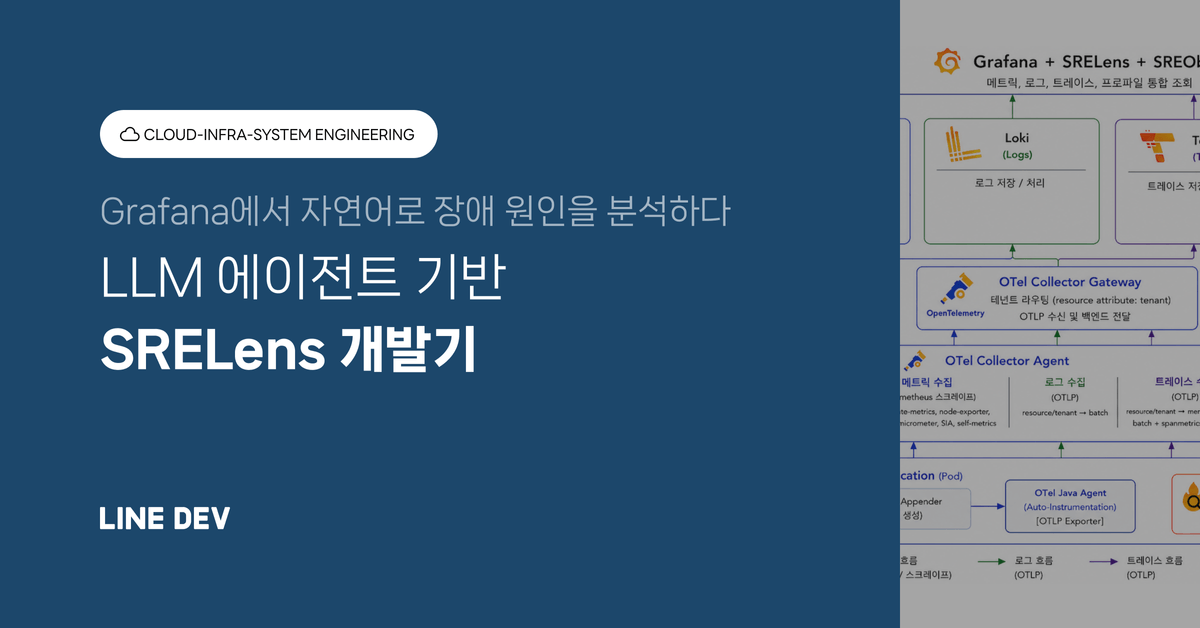
Grafana에서 자연어로 장애 원인을 찾는 SRELens 개발 사례를 소개했습니다.\nLLM 에이전트를 운영 환경에 맞게 제어하기 위해 프롬프트 레이어 분리와 도구 호출 가드레일을 설계했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
AWS Bedrock 기반 LLM 비용이 증가하자 API별 토큰 메트릭을 먼저 구축해 원인을 파악했습니다. 이후 Prompt Caching을 적용해 캐시 히트율 98%, 전체 비용 64% 절감을 달성했습니다.
Alert 생성과 전달, 대응 흐름을 IaC와 표준화된 Slack 메시지로 정리한 개선 과정을 소개했습니다. 반복 Alert 재사용, grouped Alert, AI 연동, 모니터링 자체 감시까지 운영 개선을 다뤘습니다.
Slack 봇 창식이를 통해 하네스 엔지니어링과 컨텍스트/피드백 루프 설계를 실제 운영에 적용한 사례를 정리했습니다. MCP 채널, 지식 베이스, 교정 로그로 장기 작업의 정확도를 높인 구성이 핵심입니다.
Kubernetes Pod의 Request와 Limit을 실제 사용 패턴에 맞게 조정하는 Right-Sizing 기준 수립 과정을 다뤘습니다. P95, 버퍼율, 컴포넌트 특성, Throttling 지표를 함께 고려하는 방법을 정리했습니다.

StarRocks에서 Resource Group으로 멀티테넌트 워크로드를 분류하고 CPU 우선순위를 조절한 운영 경험을 정리했습니다. 서비스 SLA가 필요한 경우에는 exclusive_cpu_cores와 주의점을 함께 적용했습니다.
SLI/SLO 도입 과정을 공통 프레임워크로 정리하고 사내 템플릿으로 확산한 사례를 소개했습니다. 또한 웹훅과 DB 기반으로 자동 갱신되는 서비스 상태 확인 도구 LINE Status를 만든 과정을 공유했습니다.
Claude Code로 Slack·VS Code·Jupyter를 묶어 맥락이 이어지는 AI 비서를 설계하고 실무 자동화 사례를 소개했습니다. 개인 워크스페이스를 조직 자산으로 확장하는 방향과 AI를 대하는 실용주의도 함께 정리했습니다.