

Spark 2편 – Caching 및 Persist
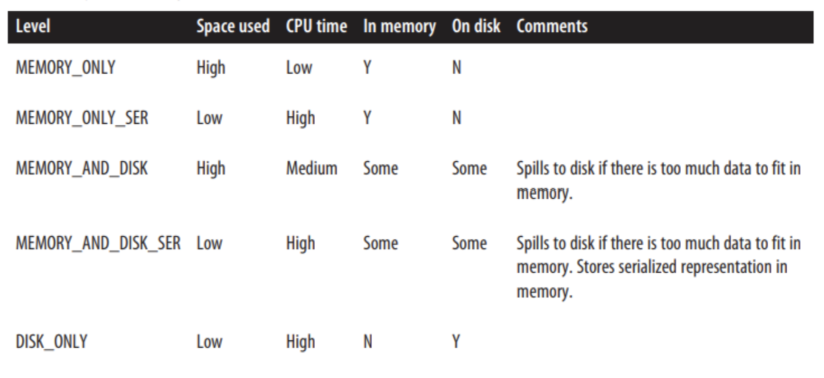
Spark의 Cache와 Persist 개념과 사용 시 주의점을 설명했습니다. 메모리 부족으로 인한 spill over를 줄이는 대응 방법도 소개했습니다.
#Spark#cache
4300
새로운 기술 블로그가 추가되었어요
Spark의 Cache와 Persist 개념과 사용 시 주의점을 설명했습니다. 메모리 부족으로 인한 spill over를 줄이는 대응 방법도 소개했습니다.
데이터 사일로와 빅데이터 검색 혁신을 다루는 글입니다. 다만 본문이 Cloudflare 오류로 중간에 끊겨 상세 내용은 확인되지 않았습니다.


Redis 클라이언트 캐시의 최신성 문제를 해결하기 위한 Client Caching 동작 방식을 설명했습니다. Invalidation 메시지로 로컬 캐시를 동기화하는 예제와 적용 흐름도 함께 다뤘습니다.

모바일 라이브 게임에서 어드레서블과 S3를 이용한 에셋 패치 시스템 구상을 정리했습니다. 앱 용량과 심사 부담을 줄이기 위한 원격 배포 전략을 살펴보았지만, 실제 적용은 중단했습니다.

AOP와 Redis로 실시간 에러 알림 시스템을 구축한 사례를 다루었습니다. 기존 배치 기반 알림의 한계를 줄이고 장애 대응성과 중복 알림 제어를 개선했습니다.


Amazon ElastiCache가 Valkey 8.0을 지원하며 더 빠른 스케일링과 개선된 메모리 효율을 제공했습니다. 서버리스 확장 속도와 노드 기반 클러스터의 메모리 사용량이 모두 개선되었습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

피처 플래그를 개발하며 배포와 장애 대응을 위한 운영 문제를 다뤘습니다. 실시간 데이터 동기화 과정에서 마주한 이슈 해결 여정을 공유했습니다.

외부 저장소 값과 enum 선언을 `name`이나 `ordinal`로 직접 묶으면 리팩토링 때 외부 계약까지 깨질 수 있습니다. 별도 매핑값과 변환 계층으로 외부 값과 내부 정의를 분리하는 방법을 소개했습니다.


행안부 API와 축적 주소 데이터를 결합해 외부 주소정제 호출과 비용을 크게 줄였습니다. 다만 API 장애와 데이터 범위 한계로 장기 내재화 전략은 재검토했습니다.

외부 API 장애를 계기로 전국 건물 DB를 구축하고 일 단위 자동 동기화 체계를 마련했습니다. 건물관리번호 기반 캐시로 OMS 배송권역 관리도 단순화했습니다.

복합건물 상세주소의 자유 입력과 건물 DB 불일치를 정확도 레벨로 체계화했습니다. 인접 단지 탐색과 전처리로 동 추출률을 높이고 외부 API 호출을 줄였습니다.
외부업체 호출을 줄이기 위해 행안부 API와 축적 데이터를 활용한 주소정제 1.0을 운영에 올렸습니다. 그러나 행안부 API 지연으로 장애가 발생해 핫픽스로 완화했고, 장기 해법은 아니라고 재평가했습니다.
행안부 네비게이션용 DB를 활용해 전국 건물 DB를 내재화한 과정을 설명했습니다. 일단위 자동 동기화와 건물관리번호 기반 개선으로 운영 시너지를 얻었습니다.

분산 환경에서 로컬 캐시와 Redis Pub/Sub을 함께 사용해 조회 성능을 높이고 데이터 정합성을 맞추는 방법을 설명했습니다. 서버별 캐시 불일치와 오래된 데이터 문제를 줄이기 위한 설계와 구현 경험을 공유했습니다.