

리뷰 서비스 품질 개선
리뷰 기능의 입력값 검증과 이미지 업로드 검증을 강화해 품질을 개선했습니다. 프론트엔드와 백엔드 이중 검증과 데이터 정합성 관리로 운영 안정성을 높였습니다.
#MIME 타입#XSS
4700
리뷰 기능의 입력값 검증과 이미지 업로드 검증을 강화해 품질을 개선했습니다. 프론트엔드와 백엔드 이중 검증과 데이터 정합성 관리로 운영 안정성을 높였습니다.


AI 데이터센터에서 WUE가 왜 중요한지와 수자원 효율 관리 방향을 정리했습니다. 전력 효율뿐 아니라 물 사용까지 함께 통제하는 운영이 핵심임을 설명했습니다.
의료 전자기록 데이터는 전처리와 평가 기준이 복잡해 모델 재현성이 낮았습니다. Clairvoyance는 이를 표준화하는 파이프라인 툴로 개발·평가·최적화를 돕습니다.
EHR 데이터를 활용한 의료 AI 모델 개발 파이프라인을 5단계로 정리한 글입니다. 임상 적용을 위해 전처리, 보정, 일반화 평가까지 함께 고려해야 함을 소개했습니다.

13년간 누적된 운영 흔적을 분류해 stage 환경을 새로 구축했습니다. Packer와 CodeDeploy, AI 분석을 결합해 운영에 가까운 검증 구조를 만들었습니다.
13년간 쌓인 운영 흔적을 분리해 검증 가능한 stage 환경을 구축했습니다. 운영에 가까운 조건에서 배포와 변경을 안전하게 확인하도록 재구성했습니다.


Amazon Bedrock 모델을 promptfoo로 비교 평가하는 방법을 소개했습니다. 프롬프트와 모델 변경 시 품질을 회귀 테스트처럼 검증할 수 있는 흐름을 설명했습니다.

Proxmox VE와 Pulumi로 ControlPlane 가상화와 IaC 기반 운영 자동화를 구현한 사례를 다뤘습니다. 변경 적용은 승인 게이트로 분리해 안전성과 재현성을 높였습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

AI로 개인의 생산성은 빨라졌지만 팀의 진척으로 이어지려면 흡수 역량이 필요하다고 설명했습니다. 판단 가능성, 추적 가능성, 복구 가능성을 기준으로 팀의 수용 구조를 점검해야 한다고 정리했습니다.

MongoDB Online Archive 도입 과정에서 저장 비용뿐 아니라 조회 비용과 탐색 전략까지 함께 재설계했습니다. OFFSET 기반 조회를 Cursor 기반 순차 조회로 바꿔 비용과 메모리 사용량을 줄였습니다.
딥러닝의 블랙박스 한계를 설명하며 의료 분야에서 해석가능한 인공지능의 필요성을 정리했습니다. 또한 AITRICS-VC의 해석 기능과 멀티모달 확장 방향을 소개했습니다.
패혈증은 초기 증상이 비특이적이고 검사 결과도 늦어 조기 판단이 어렵습니다. AI 기반 사전 예측이 기존 위험도 평가 도구의 한계를 보완할 수 있습니다.

Oracle Database@AWS의 네트워크 구성과 연결 옵션, TGW 허브앤스포크 설계를 정리했습니다. 엔터프라이즈 환경에서 DNS, CIDR, AZ 정렬 같은 핵심 주의사항도 함께 안내했습니다.
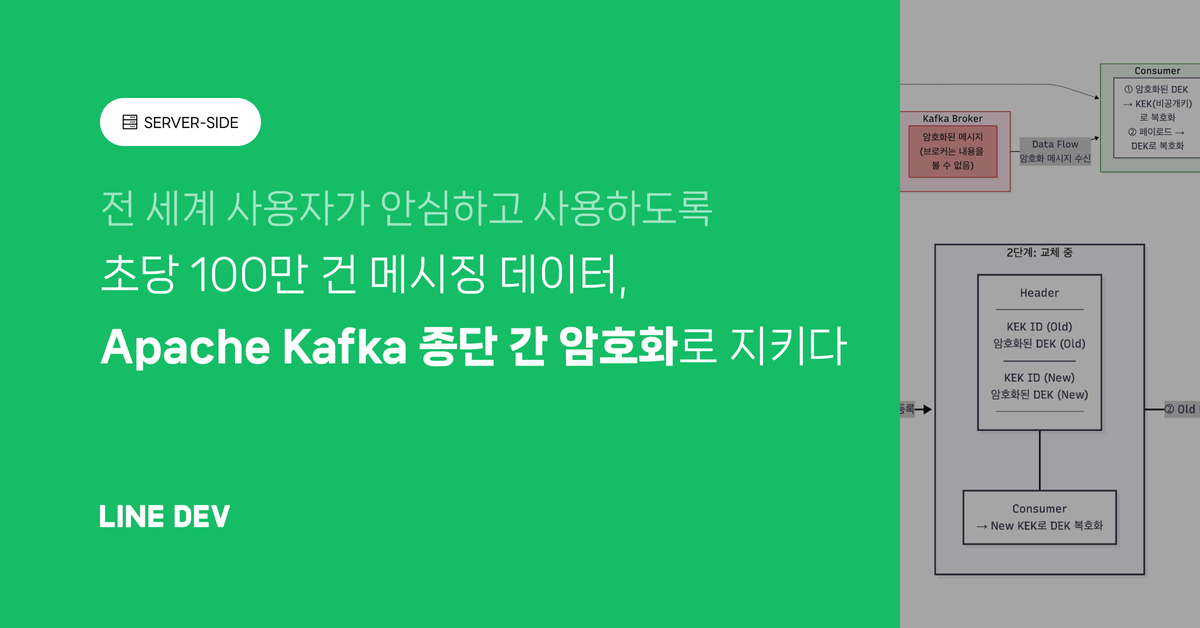
LINE 메신저의 대규모 Kafka 토픽에 종단 간 암호화를 적용한 설계와 운영 경험을 공유했습니다. 공유 KEK, 평문 폴백, 점진적 배포로 무중단 전환과 낮은 성능 오버헤드를 달성했습니다.