


Feed-Entity: 당근 피드의 심장
당근은 피드 콘텐츠를 Feed-Entity로 표준화해 여러 서비스의 데이터를 한 구조로 관리했습니다. 수집·변환·검증·서빙을 모듈화하고 지역별 캐시로 읽기 성능과 확장성을 높였습니다.
#Redis#cache
22500
새로운 기술 블로그가 추가되었어요
당근은 피드 콘텐츠를 Feed-Entity로 표준화해 여러 서비스의 데이터를 한 구조로 관리했습니다. 수집·변환·검증·서빙을 모듈화하고 지역별 캐시로 읽기 성능과 확장성을 높였습니다.

Python의 기본 개념과 특징, 장점을 소개한 글이었습니다. 여러 기업의 활용 사례를 통해 실무 적용 가능성도 함께 설명했습니다.

자체 제작 데이터베이스 Luft의 탄력성을 높이기 위해 쿼리 히스토리를 활용한 비용 기반 오토스케일러 구현 경험을 공유했습니다. 데이터베이스 스케일링 판단에 히스토리 데이터를 활용하는 접근을 다뤘습니다.
AWS re:Invent 2024 현장 참가 후기와 주요 기술 업데이트를 정리했습니다. 참석 준비 팁, 네트워킹 경험, 클라우드·AI·DB 세션 인사이트를 함께 담았습니다.
호텔 검색의 언어 장벽과 POI 매칭 한계를 개선한 사례를 다루었습니다. 다국어 음차·번역, Dense Retrieval, Place sLLM으로 커버리지와 검색 품질을 높였습니다.

자체 제작 데이터베이스 Luft의 탄력성을 높이기 위해 shared nothing에서 shared storage로 전환한 경험을 공유했습니다. 구조 변경을 통해 확장성 개선 방향을 다뤘습니다.
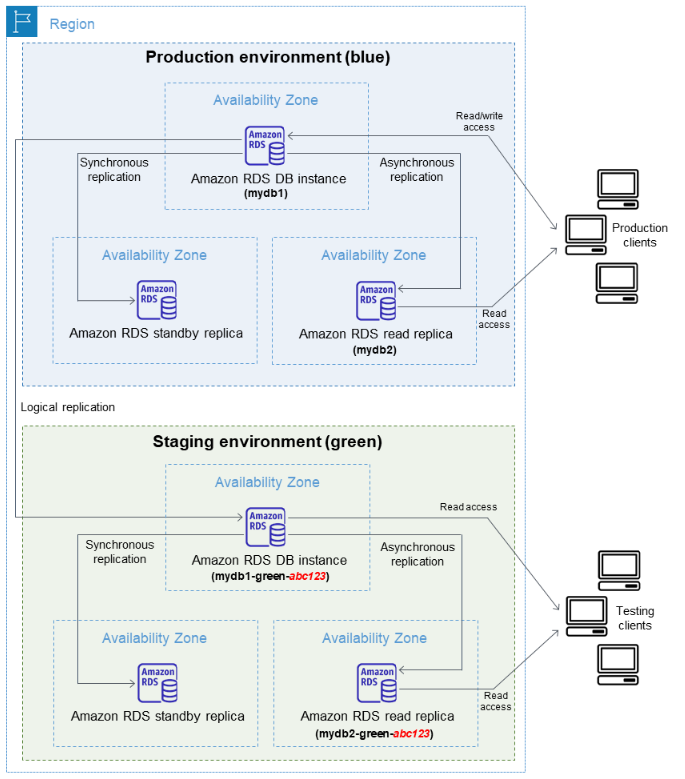
Amazon RDS Blue/Green 배포의 개념, 장점, 절차를 정리했습니다.\n다운타임을 줄이면서 안전하게 DB를 업그레이드하는 방법을 설명했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

배달의민족은 GPT와 RAG를 활용해 상품 카탈로그 속성값 생성 자동화를 시도했습니다. 평가 모델을 보완해 작업 효율을 높이고 정확도도 개선했습니다.
SmartThings 기록 시스템의 DB를 HBase에서 OpenSearch로 교체한 사례를 소개했습니다. 성능 개선과 비용 절감을 목표로 전환을 진행했습니다.

데이터카탈로그를 통해 데이터 디스커버리를 검색, 미리보기, 리니지의 3단계로 풀어낸 사례를 소개했습니다. 데이터 찾기뿐 아니라 이해와 신뢰 확보까지 연결하는 방향을 제시했습니다.

산업 현장에 맞는 Vertical AI 에이전트 구현 방식과 설계 원칙을 소개했습니다. Agent Flow와 Autonomous Agent를 조합해 예측 가능한 문제와 예외 상황을 함께 다뤘습니다.

외부 저장소 값과 enum 선언을 `name`이나 `ordinal`로 직접 묶으면 리팩토링 때 외부 계약까지 깨질 수 있습니다. 별도 매핑값과 변환 계층으로 외부 값과 내부 정의를 분리하는 방법을 소개했습니다.

JPA `Transactional`과 DB 쿼리 성능의 관계를 설명하는 글입니다. 트랜잭션 적용 방식에 따라 쿼리 특성과 성능 영향이 달라질 수 있음을 다룹니다.
웹호스팅 이전 대행의 진행 절차와 사전 확인 사항을 정리했습니다. 지원 사양, 백업 파일, 네임서버 변경 시 유의점을 함께 안내했습니다.