

Skia Python 적용기

Skia Python 적용기
Skia를 Python에 바인딩한 SIPSkia로 ImageMagick 기반 카드 변환을 교체했습니다. 평균 4배 성능과 이미지 변환 서버 CPU 사용률 30~40% 감소를 확인했습니다.
#Python#Flask
1700
새로운 기술 블로그가 추가되었어요
Skia를 Python에 바인딩한 SIPSkia로 ImageMagick 기반 카드 변환을 교체했습니다. 평균 4배 성능과 이미지 변환 서버 CPU 사용률 30~40% 감소를 확인했습니다.
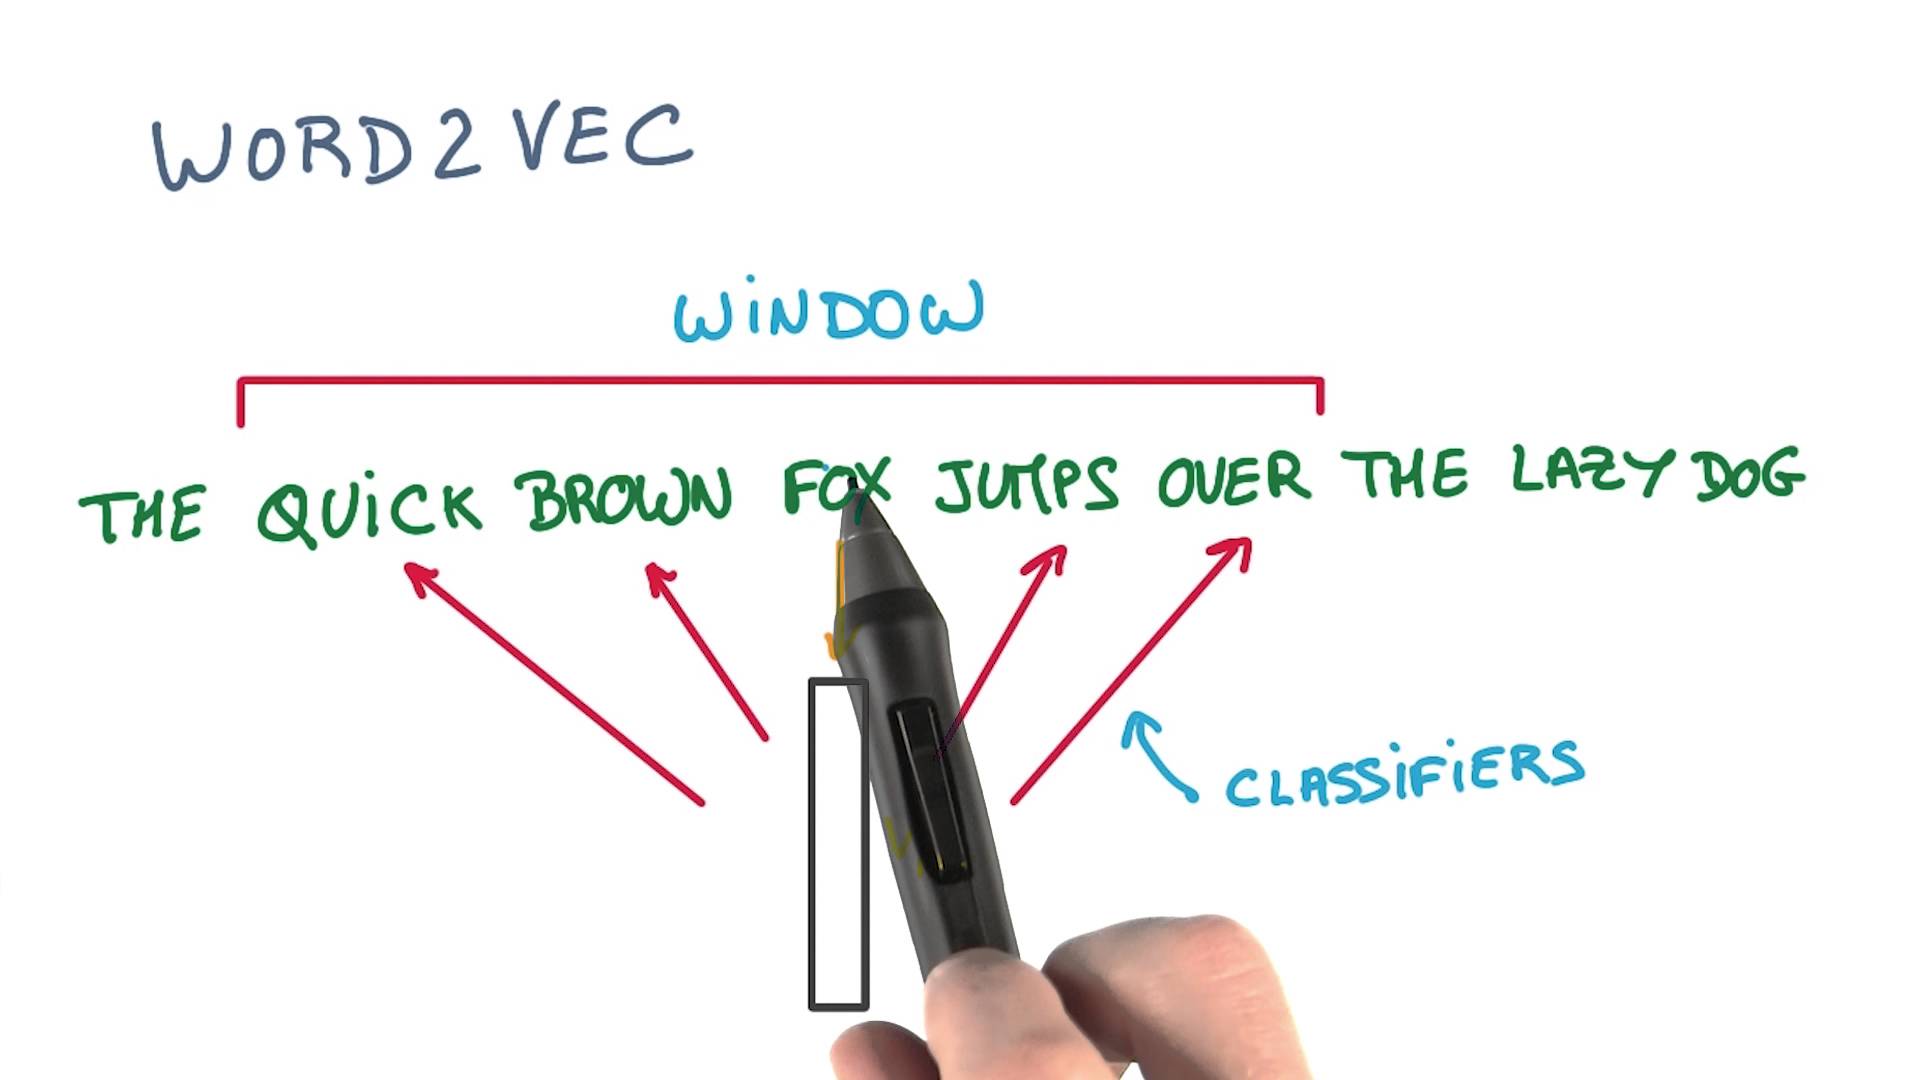
허니스크린의 콘텐츠 추천 품질을 높이기 위한 유사 콘텐츠 분류 필요성을 다룹니다. Word2vec을 응용한 머신러닝 기반 콘텐츠 클러스터링 접근을 소개합니다.
Honeyscreen 콘텐츠를 효율적으로 분류하기 위한 word2vec 기반 클러스터링을 소개했습니다. 단어 벡터 간 거리로 의미 유사도를 측정하는 방식을 설명합니다.

포인트 히스토리와 총 포인트 테이블을 통합해 일관성 있는 스키마를 구성했습니다. 포인트 타입별 분리와 단일 테이블 방식의 장단점을 검토했습니다.


사전 생성 썸네일을 WebP 원본 기반 온디맨드 리사이징으로 전환했습니다.\nSQS·Spot Instance 마이그레이션으로 S3 비용을 70% 이상 절감했습니다.
허니스크린의 포인트 시스템은 기존 MySQL RDS로 운영했습니다. 서비스 성장에 따른 요청 급증으로 데이터베이스 부하가 커진 맥락을 다룹니다.
포인트 요청 증가로 MySQL RDS 부하가 커진 문제를 다뤘습니다. 확장성이 높은 AWS DynamoDB 기반 포인트 시스템 설계를 소개합니다.
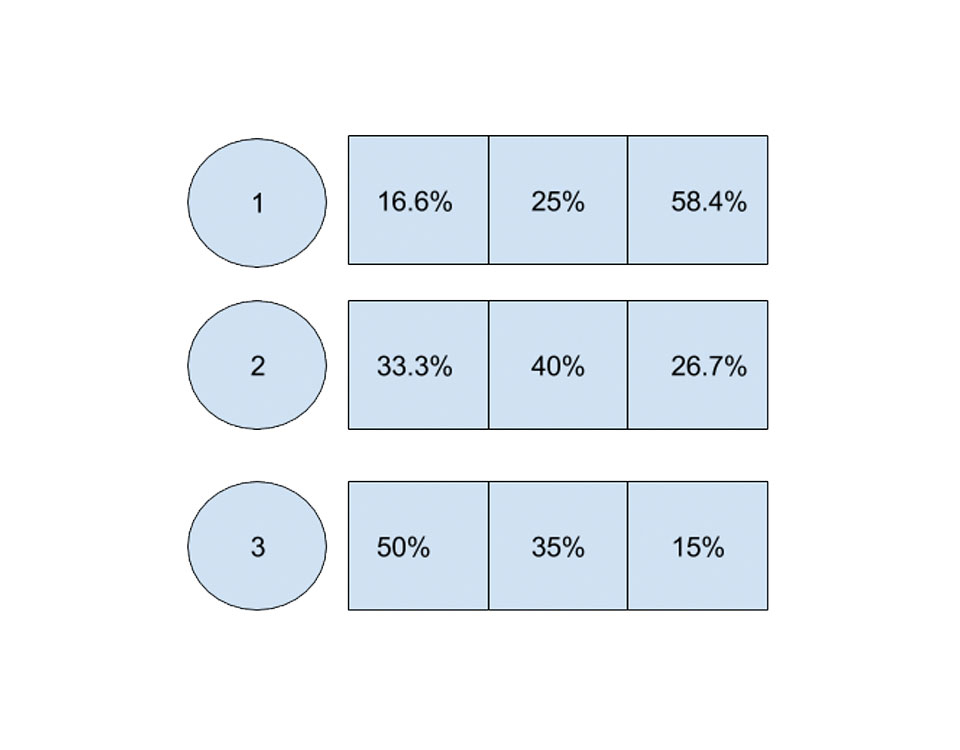
광고·콘텐츠를 점수순으로만 할당할 때 반복 노출과 콜드 스타트 편향이 발생함을 설명했습니다. 점수 기반 순위와 무작위성을 결합한 선택 방식의 필요성을 제시합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
AWS와 다중 데이터베이스를 조합한 모씨 서비스의 운영 구성을 소개했습니다. 캐시·검색·비동기 처리와 성능 제약 대응 사례를 정리했습니다.

ELB의 장기 대량 TCP 연결과 프로토콜 복잡성 문제를 해결하기 위해 프레젠터 게이트웨이를 구축했습니다. TCP 멀티플렉싱, C++ 연결 처리, Route53 가중치 라우팅으로 성능과 운영성을 확보했습니다.

소수 개발 인력으로 여러 서비스를 운영하기 위해 AWS 관리형 서비스를 폭넓게 활용했습니다. 초기 인프라에서 자동 확장·서버리스·데이터 처리 서비스까지 사용 범위를 확장했습니다.
MapReduce 중심 분석 시스템을 Spark·Zeppelin·AWS 기반으로 점진 전환했습니다. 분석 시간을 약 8시간에서 1시간으로 줄이고 관리 부담과 대시보드 운영 복잡도를 낮췄습니다.
익명 표현 공간으로서 모씨 프로젝트의 기획 배경과 알파 테스트 경험을 소개했습니다. 폰트와 위치 정보처럼 신원 추정으로 이어질 수 있는 요소를 점검했습니다.

Android Wear 앱의 알림·Micro App 구조와 모바일-Wear 간 데이터 흐름을 공유했습니다.\n기능 제약, 원형 화면, 패키징 조건을 고려한 개발 주의점을 정리했습니다.