


[케클러 인터뷰 시리즈] #5 - AI가 클라우드를 운영하려면, 데이터부터 이해해야 합니다
Cloud Native 운영에서는 모니터링만으로 원인을 찾기 어려워 Observability와 데이터 연결이 중요합니다. kt cloud는 AI가 활용할 수 있는 운영 데이터와 접근 통제 구조를 함께 설계했습니다.
#Observability#AIOps
2500
Cloud Native 운영에서는 모니터링만으로 원인을 찾기 어려워 Observability와 데이터 연결이 중요합니다. kt cloud는 AI가 활용할 수 있는 운영 데이터와 접근 통제 구조를 함께 설계했습니다.
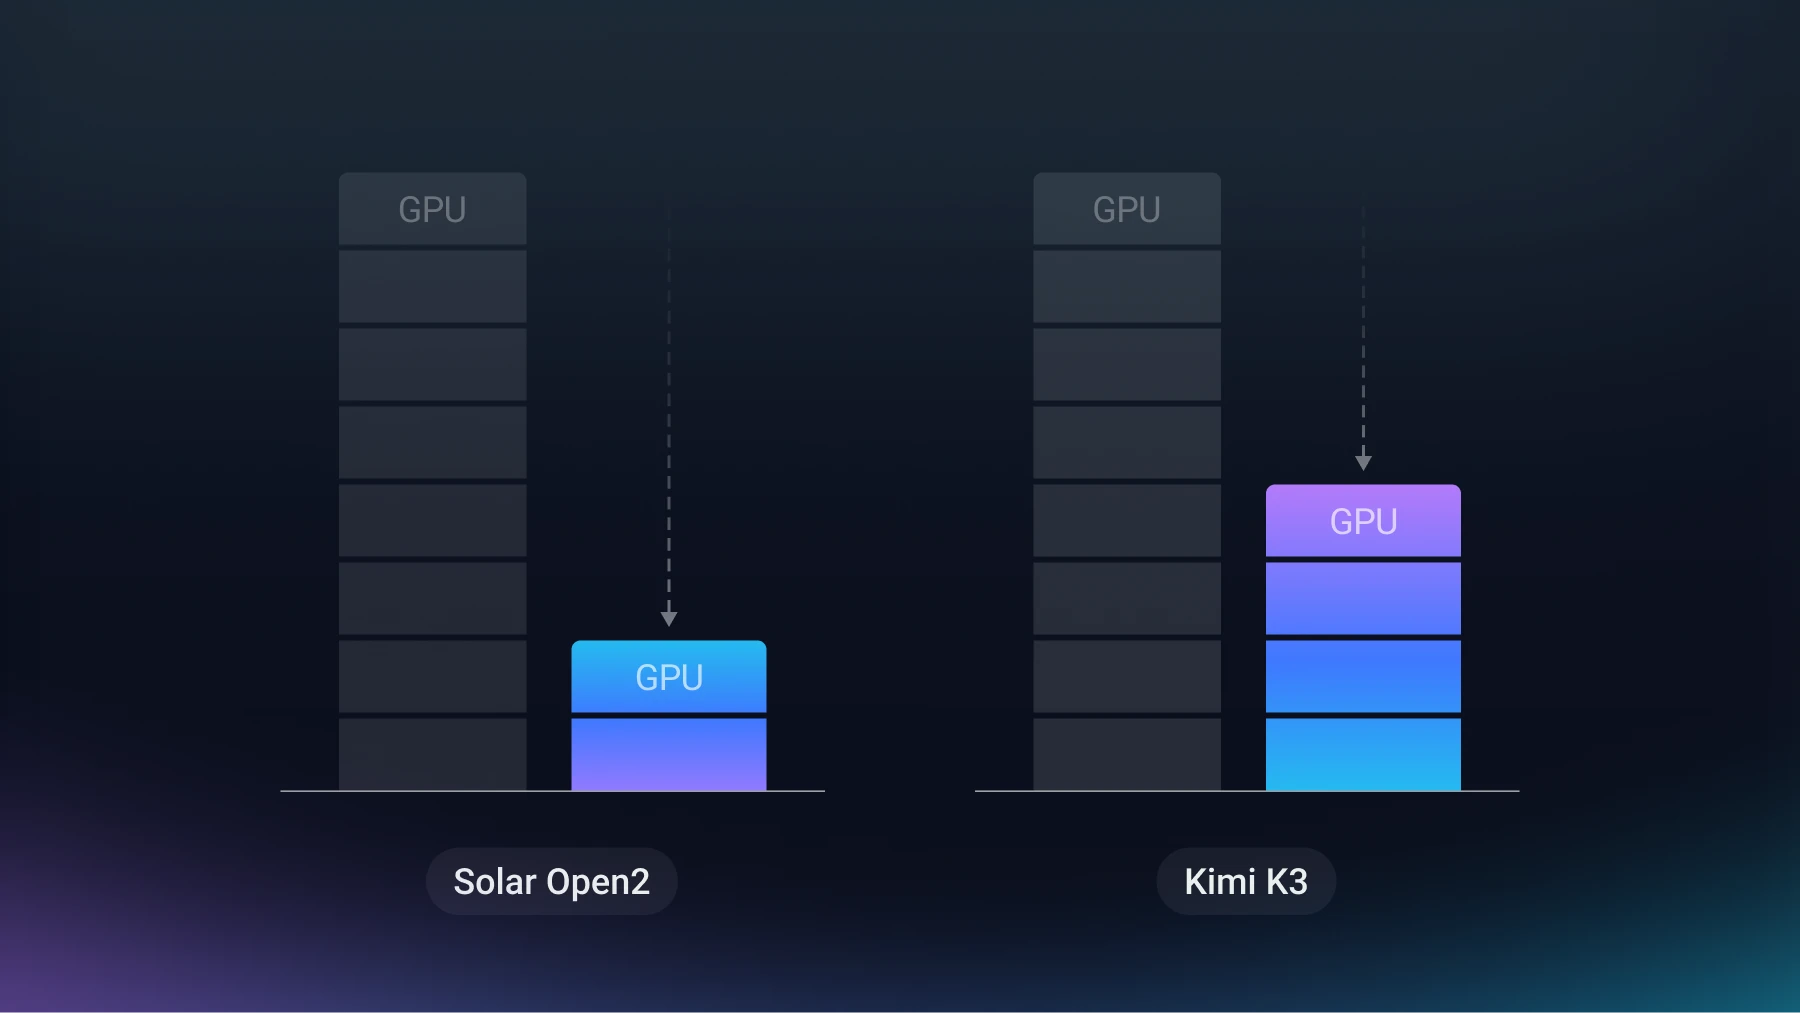
MoE 양자화와 비균일 전역 프루닝으로 LLM 가중치 메모리를 줄이는 사례를 소개했습니다. Solar Open2와 Kimi K3의 GPU 구성 축소 및 벤치마크 결과를 비교했습니다.
똑닥 AI 모더레이터의 인터뷰 에이전트 구조와 자가 발전 루프를 설명한 글입니다. 안전 규칙은 코드에 고정하고 전략만 스킬로 재합성하는 설계를 다뤘습니다.
똑닥 AI 모더레이터의 유저 인터뷰 에이전트 설계와 자가 발전 구조를 공유했습니다. 안전은 코드로 고정하고 전략은 스킬 세트로 분리해 피드백 기반 재합성을 구현했습니다.
n8n Queue Mode에서 worker만 늘려도 처리량이 오르지 않는 이유를 k6 부하테스트로 검증했습니다. 실제 병목은 worker가 아니라 task runner 한도였고, 두 값을 함께 조정해야 했습니다.
AI 네이티브 조직에서 도메인 지식을 사람과 여러 AI 에이전트가 공유하는 방법을 다룬 글입니다. 표준 기반 Core 위에 조직 특화 시맨틱 레이어를 얹는 접근을 소개합니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
AI로 SSE 구현은 빠르게 완성했지만, Qra의 운영 조건과 요구사항을 다시 보며 polling으로 회귀했습니다. 실행 속도보다 선택을 재검토하고 책임지는 Human Agency의 중요성을 강조했습니다.
빠른 프론트 개발에서도 기능 동작만 보지 말고 셀프 코드 리뷰로 예외 상황과 유지보수성을 함께 점검해야 합니다. 일정이 급할수록 변경분 기준으로 핵심 문제부터 우선 확인하는 습관이 중요합니다.


@Scheduled 기반 배치가 Pod 확장 시 중복 실행과 유실 문제를 드러내자, 트리거를 애플리케이션 밖으로 분리했습니다. 실행은 선점과 체크포인트로 나눠 맡겨 여러 Pod가 작업을 분담하도록 전환했습니다.
보안관제 티켓을 읽어 WAF 차단을 자동화한 개발기를 정리했습니다. 속도보다 오차단 방지와 fail-safe 구조를 우선해 장애 없이 운영한 사례입니다.
글로벌 상담 AI Agent의 메인 모델을 GPT-5.6 Luna로 바꾼 이유를 자체 벤치마크로 설명했습니다. 공개 리더보드보다 실제 워크로드에서의 품질, 비용, 속도를 함께 보고 전환했습니다.
AI가 디자인 시스템을 사용할 때는 규칙을 설명하는 것보다 잘못된 상태를 만들 수 없게 하는 추상화가 중요하다고 다뤘습니다. 목적별 컴포넌트 분리와 타입 계약으로 접근성과 상호작용을 시스템이 직접 소유하는 방법을 소개했습니다.

SKU별 수요 패턴을 진단해 모델과 신호를 다르게 적용하는 에이전틱 수요 예측 방식을 소개했습니다. Amazon Connect Decisions로 분류, 측정, 오케스트레이션을 자동화하는 흐름을 살펴봤습니다.

SRE 업무에 AI를 접목해 장애 원인 분석 자동화를 다룬 글입니다. 다만 본문은 접근 차단 안내만 확인되어 세부 내용은 확인되지 않았습니다.