
AOP와 MDC로 구현하는 보급형 APM - 인터페이스 이력 관리부터 호출 추적까지
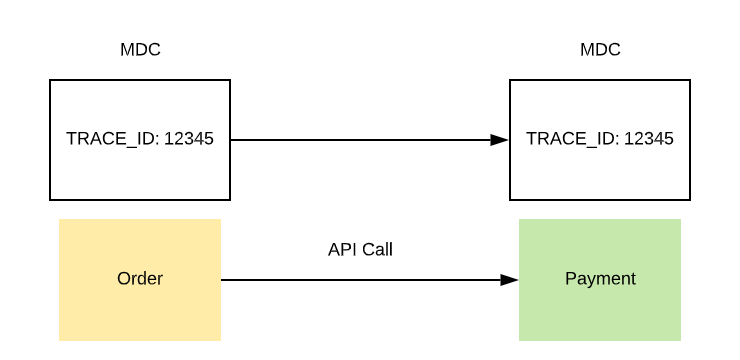
인터페이스 이력 관리 시스템을 AOP와 MDC, Kafka Interceptor로 구현한 과정을 정리했습니다. 멀티스레드 전파와 호출 스택 누락 문제를 여러 차례 개선한 시행착오를 공유했습니다.
#AOP#MDC
5500
인터페이스 이력 관리 시스템을 AOP와 MDC, Kafka Interceptor로 구현한 과정을 정리했습니다. 멀티스레드 전파와 호출 스택 누락 문제를 여러 차례 개선한 시행착오를 공유했습니다.

n8n 커뮤니티 노드를 개발하고 배포하는 과정을 단계별로 소개했습니다. 템플릿 설정부터 로컬 테스트, npm 배포, 설치 방법까지 정리했습니다.
n8n 커뮤니티 노드를 만드는 방법을 템플릿부터 로컬 테스트, npm 배포까지 단계별로 정리했습니다. 맞춤형 자동화를 위해 description, execute, package.json 설정과 설치 방법을 설명했습니다.

새로운 팀의 Scala 코드베이스와 아키텍처에 적응한 과정을 공유했습니다. 작은 기능과 디버깅을 반복하며 코드 흐름을 익히고 팀에 녹아드는 방법을 설명했습니다.

Amazon FSx for Lustre의 스토리지 옵션, 압축, S3 연동, 신규 성능 기능과 모니터링 방법을 정리했습니다. 또한 사용 방법과 제약 사항까지 함께 소개했습니다.
Amazon Bedrock의 지연 시간 최적화 추론이 LLM 응답성 개선에 어떻게 기여하는지 정리했습니다. TTFT, OTPS, E2E 지표와 함께 프롬프트·아키텍처 최적화 방법도 살펴보았습니다.
로그 누적으로 발생한 대시보드 타임아웃과 slow query 문제를 Trino 도입으로 개선한 사례를 다뤘습니다. OBS와 Parquet, MySQL tier down 구조를 통해 집계 성능과 저장 효율을 함께 고려했습니다.

Next.js에서 Sentry를 도입해 프론트엔드 에러 모니터링을 강화한 사례를 정리했습니다. 수집 범위와 알림 기준을 조정해 중요한 오류만 선별하고 디버깅 정보를 보완했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
똑닥닷컴 커뮤니티 페이지의 검색 노출을 크게 늘린 SEO 개선 사례를 정리한 글입니다. 사이트맵, robots.txt, 메타데이터, 구조화된 데이터, Next.js SEO 트러블슈팅까지 함께 소개했습니다.
네이버와 구글 검색 노출을 높이기 위한 SEO 실무 경험을 정리했습니다. Next.js에서의 동적 사이트맵, 메타데이터 설정과 함께 색인 수 확대 방법도 소개했습니다.
식자재 품목 검색 품질을 높이기 위해 Elasticsearch를 도입하고 분석기, N-gram, Wildcard를 조정한 과정을 정리했습니다. 초성 검색은 ICU 확장을 선택해 유지보수성과 확장성을 함께 고려했습니다.
디지털트윈 기술을 사람에게 적용해보는 시도를 언리얼 엔진과 함께 소개한 글입니다. 현대자동차 디지털 공장 맥락에서 제조 디지털트윈을 재미있게 풀어보려는 배경을 담고 있습니다.
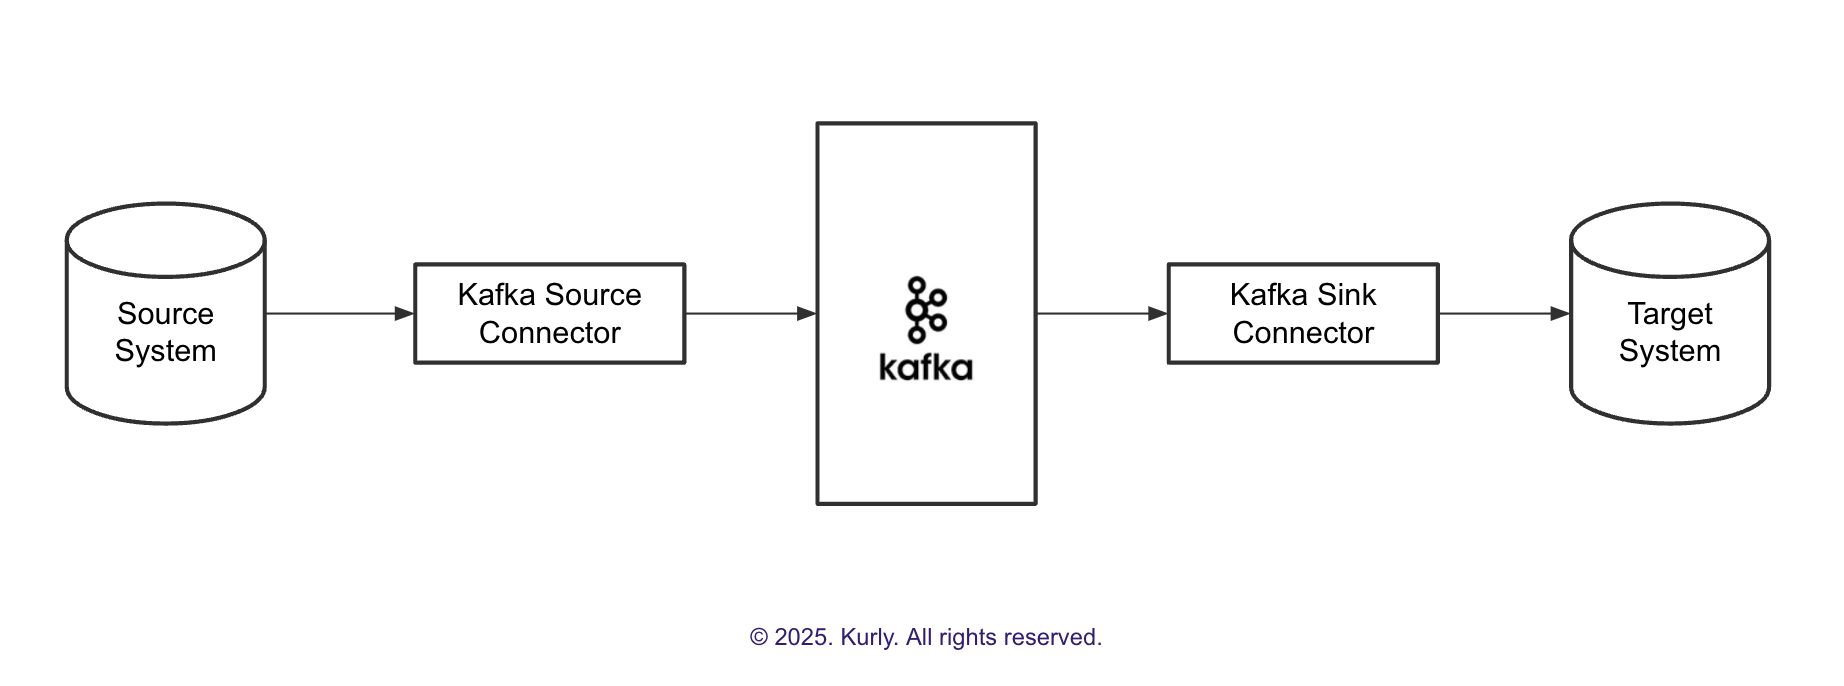
Kafka Connect와 JDBC Source Connector로 DB 데이터를 Kafka에 연동하는 구조와 증분 쿼리 모드를 설명했습니다. 쿼리 기반 CDC의 누락 사례와 지연 옵션을 통한 완화 방법을 정리했습니다.
Kafka Connect와 JDBC 소스 커넥터로 DB 데이터를 Kafka에 연동하는 방법을 설명했습니다. 쿼리 기반 CDC의 한계와 데이터 누락을 줄이는 설정도 함께 정리했습니다.