
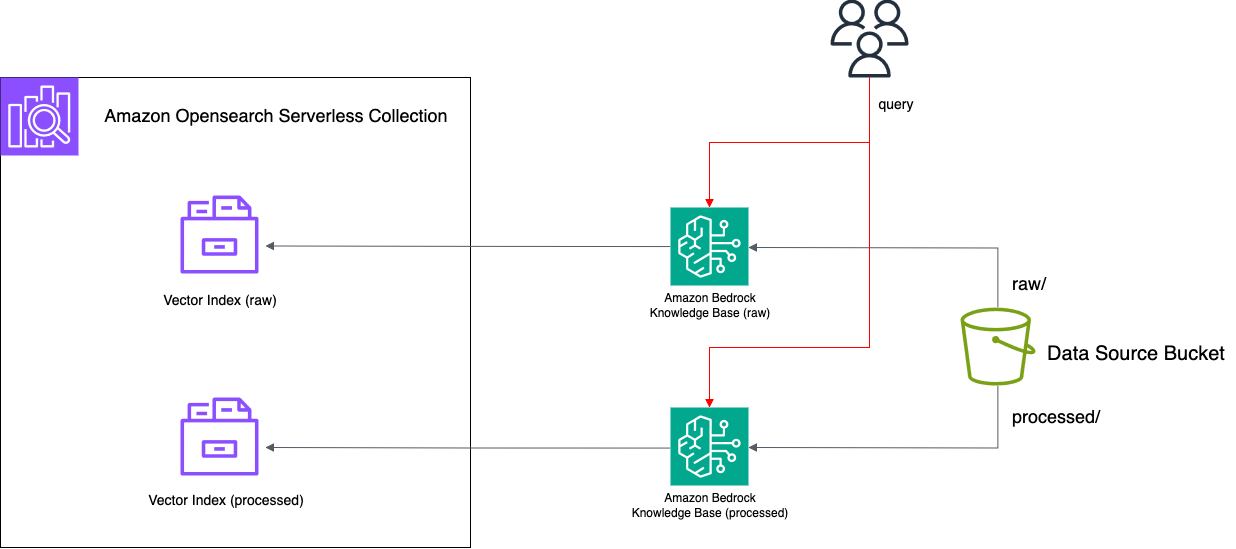

Amazon Bedrock Knowledge Bases: 데이터 특성을 고려한 분할 전략으로 검색 성능 최적화하기
FAQ 같은 짧은 구조화 데이터는 일반 청킹보다 No Chunking이 더 적합했습니다. CSV와 메타데이터를 활용해 검색 정확도와 검증 편의성을 높이는 방법을 소개했습니다.
#Amazon Bedrock#RAG
4700
FAQ 같은 짧은 구조화 데이터는 일반 청킹보다 No Chunking이 더 적합했습니다. CSV와 메타데이터를 활용해 검색 정확도와 검증 편의성을 높이는 방법을 소개했습니다.


Visual Studio Code에서 Amazon Q와 MCP, Rule을 활용해 Cursor 같은 AI 코딩 환경을 구성하는 방법을 소개했습니다. 자동 승인과 메모리 뱅크로 사용성과 정확도를 함께 높이는 흐름을 설명했습니다.
빅뱅 배포 기반 GMS 구축에서 QA가 기능, 동시성, E2E, UAT를 단계적으로 설계한 사례를 다뤘습니다. 운영 이후에는 Datadog 모니터링으로 조용한 실패까지 감시하며 안정성을 높였습니다.


Text2SQL이 왜 어려운지 명시적·암묵적 맥락, 사용자 의도, SQL 방언 차이 관점에서 정리했습니다. ERP 데이터 시각화 Agent 맥락에서 실무적으로 고려할 점도 함께 짚었습니다.

Spring Security를 보완하는 사내 확장 라이브러리 Fortel을 소개했습니다. YAML 기반 설정과 단일 필터 구조로 세션·인증·인가를 표준화했습니다.

GitHub Action과 self-hosted runner로 iOS·Android E2E 테스트 자동화 파이프라인을 POC부터 점진적으로 구축한 사례를 소개했습니다. Slack 연동, 병렬 실행, 리포트 자동화로 효율과 운영성을 높인 과정을 정리했습니다.
AI 생성 코드와 잦은 릴리즈로 보안 위험이 커지면서 DevSecOps가 기본값으로 주목받았습니다. 개발 초기부터 보안을 내재화하고 AI 기반 도구로 취약점 탐지와 대응 속도를 높이는 내용입니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
AI 생성 코드의 취약점과 보안 부채를 줄이기 위해 DevSecOps가 필수로 강조되었습니다. AI 기반 보안 도구와 휴먼 인 더 루프, 워크플로 정비가 핵심으로 제시되었습니다.
광고사업팀 인턴이 반복 운영 업무를 AI로 자동화해 월 40시간 이상의 작업을 90% 이상 줄였습니다. 자연어 기반 협업과 문제 정의를 통해 보고서 작성, 배너 검수까지 효율화했습니다.
Amazon QuickSight로 AWS 비용을 시각화하고 팀·서비스 단위 분석이 가능한 빌링 대시보드를 구축했습니다. 이를 통해 비용 증가 요인을 찾고 태그·로그·스토리지 최적화 방향을 도출했습니다.

PEP 723과 uv를 활용해 Python 스크립트를 설치 없이 즉시 실행하는 방법을 소개했습니다. Typer까지 함께 쓰면 Bash처럼 간편한 CLI 도구도 만들 수 있습니다.

양자 컴퓨터 성능을 평가하는 지표와 현실적 한계를 정리했습니다. 또한 오류 제어를 QEC, QES, QEM으로 나누어 비교했습니다.
Spring Cache와 Redis에서 record 캐싱 시 발생하는 역직렬화 오류의 원인과 해결책을 정리했습니다. Jackson의 타입 정보 처리와 GenericJackson2JsonRedisSerializer의 동작 방식까지 함께 설명했습니다.

에이닷 캘린더의 반복 일정을 iCalendar 표준과 RRULE로 구현하는 방식을 설명했습니다. EXDATE와 오버라이딩으로 취소·수정 같은 예외 처리도 다뤘습니다.