


GraphRAG Toolkit으로 지식 그래프 쿼리하기
GraphRAG Toolkit으로 지식 그래프를 쿼리하는 전략을 설명했습니다. 벡터 검색의 한계를 보완하기 위해 그래프 탐색과 retriever 선택 기준을 정리했습니다.
#GraphRAG#지식 그래프
6800
새로운 기술 블로그가 추가되었어요
GraphRAG Toolkit으로 지식 그래프를 쿼리하는 전략을 설명했습니다. 벡터 검색의 한계를 보완하기 위해 그래프 탐색과 retriever 선택 기준을 정리했습니다.
우아한공방의 문서와 코드베이스 맥락을 활용하는 RAG 챗봇 서비스를 구축한 과정을 소개했습니다. 검색 정확도 개선과 Guardrail, 스트리밍 응답, Storybook 전역 UI 적용까지 다뤘습니다.

LangGraph와 Amazon Bedrock, OpenSearch를 결합해 빅데이터 클러스터 장애 대응을 자동화했습니다. 병렬 RCA와 반증 검증으로 진단 품질을 높이고 MTTA를 줄였습니다.
Amazon OpenSearch Service로 다국어 이력서 검색 파이프라인과 인덱싱 구조를 재설계했습니다. 전처리, 정규화, 임베딩 입력 전략이 검색 정확도를 크게 좌우했습니다.

GS SHOP이 영상의 소구 포인트를 추출해 추천 신호로 바꾸고, 기존 추천 엔진과 결합한 Hybrid 시스템을 구축했습니다. A/B 테스트에서 클릭과 주문, 전환율이 모두 개선되었습니다.

GS SHOP이 영상 이해 모델과 생성형 AI를 조합해 숏픽 추천을 Hybrid 구조로 고도화했습니다. 소구 포인트 기반 임베딩으로 추천 품질과 전환 성과를 함께 개선했습니다.
한국어 SPLADE 기반 Neural Sparse 모델과 OpenSearch 하이브리드 검색을 MIRACL-ko로 벤치마크했습니다. BM25, Dense, Sparse, RRF 조합의 성능과 구현 방법을 정량적으로 정리했습니다.
Amazon Neptune GraphRAG Toolkit으로 비정형 문서를 그래프와 벡터에 함께 인덱싱하는 방법을 소개했습니다. 그래프 탐색을 더해 유사성 검색의 한계를 보완하고 더 입체적인 답변을 만드는 흐름을 설명했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

TwelveLabs Marengo 3.0 비디오 임베딩을 AWS에서 저장·검색하는 두 벡터 DB를 비교했습니다. OpenSearch Serverless와 S3 Vectors의 성능, 비용, 활용 시점을 정리했습니다.
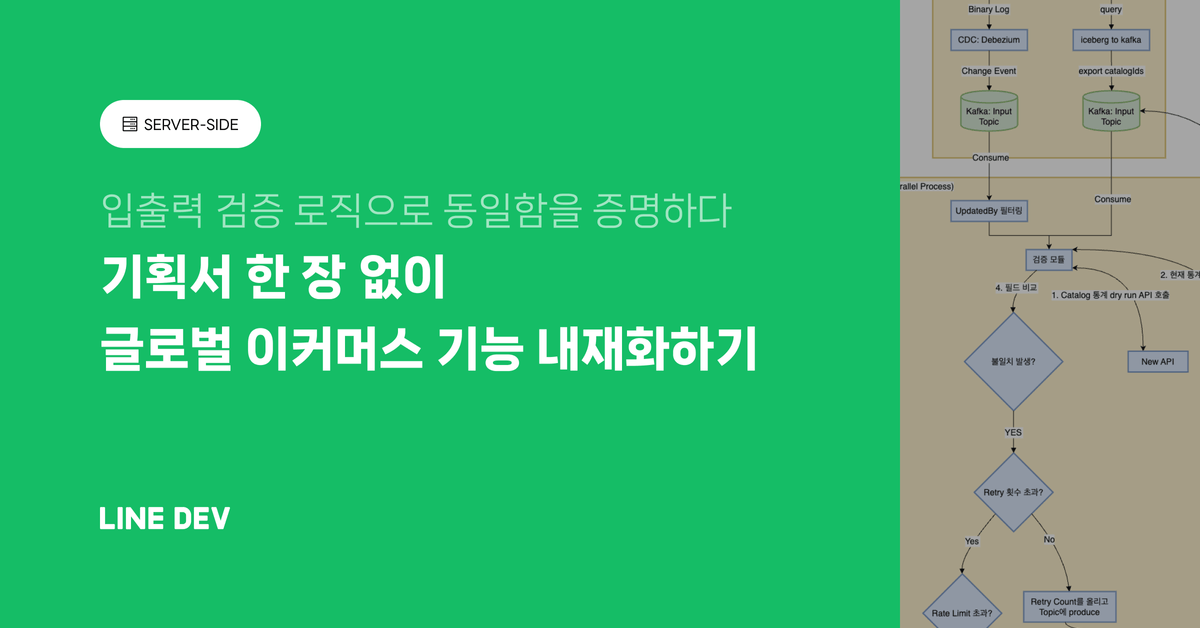
기획서가 없는 블랙박스 시스템을 내재화하며, 입력·출력 정의와 병렬 검증으로 동일성을 증명했습니다. Kafka와 CDC, OpenSearch를 활용해 조회·업데이트·E2E 전환을 안전하게 검증했습니다.

Amazon OpenSearch Service의 백프레셔와 Admission Control로 검색 요청을 제어해 클러스터 복원력을 높이는 방법을 소개했습니다. 429 오류 대응, 모니터링 방법, 재시도 전략도 함께 설명했습니다.
롯데백화점은 Bedrock과 Strands Agents로 AI 컨시어지 더스틴을 구축했습니다.\n이벤트 기반 색인과 토큰 최적화로 최신 정보 응답과 운영 효율을 높였습니다.

사내 최신 스펙과 코드 불일치 문제를 해결하기 위해 RAG 기반 챗봇을 도입했습니다. 메타데이터 필터링과 하이브리드 검색으로 정확도를 높이고 배포 파이프라인과 동기화했습니다.

Amazon OpenSearch Service에서 UBI와 OSI를 활용해 검색 행동 데이터를 수집하고 분석하는 방법을 소개했습니다. CDK 배포부터 대시보드 모니터링, 검색 품질 개선 활용처까지 실습 흐름으로 설명했습니다.