
4개 파트가 하나의 AI 시스템을 공유하기
4개 파트가 하나의 AI 시스템을 공유하기
인프라팀이 CLAUDE.md와 정책 파일로 AI 에이전트의 행동 기준을 통일했습니다. 반복 작업을 정책화해 온보딩, 장애 대응, 자동화를 함께 개선했습니다.
#Claude Code#Slack API
1300
인프라팀이 CLAUDE.md와 정책 파일로 AI 에이전트의 행동 기준을 통일했습니다. 반복 작업을 정책화해 온보딩, 장애 대응, 자동화를 함께 개선했습니다.
Claude Code의 사용 패턴과 비용, 성능을 팀 단위로 모니터링하는 4가지 방법을 정리했습니다. OpenTelemetry, SigNoz, Datadog, claude-code-otel로 ROI와 활용도를 확인할 수 있습니다.
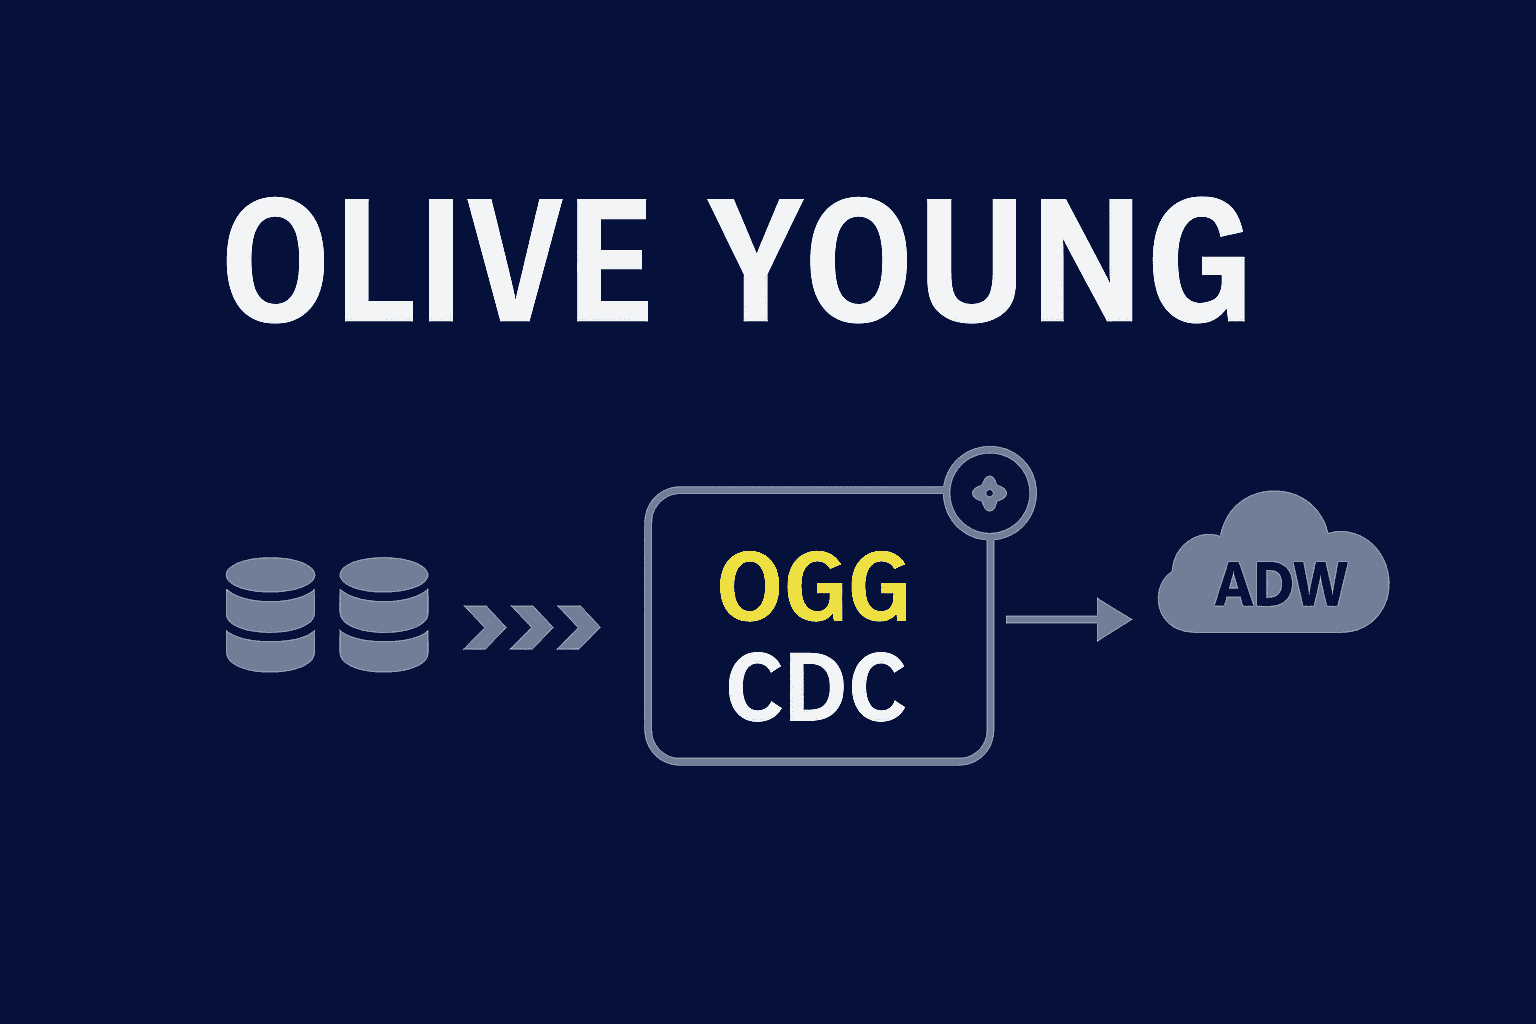

ODI 배치 기반 캠페인 동기화를 OGG와 Kafka 기반 CDC로 전환한 사례를 다뤘습니다. 메시지 순서 문제는 Retry, DLT, 복구 배치로 보완했고 실시간 정합성과 운영 모니터링을 강화했습니다.
쿠버네티스 기본 배포의 한계를 줄이기 위해 Argo Rollouts로 카나리 배포를 자동화했습니다. Nginx Ingress와 Datadog 연동으로 점진적 전환과 무인 롤백 구조를 구축했습니다.

Datadog 모니터링 분석을 Gemini로 자동화해 주간 작업 시간을 1시간에서 5분으로 줄였습니다. 다만 이미지 분석과 비즈니스 맥락 부족으로 인한 한계는 API 데이터와 검증 과정으로 보완했습니다.

실시간 메시지 기반 환경에서 데이터 정합성을 API 자동화 테스트로 검증한 사례를 소개했습니다. 정기 실행과 모니터링까지 연결해 리소스를 줄이고 운영 안정성을 높였습니다.
빅뱅 배포 기반 GMS 구축에서 QA가 기능, 동시성, E2E, UAT를 단계적으로 설계한 사례를 다뤘습니다. 운영 이후에는 Datadog 모니터링으로 조용한 실패까지 감시하며 안정성을 높였습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

서비스의 건강을 수치로 보기 위해 SLI와 SLO를 정의하고 운영하는 방법을 소개했습니다. 29CM 사례를 통해 지표 설계, 모니터링, 지속 개선 체계를 설명했습니다.
올리브영이 재고, 주문, WMS, 배송, 발주 시스템을 단계적으로 고도화한 과정을 소개했습니다. 실시간 연동과 내재화로 고객 경험과 운영 효율을 함께 개선했습니다.
올리브영 물류 시스템의 전반적 구성과 개선 과정을 정리한 글입니다. 실시간 재고, OMS, WMS, 배송최적화, 자동발주로 고객 경험과 운영 효율을 높였습니다.

Slack과 Gemini를 연동해 에러 원인과 조치 방안을 제안하는 Jarvis를 구축했습니다. MCP로 코드·로그 맥락을 보강해 운영 대응 시간을 줄였습니다.
Datadog을 POS 환경에 적용해 전국 3,500대 장비의 로그와 장애를 실시간으로 모니터링하도록 구축했습니다. 장애 탐지 시간은 4분 30초에서 59초로 줄어들고, 사전 대응 체계도 마련했습니다.
매장 도메인을 온·오프라인 대고객 서비스로 확장한 과정과 API 분리 전략을 소개했습니다. 또한 ECS, TeamCity, Datadog 기반의 배포·모니터링 구성까지 정리했습니다.