



RAG 시대, Vector DB 비교 가이드: Vespa vs Milvus vs Qdrant
RAG 구현에 필요한 벡터 DB로 Vespa, Milvus, Qdrant를 설치·사용성·성능 기준으로 비교했습니다. 프로젝트 규모와 검색 요구사항에 따라 적합한 선택지를 정리했습니다.
#RAG#Vector DB
16900
새로운 기술 블로그가 추가되었어요
RAG 구현에 필요한 벡터 DB로 Vespa, Milvus, Qdrant를 설치·사용성·성능 기준으로 비교했습니다. 프로젝트 규모와 검색 요구사항에 따라 적합한 선택지를 정리했습니다.

RAG에서 리랭커가 필요한 이유와 역할을 설명했습니다. 기존 방식과 LLM 기반 리랭킹, 적용 시 한계와 보완 방법도 함께 정리했습니다.
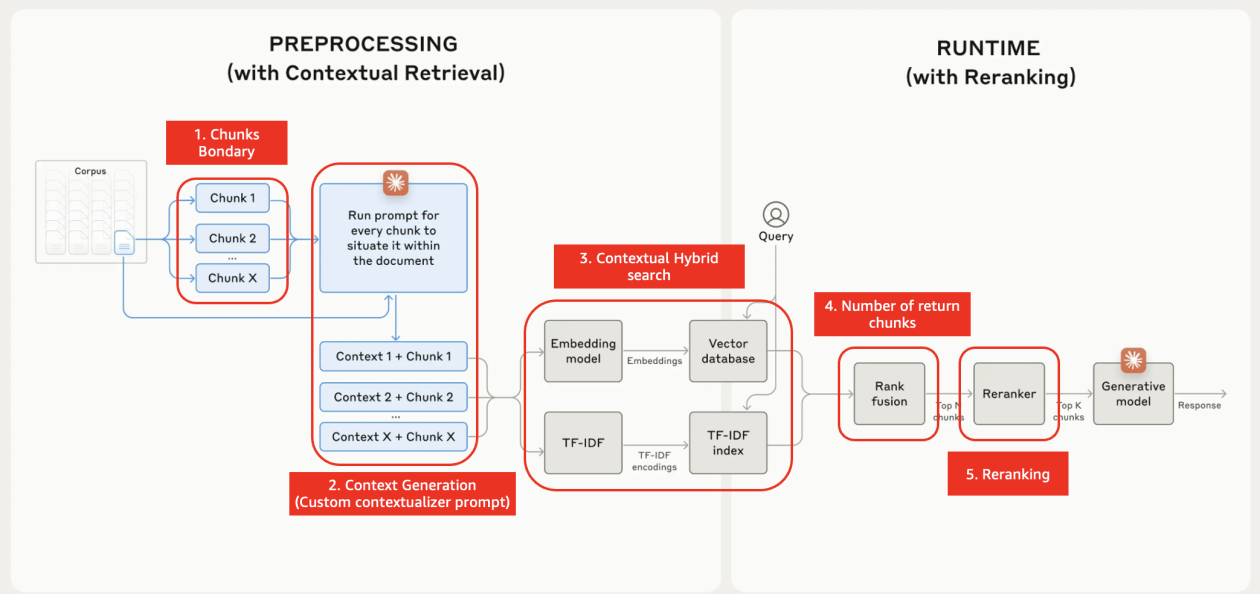

Amazon Bedrock에서 Contextual Retrieval로 RAG 검색 정확도를 높이는 방법을 설명했습니다. 전처리 컨텍스트 생성, 하이브리드 검색, 리랭킹, 프롬프트 캐싱까지 실무 구성을 함께 다뤘습니다.

Amazon Bedrock과 AWS Config로 규제 요구사항을 규칙에 자동 매핑하는 도구를 소개했습니다. 수동 관리의 한계를 줄이기 위한 프롬프트 설계와 운영 포인트도 함께 설명했습니다.

Amazon Bedrock과 Claude 3 Haiku로 연말정산 Q&A 챗봇을 구축해 문의 대응을 개선했습니다.\n구조화 데이터와 프롬프트 최적화를 통해 직접 문의를 약 40% 줄이고 생산성을 높였습니다.
우아한형제들 기술블로그를 엮은 두 번째 책 “요즘 우아한 AI 개발”을 소개했습니다. AI·데이터·로봇의 실무 적용 사례와 구성 내용을 함께 담았습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

자연어 검색 에이전트의 품질을 높이기 위해 Entity RAG와 Knowledge-aware retrieval을 적용한 사례를 소개했습니다. 신규 개체 인식과 테마 질의 대응 성능이 개선되었고, 향후 적용 범위 확대도 제시했습니다.
RAG와 LangChain, LangGraph의 역할과 구조를 비교해 AI Agent 개발 관점을 정리했습니다. 빠른 개발에는 LangChain, 복잡한 워크플로우에는 LangGraph가 적합하다고 설명했습니다.

Amazon Bedrock의 비정형 데이터 처리 기능과 활용 사례를 정리했습니다. 멀티모달 처리와 GraphRAG로 RAG 품질을 높이는 방법을 소개했습니다.

배달의민족은 GPT와 RAG를 활용해 상품 카탈로그 속성값 생성 자동화를 시도했습니다. 평가 모델을 보완해 작업 효율을 높이고 정확도도 개선했습니다.

Amazon Bedrock과 Amazon Neptune으로 GraphRAG 애플리케이션을 구축하는 방법을 소개했습니다. LlamaIndex와 NL2GraphQuery를 활용해 지식 그래프 검색과 개인화 추천을 연결했습니다.

SK하이닉스가 AWS 환경에서 RAG 플랫폼을 구축하고 성능을 평가한 사례를 소개했습니다. 데이터셋 크기와 인덱스 메모리가 검색 지연과 TTFT에 미치는 영향을 분석했습니다.

자동차 매뉴얼 검색을 위한 도메인 특화 RAG 데모 시스템을 개발했습니다. LLM과 메타 정보를 결합해 출처가 보이는 응답과 더 나은 사용자 경험을 제공했습니다.
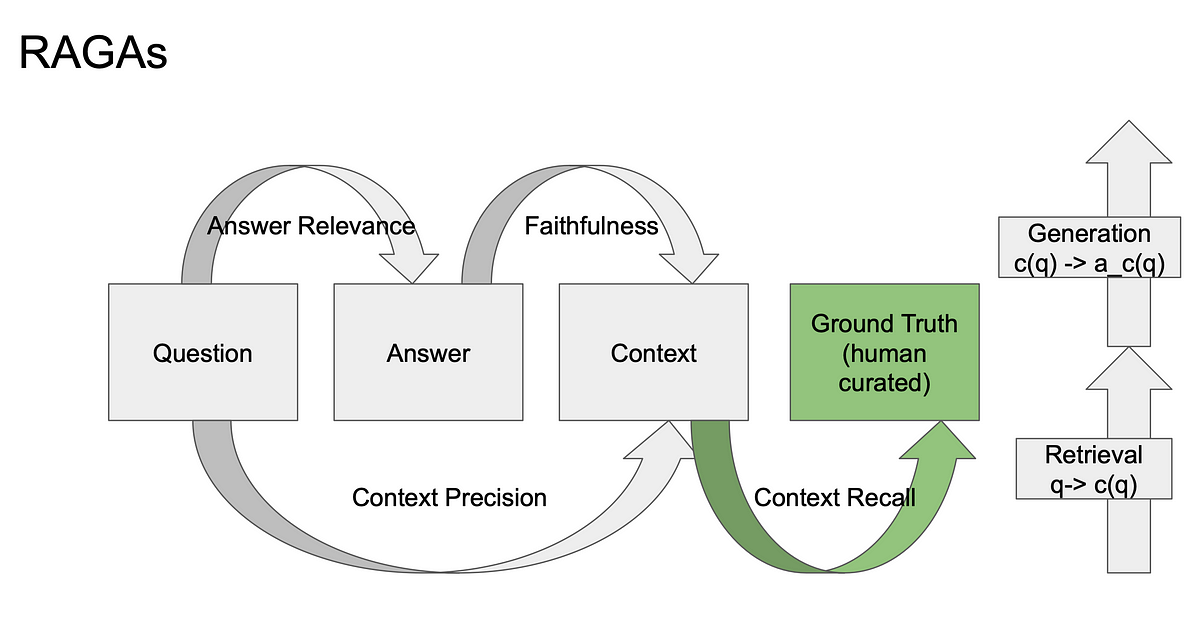
생성형 검색(RAG) 평가의 최근 트렌드와 주요 플랫폼, 지표 변화를 정리했습니다. LC와 RAG의 비교 결과를 통해 질문 유형별 적합한 접근도 살펴봤습니다.