

How We Pipe Data
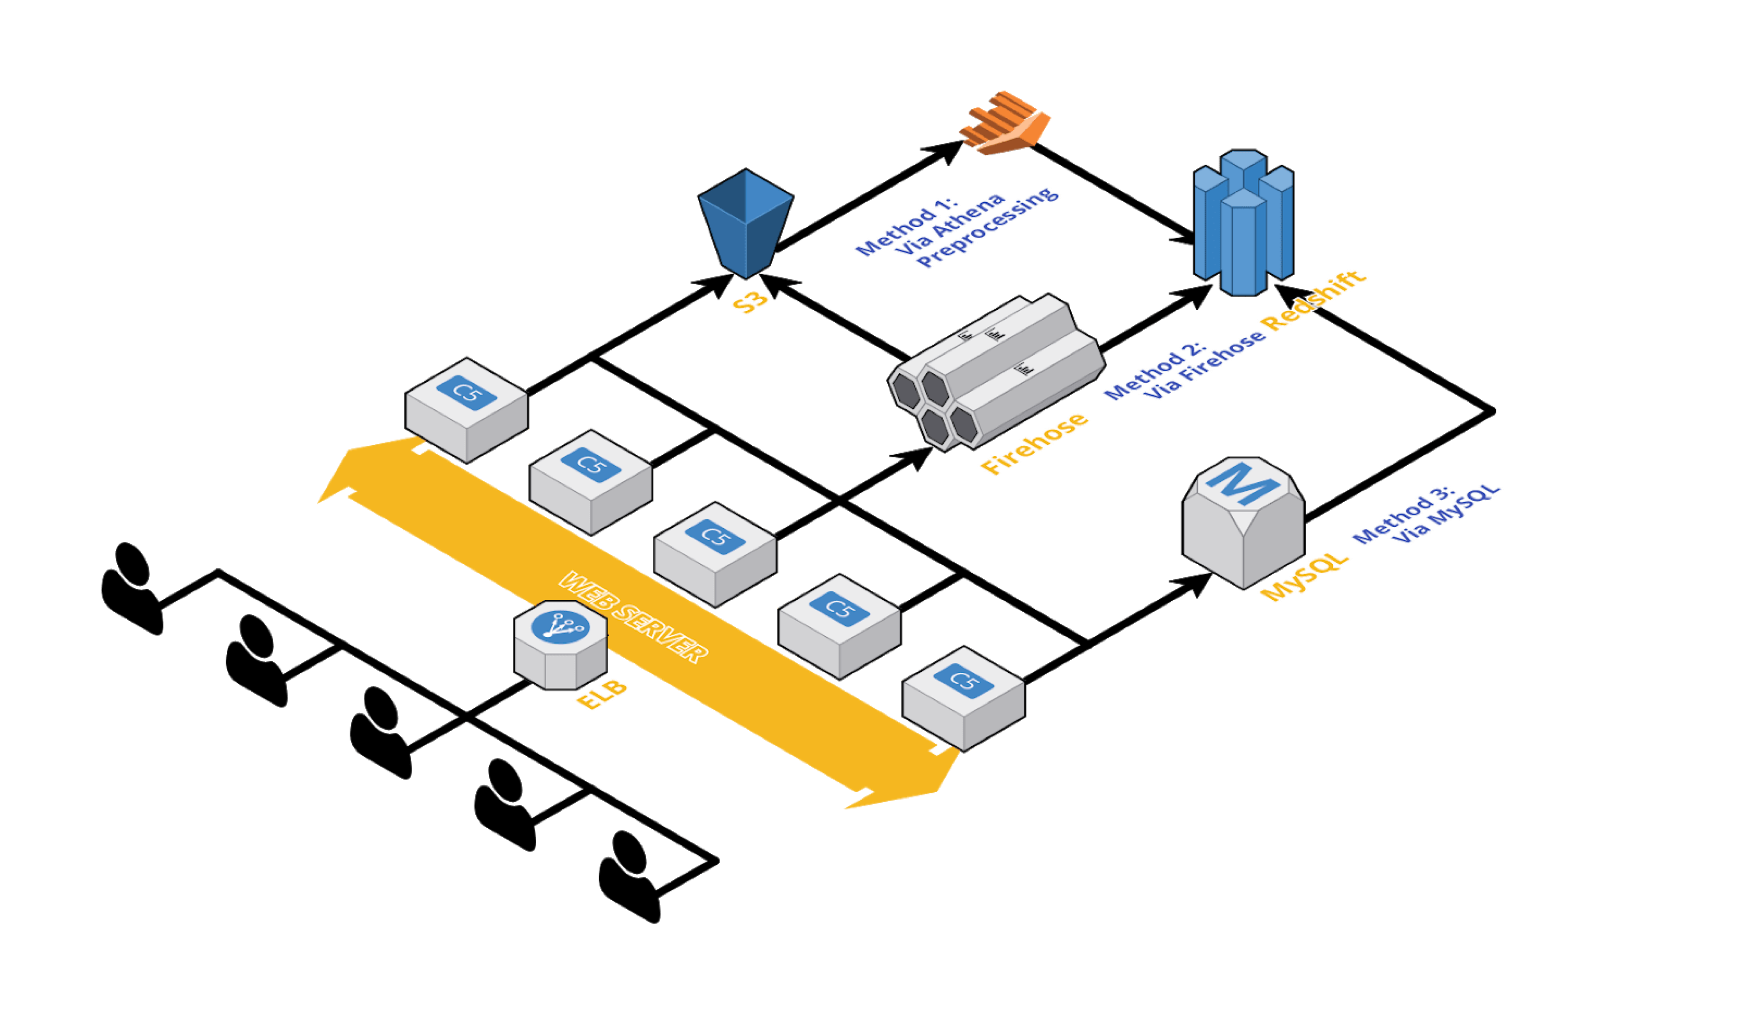
여러 저장소에 분산된 사용자·광고 활동 데이터를 Redshift로 통합하는 파이프라인을 소개했습니다. 컬럼형 저장, 빠른 적재, 수평 확장성을 핵심 선택 이유로 설명합니다.
#Redshift#pipeline
1200
새로운 기술 블로그가 추가되었어요
여러 저장소에 분산된 사용자·광고 활동 데이터를 Redshift로 통합하는 파이프라인을 소개했습니다. 컬럼형 저장, 빠른 적재, 수평 확장성을 핵심 선택 이유로 설명합니다.
여러 국가의 유저 행동 및 광고 데이터를 다양한 저장소에서 수집하는 환경을 소개했습니다. 분석과 활용을 위해 분산 데이터를 한곳에 모으는 필요성을 설명합니다.

AWS와 다중 데이터베이스를 조합한 모씨 서비스의 운영 구성을 소개했습니다. 캐시·검색·비동기 처리와 성능 제약 대응 사례를 정리했습니다.