AI
RAG 검색 알고리즘을 바꾸지 않고 검색 품질을 개선한 방법_AIOps

두줄요약
RAG 알고리즘을 유지한 채 질의 중심 인덱스와 답변 DB 분리로 Q&A 검색 노이즈를 줄였습니다. BM25·KNN·RRF의 후보 품질과 운영 검증 기준을 설명합니다.
문제 상황
- 질문과 상세 답변을 함께 인덱싱한 Q&A 기반 RAG에서 정답 항목보다 부가 설명이 많은 문서가 상위에 노출되는 검색 실패
- 정답 Answer ID가 Top-K 후보에서 누락될 경우 LLM이 올바른 근거를 활용하기 어려운 구조
원인 분석
- BM25에서 상세 답변의 부가 키워드가 검색 의도와 다른 매칭 신호로 작용하는 문제
- KNN 임베딩에 질문 의도 외 예외 처리·후속 절차 문맥까지 반영되는 문제
- BM25와 KNN 양쪽의 잘못된 상위 순위가 RRF 결합 결과에도 이어지는 구조
해결 방법
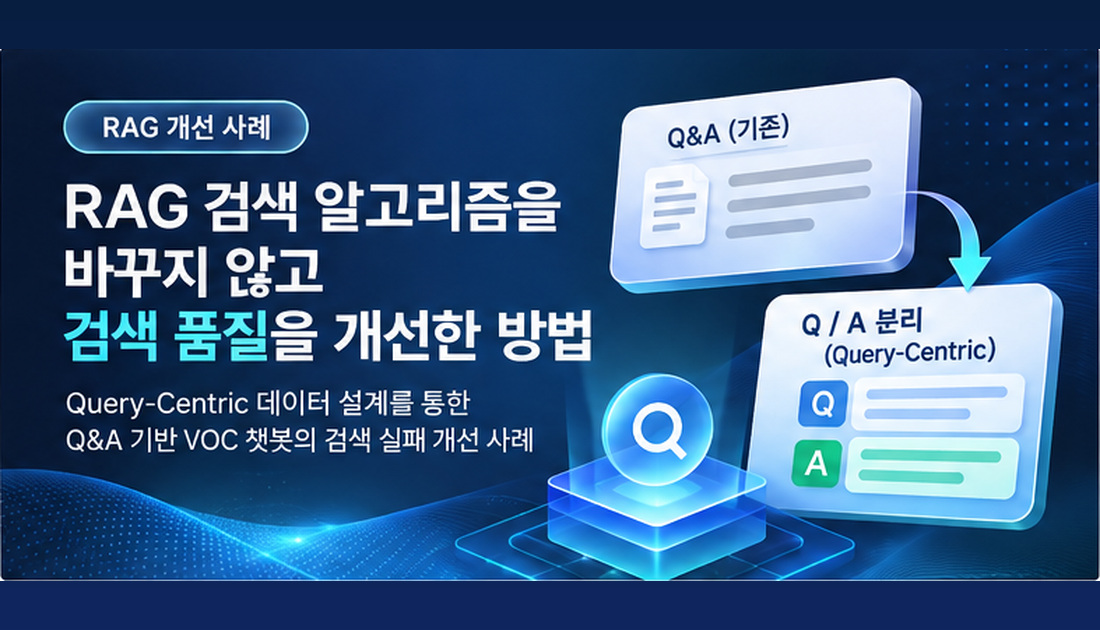
- 검색 알고리즘은 유지하고 검색 대상을 질문 의도 중심의 Query-Centric 텍스트로 재설계
- 대표 질의·동의어·구어체를 포함하되 서로 다른 해결 절차의 의도는 별도 Q&A 항목으로 분리
- 검색 인덱스의 Answer ID로 별도 Answer DB에서 상세 답변을 조회하는 역할 분리
성능/운영 포인트
- Top-1 Accuracy, Hit@K, Retrieval Failure Rate@K로 검색 대상 텍스트 변경 효과 검증
- 검색 표현의 과도한 확장 방지, 한국어 토큰화·분석 설정 점검, 중복 Answer ID 처리 필요
- Retrieval·답변 조회·Generation 단계를 분리한 오류 진단과 인덱스-답변 DB 정합성 관리