
통합 데이터 허브로 가는 길 - Part 2
통합 데이터 허브로 가는 길 - Part 2
엔터프라이즈 데이터 허브를 위해 JupyterHub 아키텍처와 사용자 격리, 보안 구조를 재설계했습니다. DockerSpawner, 표준 베이스 이미지, IAM Role 기반 권한 관리로 통합 환경을 구축했습니다.
#JupyterHub#Docker
700
엔터프라이즈 데이터 허브를 위해 JupyterHub 아키텍처와 사용자 격리, 보안 구조를 재설계했습니다. DockerSpawner, 표준 베이스 이미지, IAM Role 기반 권한 관리로 통합 환경을 구축했습니다.
레저 상품이 왜 NOL을 거쳐 발급되는지 채널링 구조와 LCMS 운영 방식을 설명했습니다. 판매 채널, 재고, 정산, CS를 한 곳에서 통합하는 허브 역할을 다뤘습니다.
데이터는 많지만 도구와 흐름이 흩어져 있어 활용이 어려운 문제를 다뤘습니다. 이를 해결하기 위해 JupyterHub와 dbt 조합을 통합 데이터 허브의 기반으로 선택했습니다.
준비되지 않은 인스턴스를 잘못 사용하는 문제를 다뤘습니다. 초기화 시 준비, 지연 준비, 타입 분리를 통해 안전한 API 설계를 제안했습니다.

S3 Tables의 운영 전략과 StarRocks 도입 과정을 정리했습니다. Compaction, Snapshot, 모니터링, 캐시 TTL 설정의 실무 포인트를 다뤘습니다.
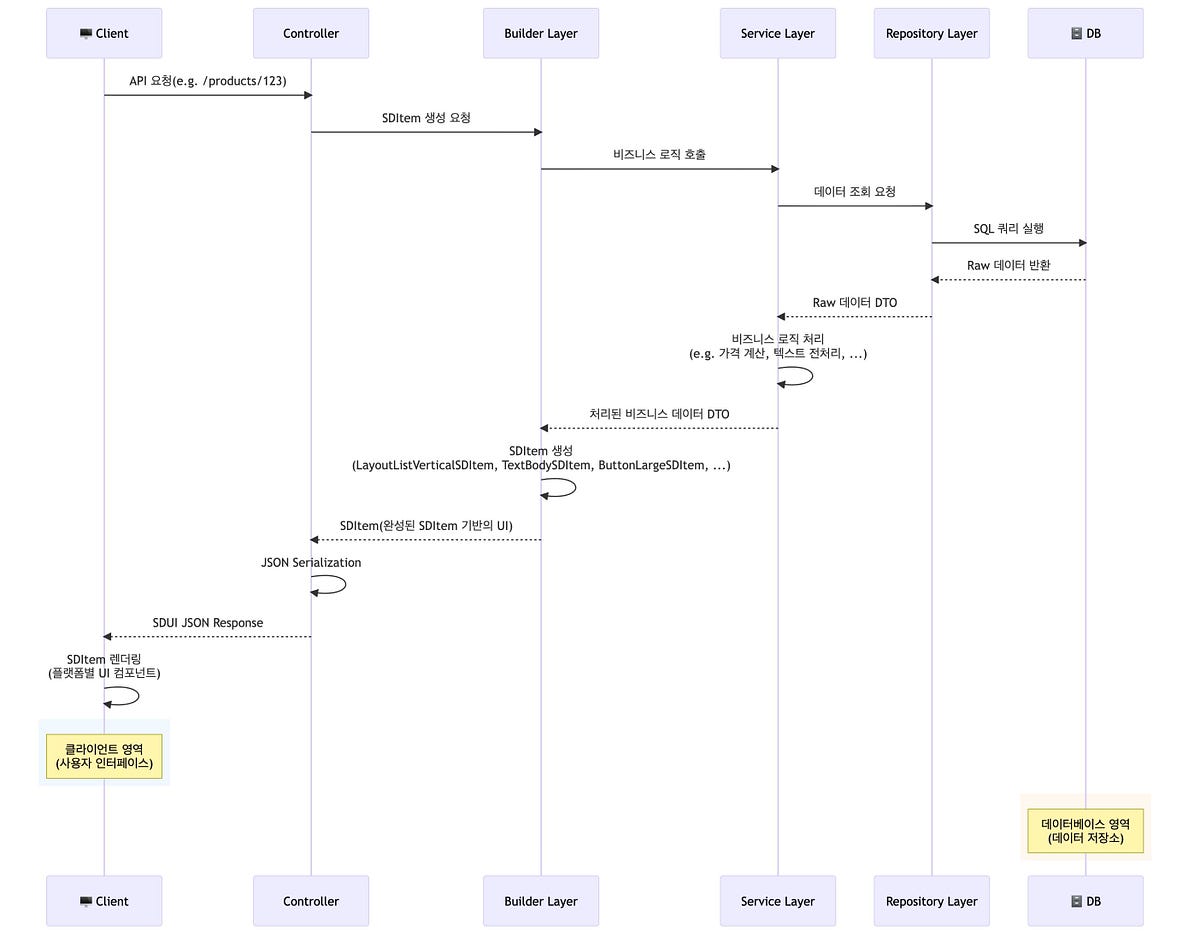
서버가 UI를 주도하는 SDUI로 KREAM의 배포 병목을 줄이고 실험 속도를 높인 사례를 소개했습니다. 또한 Builder 레이어를 더한 4-Layer Architecture와 내부 Generator로 유지보수성과 검증 효율을 개선했습니다.
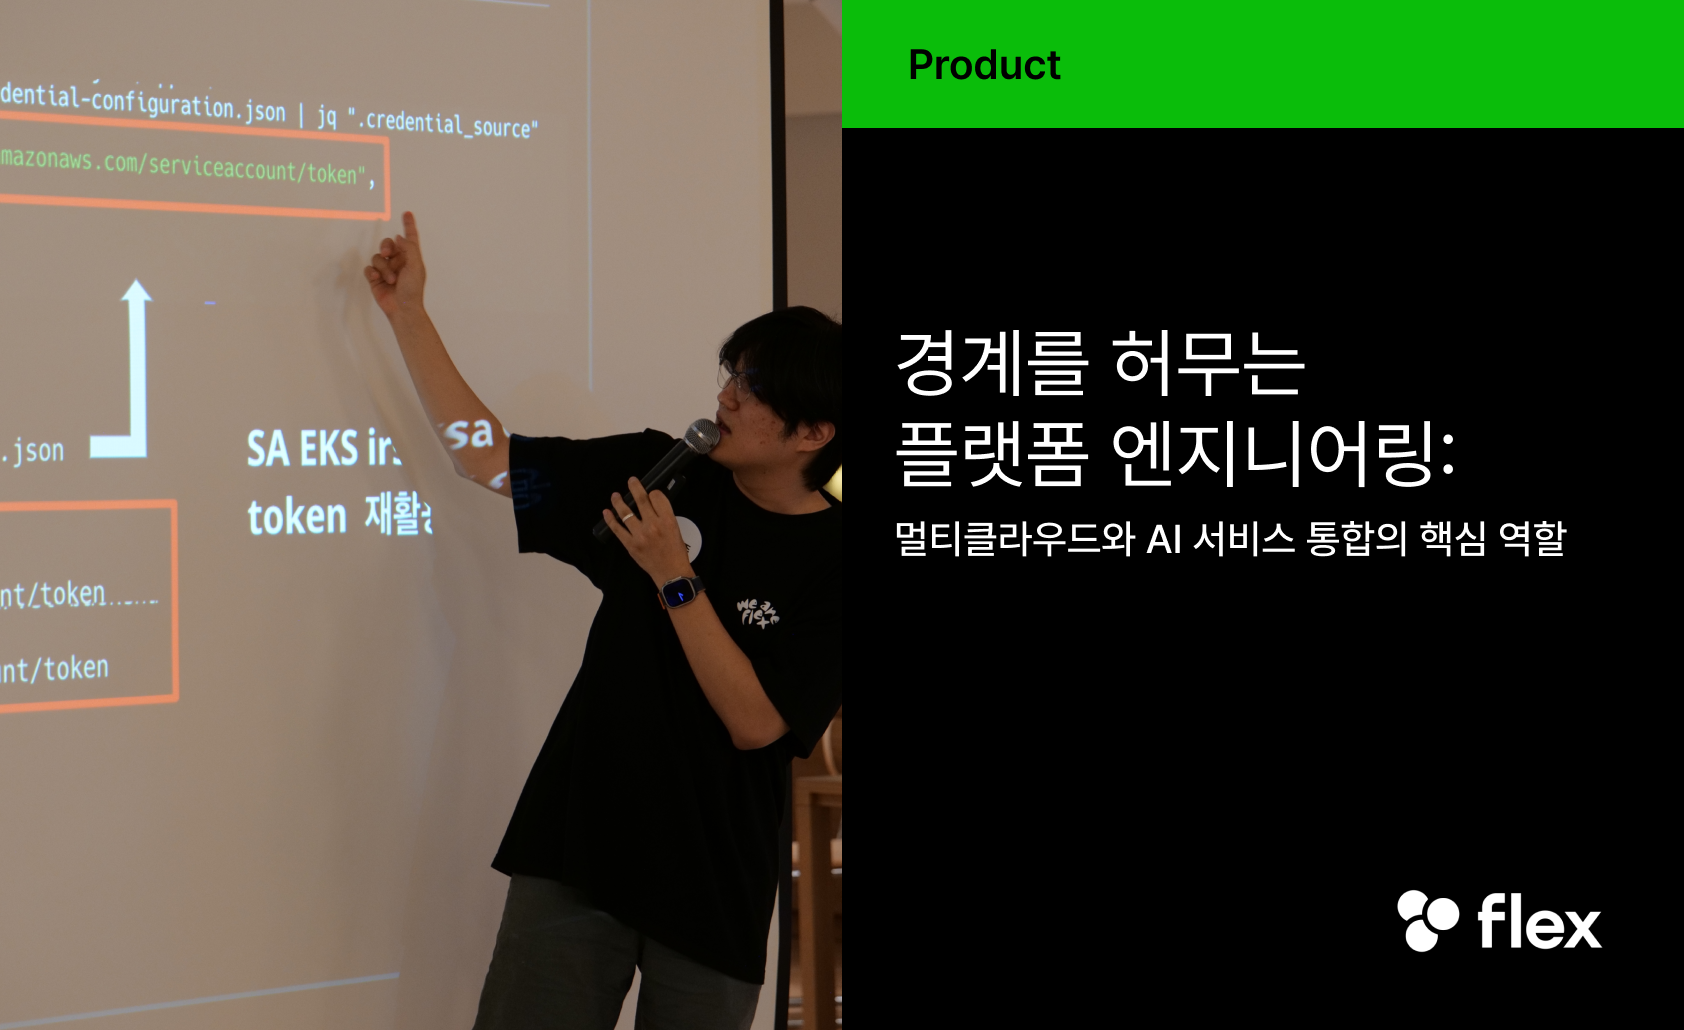

멀티클라우드와 AI 통합을 위해 LLM 비종속 아키텍처와 권한 자동화 체계를 구축했습니다. 또한 호출 로그를 모아 비용을 추적하고 FinOps 인사이트를 확보했습니다.

레거시 결제창을 결제 도메인 중심 구조로 재설계한 사례를 다뤘습니다. 기능 추상화와 단계적 전환, 자동 롤백으로 가맹점 영향 없이 개편했습니다.

대규모 검색 API를 멀티모듈 구조로 리팩토링한 사례를 정리했습니다. 도메인 분리와 의존성 정리를 통해 유지보수성과 협업 효율을 높이는 방법을 설명했습니다.

토스페이먼츠가 20년 레거시 결제 시스템을 현대적 아키텍처로 개편한 과정을 소개했습니다. 점진적 전환과 표준화, 자동화로 안정성과 성능을 함께 끌어올렸습니다.
중복 CIDR 환경에서 TGW 라우팅 충돌과 Egress 제어 문제를 해결하는 AWS 아키텍처를 정리했습니다. Private NAT Gateway, 보조 CIDR, DNS Firewall, AWS Network Firewall을 조합한 중앙 집중형 보안검사 허브가 비용과 운영 측면에서 유리했습니다.
nginx 설정에 의존하지 않고 서비스 점검용 접근 차단을 구현한 사례를 다뤘습니다. 메타데이터와 실행데이터를 분리해 화면과 API를 유연하게 제어했습니다.

AWS 기반 PLM 솔루션이 제조업의 협업과 데이터 관리, 확장성을 어떻게 높이는지 설명했습니다. Siemens Teamcenter 사례를 통해 FSx for NetApp ONTAP의 성능과 가용성 이점을 소개했습니다.

20년 이상 된 레거시 PG 시스템을 단계적으로 재설계해 민첩성과 변경 용이성을 높이려는 시리즈를 소개했습니다. 가맹점 영향 없이 결제창과 정산 배치를 현대화하고 하이브리드 클라우드 기반 개편을 다룹니다.