
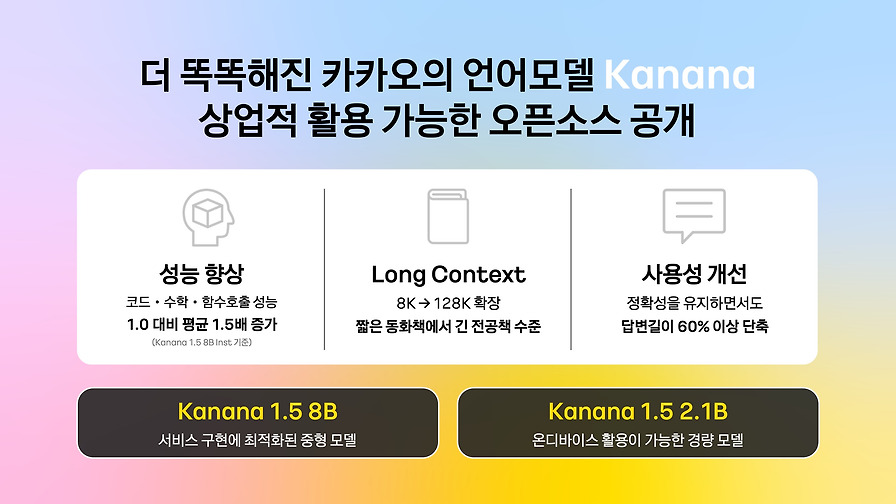
더 똑똑해진 카카오의 언어모델 Kanana 1.5, 상업 활용 가능한 오픈소스 공개
카카오가 자체 언어모델 Kanana 1.5를 공개했습니다. 상업 활용 가능한 오픈소스로 더 강력한 성능과 자유로운 사용성을 강조했습니다.
#LLM
5800
카카오가 자체 언어모델 Kanana 1.5를 공개했습니다. 상업 활용 가능한 오픈소스로 더 강력한 성능과 자유로운 사용성을 강조했습니다.
Kanana LLM 1.5의 개발 배경과 성능 강화 방향을 소개했습니다. Agentic AI 활용을 위한 언어모델 개선 맥락을 다뤘습니다.

Strands Agents는 모델 중심 접근 방식으로 AI 에이전트를 간단하게 구축하고 배포할 수 있는 오픈 소스 SDK를 소개했습니다. 프롬프트와 도구만 정의해 로컬 개발부터 프로덕션 관찰성까지 지원하는 점을 강조했습니다.
카카오T에 On-Device AI와 Cloud AI를 결합한 하이브리드 전략을 적용한 개발 과정을 공유했습니다. 주소 자동 입력 기능에 적용해 사용자 처리 시간 단축과 완료율 향상 성과를 확인했습니다.

MAB 기반 가격결정의 한계를 보완하기 위해 그룹화, 목적함수, adaptive window, regret 평가를 단계적으로 도입했습니다. 상품별 판매 결과를 바탕으로 더 민첩하게 모델을 선택하는 방향으로 개선했습니다.
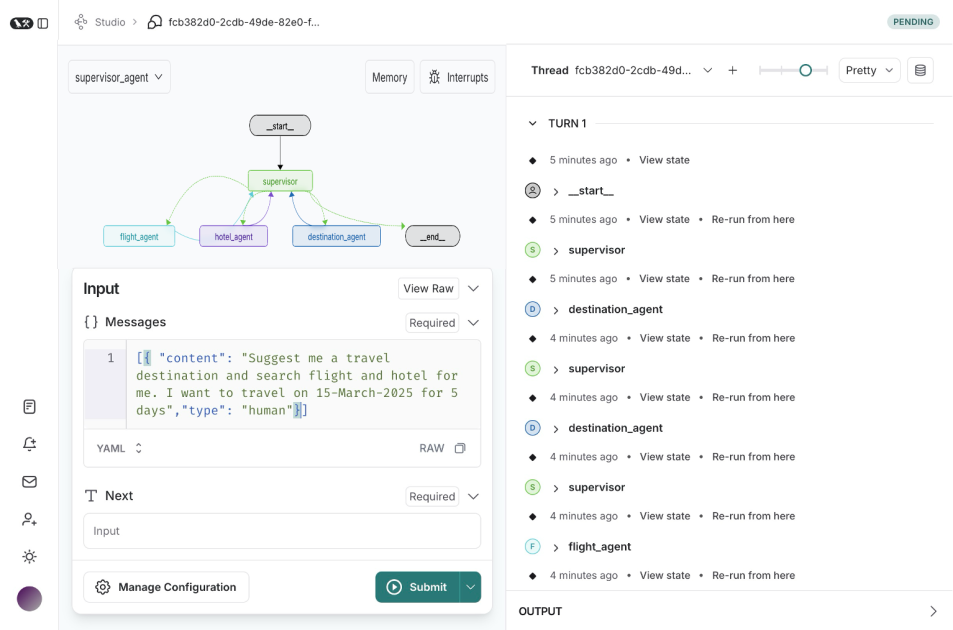
Amazon Bedrock과 LangGraph로 Supervisor 중심의 Multi Agent 여행 도우미를 구현하는 방법을 소개했습니다. 상태 관리, 오케스트레이션, 디버깅과 운영 고려사항까지 함께 설명했습니다.
인페인팅 기반 배경 인물 제거 결과를 사람 평가와 여러 자동 지표로 비교했습니다. 데이터셋에 따라 Aesthetic Score와 CMMD가 유망한 평가 방법으로 나타났습니다.
MCP 서버와 AI 에이전트의 역할을 분리해 설계해야 하는 이유를 설명했습니다. 실행 통제와 감사 가능성을 위해 MCP Agent PAM 같은 보안 계층도 함께 고려해야 합니다.
RAG 시스템의 환각 원인으로 명사구 충돌을 설명하고, 이를 줄이기 위한 전처리와 쿼리 분할 방안을 소개했습니다. 기업 문서 특성에 맞춘 데이터 사전처리로 정확도를 높일 수 있다고 정리했습니다.

GPT는 기본적으로 다음 단어를 예측하는 모델이라 대화가 어렵습니다. instruction tuning으로 질문-답변 형식을 학습해 ChatGPT 같은 대화형 모델로 확장했습니다.
당근 아이덴티티 서비스팀이 4일 해커톤으로 반복 업무를 AI 자동화로 바꾼 사례를 소개했습니다. 지표 정리, 온콜 인수인계, 에러 분석을 슬랙봇과 MCP로 개선했습니다.
세법 RAG의 문서 간 관계 파악 한계를 해결하기 위해 GraphRAG를 도입했습니다. 지식 그래프와 벡터 검색을 결합한 이중 검색 구조를 설명합니다.
반복적인 데이터 요청을 줄이기 위해 기존 SQL 쿼리를 임베딩해 재사용하는 AI 도구 MySQLTrip을 소개했습니다. 검증된 쿼리를 바탕으로 자동 생성과 에러 체크까지 연결해 데이터팀 효율을 높였습니다.
비대면 금융의 개인화 부족을 해결하기 위해 AI 대출 음성 상담 챗봇을 개발했습니다. 합성 데이터와 RAG, AWS AI 서비스를 결합해 실시간 상담과 추천 흐름을 구현했습니다.