
카카오게임즈의 Amazon Bedrock 기반 실시간 채팅 번역 구축
카카오게임즈가 Amazon Bedrock으로 실시간 게임 채팅 번역 시스템을 구축한 사례를 소개했습니다. 프롬프트 중심 구조와 캐싱, 모니터링으로 저지연과 운영 효율을 확보했습니다.
#AWS#Amazon Bedrock
7000
카카오게임즈가 Amazon Bedrock으로 실시간 게임 채팅 번역 시스템을 구축한 사례를 소개했습니다. 프롬프트 중심 구조와 캐싱, 모니터링으로 저지연과 운영 효율을 확보했습니다.
스냅 이미지를 검색어로 활용하는 이미지·자연어 검색 PoC를 6주간 검증했습니다. 객체 탐지, 임베딩, 벡터 검색으로 유사 상품 추천과 스타일 검색 가능성을 확인했습니다.


제품 개발 과정의 정보 파편화와 동기화 비용을 줄이기 위해 AI 가상 구성원을 도입한 사례를 소개했습니다. LLM을 맥락 연결과 번역의 허브로 활용해 협업 문화와 실행력을 높이는 방향을 제시했습니다.

GPT의 핵심 구조인 트랜스포머 디코더와 Self Attention 흐름을 수식 없이 설명했습니다. 입력 벡터화부터 다음 단어 예측까지의 과정을 단계별로 정리했습니다.

QANDA가 생성형 AI 시대에 맞춰 단일 문제풀이 앱에서 멀티 에이전트 학습 플랫폼으로 재설계되었습니다. 또한 Plan-and-Execute, Artifact, LangGraph 기반 구조로 의도 분류와 상태 관리를 안정화했습니다.
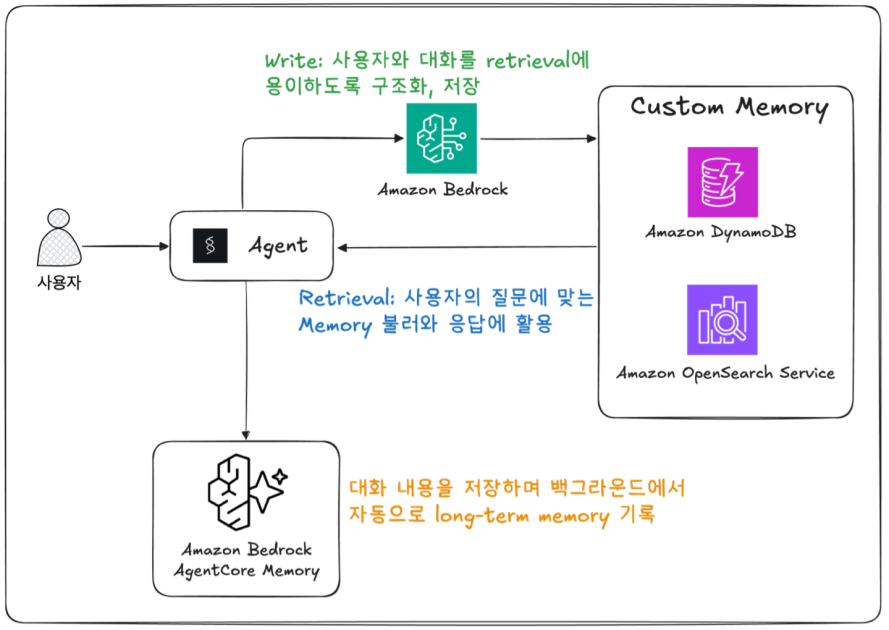
Amazon Bedrock AgentCore Memory와 Custom Memory로 쇼핑 에이전트의 개인화 추천을 구현한 사례를 소개했습니다. 긴 대화 전체보다 중요한 정보만 메모리로 구조화해 더 적은 토큰으로 높은 추천 품질을 얻는 방법을 설명했습니다.
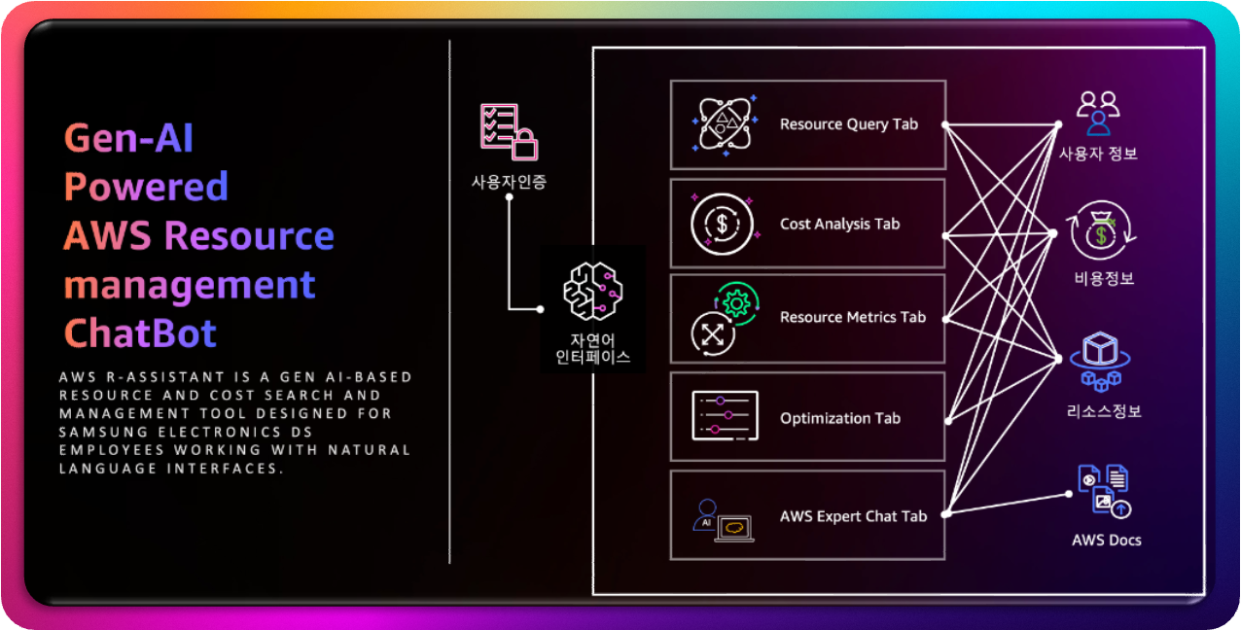
Amazon Bedrock과 Streamlit을 활용해 AWS 리소스와 비용을 자연어로 관리하는 챗봇을 소개했습니다. 콘솔 탐색을 줄이고 모니터링, 분석, 최적화를 한 화면에서 제공하는 점이 핵심입니다.

Amazon Bedrock과 AWS Lambda로 독서 문항 초안 생성 과정을 자동화한 사례입니다. 프롬프트 관리와 캐싱, 병렬 처리를 통해 비용과 작업 시간을 줄였습니다.

웹 크롤링 데이터로 LLM 사전학습 데이터셋을 만든 경험과 어려움을 정리했습니다. NVIDIA EMNLP 2024 논문을 통해 품질 필터링과 중복 제거 전략을 체계적으로 살펴봤습니다.
LY Corporation 사내 해커톤 Hack Day 2025 참가 후기를 전했습니다. 자유 주제 개발과 90초 발표, 글로벌 네트워킹과 AI 기반 프로덕트 경험을 공유했습니다.
AWS Summit 2025에서 Amazon Q in Quicksight와 Amazon Q Business 활용 사례를 소개했습니다. 자연어 기반 분석과 사내 질의 응답으로 데이터 활용 장벽을 낮춘 점이 핵심입니다.
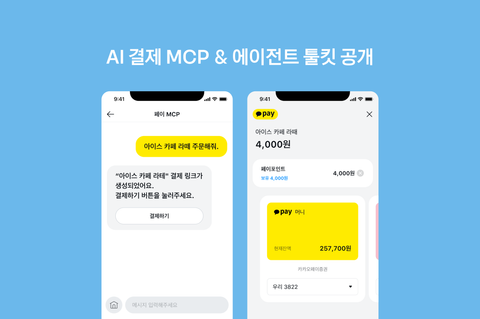
카카오페이는 AI 에이전트가 결제 API를 호출할 수 있도록 MCP 기반 Agent Toolkit을 개발했습니다. 표준 프로토콜과 멀티 프레임워크 지원으로 결제 연동의 확장성과 호환성을 높였습니다.

Two-Tower 모델로 추천시스템의 후보 검색 단계와 학습 방식을 개선한 적용 사례를 다루었습니다. In-Batch Sampled SoftMax, LogQ Correction, ScaNN 활용과 운영 모니터링까지 함께 소개했습니다.

재무회계팀이 반복 수기 업무를 AI와 Python, Cursor로 자동화한 사례를 소개했습니다. 비개발자도 작은 작업부터 시작해 실무 효율과 팀 문화 변화를 이끌 수 있음을 보여줬습니다.