

진짜 AI 에이전트형 코딩 툴 'Claude-Code'
Claude Code를 자율형 코딩 에이전트로 소개하며 개발 전 과정을 자동화하는 흐름을 설명했습니다. MCP, 터미널 통합, 다중 에이전트로 생산성과 학습 효율을 높이는 활용법도 정리했습니다.
#Claude Code#MCP
9900
Claude Code를 자율형 코딩 에이전트로 소개하며 개발 전 과정을 자동화하는 흐름을 설명했습니다. MCP, 터미널 통합, 다중 에이전트로 생산성과 학습 효율을 높이는 활용법도 정리했습니다.

LG전자가 Amazon Bedrock으로 소셜미디어 제품 트렌드 모니터링 시스템을 구축한 사례를 다뤘습니다. DeepEval 기반 평가와 모델 비교를 통해 정확도, 속도, 비용을 함께 검증했습니다.

AI 시대에는 UI 중심 테스트보다 API 중심 테스트와 시나리오 기반 검증이 중요해졌습니다. 핵심 플로우만 UI로 확인하고, 나머지는 자동화와 Observability로 품질을 보장해야 했습니다.
Kiro를 활용해 Spec-Driven Development와 Augmented Coding을 결합하는 AI 개발 방식을 소개했습니다. 문서화, Steering 파일, TDD를 통해 컨텍스트 소실과 반복 실수를 줄이는 흐름을 설명했습니다.
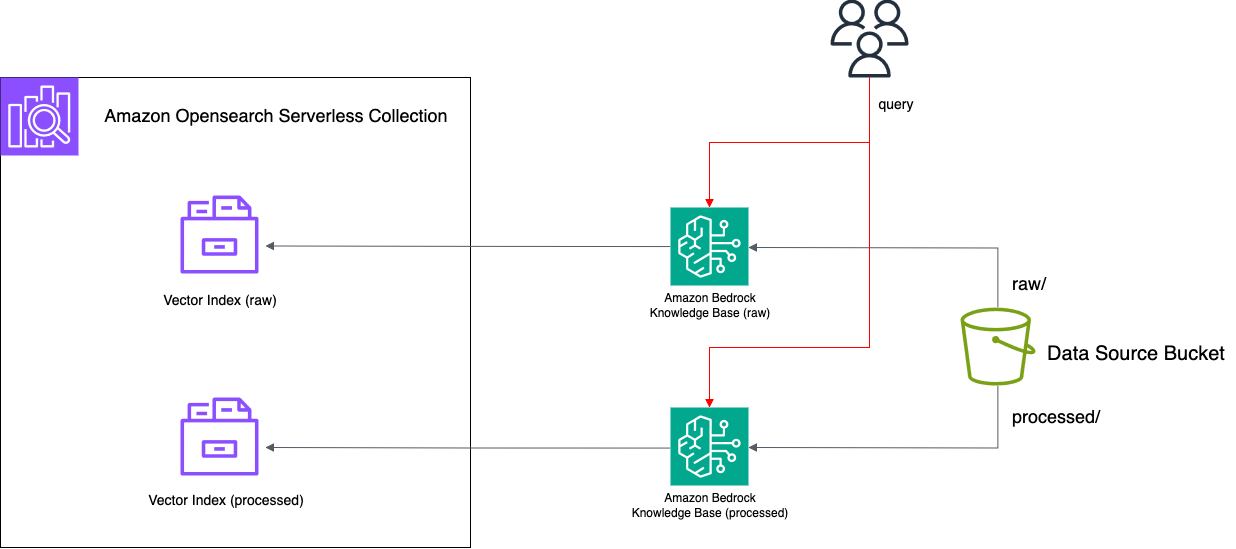
FAQ 같은 짧은 구조화 데이터는 일반 청킹보다 No Chunking이 더 적합했습니다. CSV와 메타데이터를 활용해 검색 정확도와 검증 편의성을 높이는 방법을 소개했습니다.

Text2SQL이 왜 어려운지 명시적·암묵적 맥락, 사용자 의도, SQL 방언 차이 관점에서 정리했습니다. ERP 데이터 시각화 Agent 맥락에서 실무적으로 고려할 점도 함께 짚었습니다.
AI 생성 코드와 잦은 릴리즈로 보안 위험이 커지면서 DevSecOps가 기본값으로 주목받았습니다. 개발 초기부터 보안을 내재화하고 AI 기반 도구로 취약점 탐지와 대응 속도를 높이는 내용입니다.
광고사업팀 인턴이 반복 운영 업무를 AI로 자동화해 월 40시간 이상의 작업을 90% 이상 줄였습니다. 자연어 기반 협업과 문제 정의를 통해 보고서 작성, 배너 검수까지 효율화했습니다.

양자 컴퓨터 성능을 평가하는 지표와 현실적 한계를 정리했습니다. 또한 오류 제어를 QEC, QES, QEM으로 나누어 비교했습니다.
A2A와 Genkit으로 레시피 추천용 AI 에이전트를 구축한 사례를 공유했습니다. 의미 판단은 AI에 맡기고 계산과 최적화는 코드와 인프라로 분리해 성능을 높였습니다.
A2A와 Genkit으로 레시피 추천용 AI 에이전트를 구축한 과정을 다뤘습니다. 330만 건 비교 문제를 필터링, 프롬프트 최적화, 병렬 인프라로 해결했습니다.

DSPy를 활용한 프롬프트 최적화와 자동화 방법을 소개했습니다. 반복 평가와 비교 실험을 코드로 줄여 LLM 품질 관리에 적용할 수 있었습니다.
Amazon Bedrock 기반으로 FAQ Fast-Path와 Advanced RAG를 결합한 고객 응대 챗봇 구축 사례를 소개했습니다. 또한 비식별화, Guardrails, VPC·PrivateLink로 금융 서비스 수준의 보안성을 강화했습니다.

CLIP과 BLIP의 구조와 용도를 비교하며 이미지-텍스트 유사도 계산 예시를 정리했습니다. CLIP은 직접 매칭에, BLIP은 캡션 생성 후 의미 비교에 적합했습니다.