
당근의 AWS 기반 피처 플랫폼 구축 여정, Part 1: 구축 배경과 피처 서빙
당근은 추천 시스템 고도화를 위해 AWS 기반 피처 플랫폼을 설계하고, 다단계 캐시와 일관된 스키마로 피처 서빙을 구성했습니다. 캐시 미스, 정합성, 관통 문제를 완화하며 대규모 트래픽을 안정적으로 처리하는 구조를 소개했습니다.
#AWS#Feature Store
6400
당근은 추천 시스템 고도화를 위해 AWS 기반 피처 플랫폼을 설계하고, 다단계 캐시와 일관된 스키마로 피처 서빙을 구성했습니다. 캐시 미스, 정합성, 관통 문제를 완화하며 대규모 트래픽을 안정적으로 처리하는 구조를 소개했습니다.

제로 클릭 시대에 맞춘 GEO 전략과 AI 친화적 콘텐츠 제작 방법을 정리했습니다. 브랜드 엔티티와 채널 운영을 정비해 AI 인용과 전환을 높이는 실무 과제를 소개했습니다.
무신사는 VLM 기반 자동화가 늘어도 사람의 검증과 기준 조정이 필요하다고 보았습니다. 이를 위해 실험·검증·평가를 하나로 묶는 VLMOps 어드민을 구축해 효율과 품질을 높였습니다.
VLM 기반 상품 메타데이터 추출에서 Human-in-the-loop를 지원하는 어드민 구축 과정을 소개했습니다. 모델 추론, 검증, 골든셋 관리, 평가를 하나의 순환 구조로 묶어 운영 효율을 높였습니다.

5,000개 PPT와 80,000개 Vector DB로 의미기반 검색용 Ontology DB를 구축한 사례를 소개했습니다. 메타정보와 Long Context Embedding으로 RAG 검색 성능과 데이터 연관성을 높였습니다.
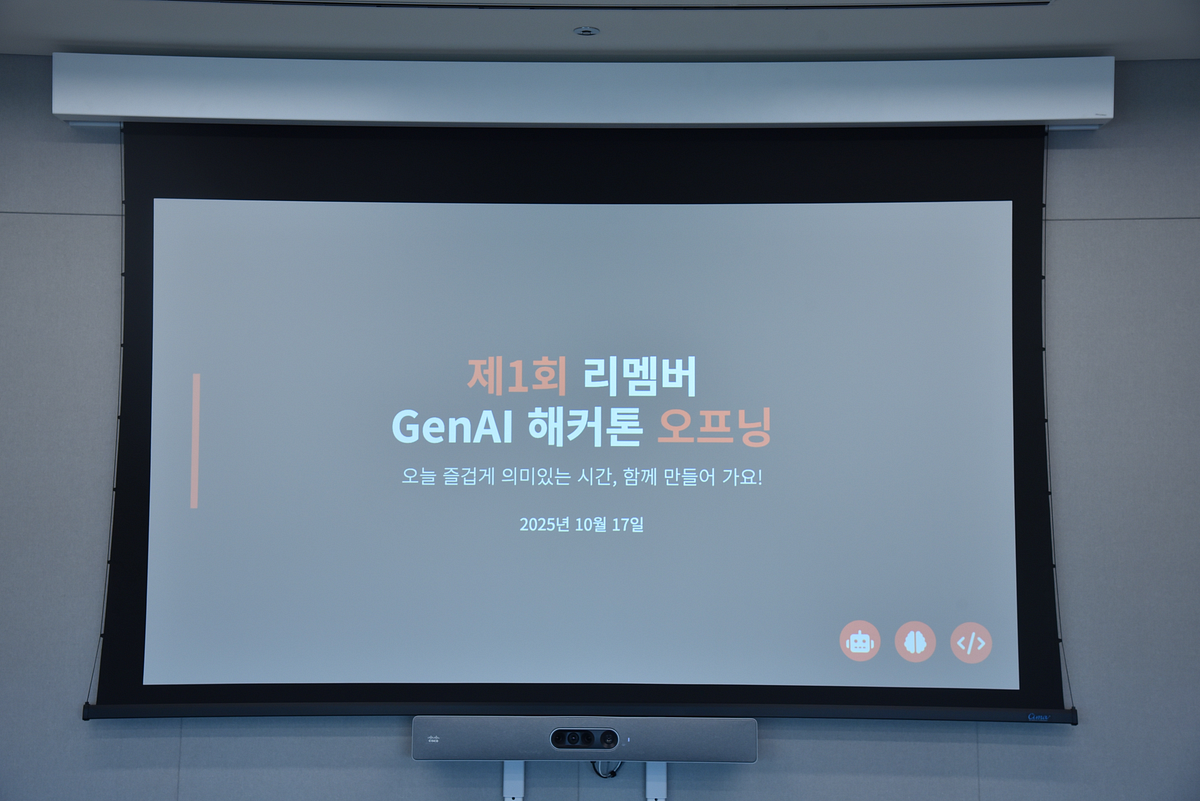
리멤버가 첫 사내 Gen AI 해커톤을 AWS와 함께 운영한 후기를 공유했습니다. 12개 팀의 열정적인 발표와 현장 대응 경험, 그리고 AI 아이디어의 실제 적용 기대를 전했습니다.
NOL은 고객의 클릭과 검색 같은 행동 데이터를 바탕으로 User segment를 만들었습니다. 태그 조합과 점수, 기간별 윈도우로 개인화와 예측의 정교함을 높였습니다.
Agentic AI가 지시 수행형 AI에서 계획과 도구 선택이 가능한 형태로 발전한 흐름을 소개했습니다. AI가 ‘생각하는 동료’로 보이게 된 배경을 살펴보는 글입니다.
AWS Bedrock Prompt Caching으로 Chat DIC의 반복 프롬프트 재계산을 줄이고 응답 지연과 Throttling을 개선했습니다. 또한 system과 tools 문맥을 캐싱해 평균 응답 시간을 단축하고 비용도 절감했습니다.

AI 모델 개발에서 GPU를 효율적으로 쓰기 위한 HPC의 필요성과 기본 구성요소를 설명했습니다. Slurm, 공유 스토리지, 컨테이너를 통해 대규모 학습 환경을 일관되게 운영하는 방법을 소개했습니다.

RAG 시스템에서 문서 전처리가 검색 정확도를 좌우한다는 점을 설명했습니다. HTML, PDF, Excel, 이미지별로 적절한 정제와 로더 선택 방법을 정리했습니다.
셀러팀이 ChatGPT와 Cursor로 반복 업무와 데이터 분석을 자동화한 사례를 소개했습니다. 주간 지표 처리와 파일 생성 시간을 크게 줄이며 내부 툴로 확장하고 있습니다.
자동발주 예측 품질을 높이기 위해 품절률 급등 원인을 분석하고 권고발주를 자동발주로 점진 전환했습니다. TFT와 분위수 예측을 적용해 행사와 Capacity 변화에 더 잘 대응하며 품절률과 RMSE를 개선했습니다.
OpenAI Academy의 메뉴 구조와 역할별 학습 트랙을 빠르게 살펴본 글입니다. ChatGPT 활용, GPT-5 자료, Builders 리소스를 실무 관점에서 소개했습니다.