
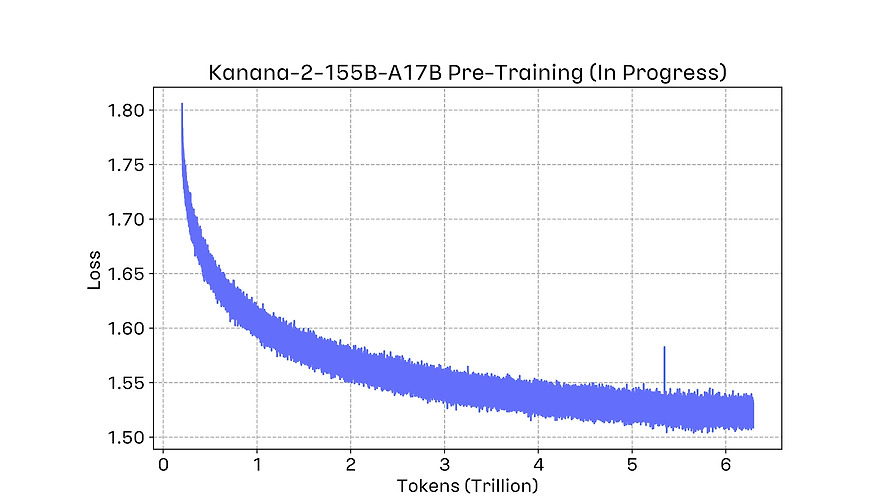
Kanana-2 개발기 (1): Pre-training에서의 의사결정들을 중심으로
카카오의 차세대 언어모델 Kanana-2의 Pre-training 개발 과정을 의사결정 중심으로 정리한 글입니다. 시리즈의 첫 글로서 이후 post-training 개선 내용으로 이어집니다.
#LLM#ML
6600
카카오의 차세대 언어모델 Kanana-2의 Pre-training 개발 과정을 의사결정 중심으로 정리한 글입니다. 시리즈의 첫 글로서 이후 post-training 개선 내용으로 이어집니다.
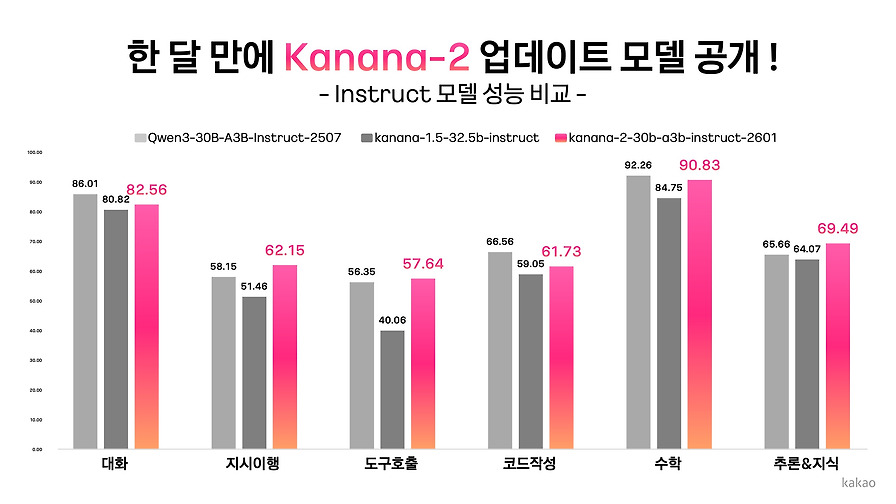
Kanana-2 개발기 시리즈의 두 번째 글로, 개선된 post-training recipe를 다룹니다. 다만 발췌만으로는 구체적 내용은 충분히 확인되지 않습니다.
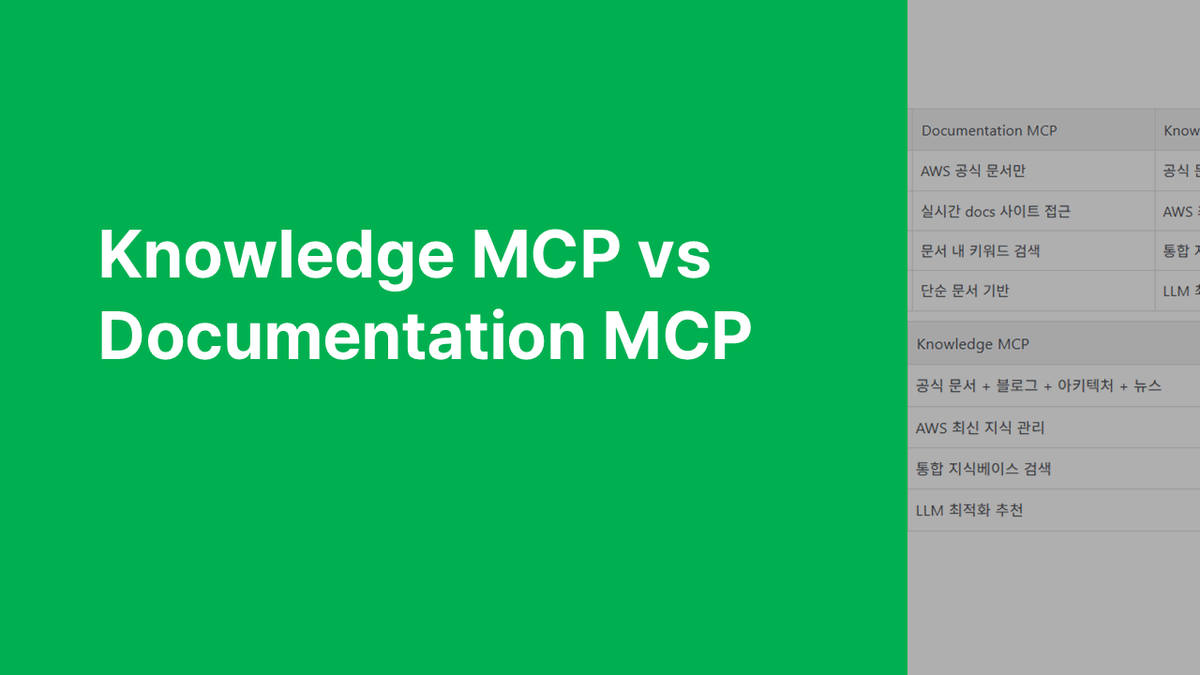
AWS Documentation MCP와 Knowledge MCP의 실행 방식, 정보 범위, 도구 기능을 비교했습니다. 최신 지식 탐색과 정확한 공식 스펙 검증에 두 서버를 병행 활용할 수 있습니다.
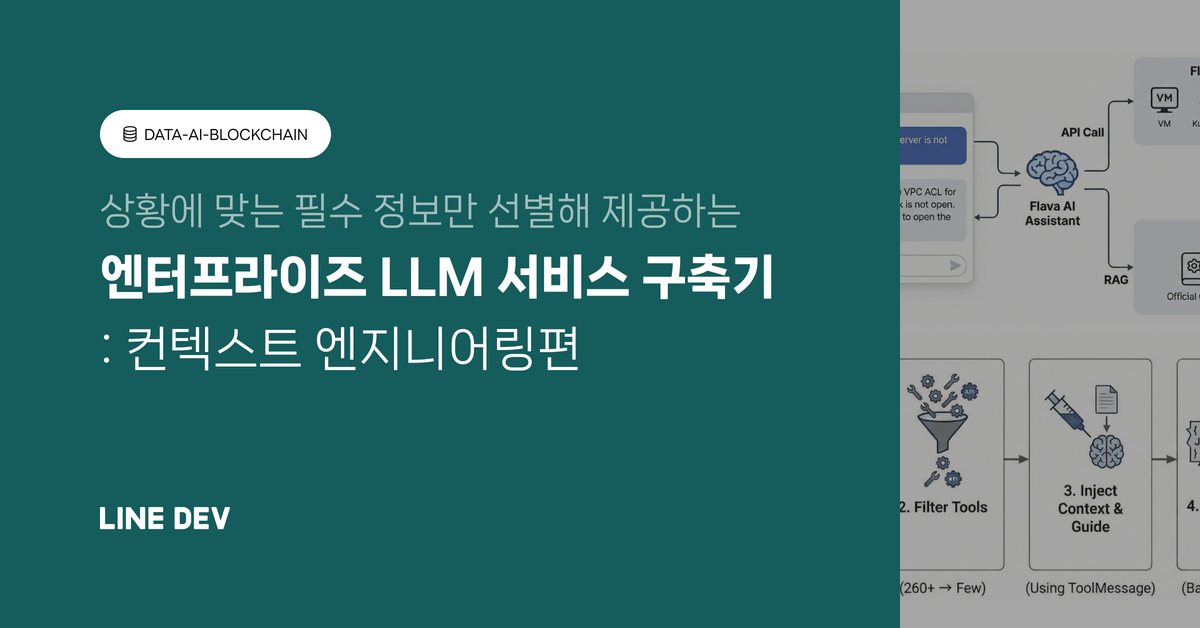
대규모 LLM 서비스에서 프롬프트보다 컨텍스트 설계가 더 중요하다는 점을 설명했습니다. 필요한 도구와 정보만 단계적으로 주입해 성능 저하와 환각을 줄인 방법을 공유했습니다.

Amazon MSK용 MCP 서버로 자연어 기반 Kafka 클러스터 관리 방식을 소개했습니다. 설치·권한 설정과 성능·보안 점검, 자동화 시 고려사항을 정리했습니다.
생성형 AI 시대에는 코딩보다 문제 정의와 검증의 중요성이 커졌습니다. AI를 잘 쓰는 조직일수록 판단과 책임의 역할을 더 분명히 해야 했습니다.

Amazon Bedrock의 TwelveLabs Marengo로 비디오를 멀티모달 임베딩으로 변환해 시맨틱 검색을 구현한 사례입니다. OpenSearch Serverless와 결합해 텍스트·이미지·오디오 질의로 관련 클립을 찾는 흐름을 소개했습니다.
다국어·다도메인 검색을 위해 BGE-M3를 도메인 파인튜닝하고 128차원 벡터 검색을 적용했습니다. LLM 기반 학습 루프와 임베딩 최적화로 검색 관련성과 CTR을 높였습니다.
Claude Code에서 컨텍스트가 길어질수록 응답 품질이 떨어지는 문제를 설명했습니다. CLAUDE.md, 프롬프트 간결화, 작업 분할, 내장 명령어로 컨텍스트를 관리하는 방법을 정리했습니다.

AI 에이전트 워크플로우를 자연어 SOP로 표준화하는 Strands Agent SOPs를 소개했습니다. 제어와 유연성의 균형, 체이닝, MCP·Claude Skills 연동 예시를 설명했습니다.

NeurIPS 2025에서 스케일링 이후의 AI 흐름과 동질화, 평가 한계를 살펴보았습니다. XAI와 Causality를 통해 설명과 인과를 구분해 보는 시사점도 정리했습니다.

NVIDIA Cosmos는 피지컬 AI를 위한 World Foundation Model로, 예측·전이·추론의 세 가지 모델을 제공합니다. 합성 데이터 생성과 검증을 통해 자율주행과 로봇 학습의 안전성과 효율성을 높였습니다.

CrewAI의 핵심 구성 요소와 독립형 Python 프레임워크 특성을 소개했습니다. 단일 에이전트와 멀티 에이전트 순차 협업 예시로 기본 사용 흐름을 설명했습니다.

Antigravity 사용 후기를 통해 무료 가격, 다양한 모델, Sync 코딩의 장점을 정리했습니다. 다만 영어 추론 토큰, 애매한 자율성, 멀티에이전트 안정성은 아쉬움으로 남겼습니다.