


RIMAN KOREA의 Amazon Bedrock Knowledge Bases를 활용한 자연어 기반 상품 검색 시스템 구축기
기존 상품명 중심 검색의 한계를 해결하기 위해 Amazon Bedrock Knowledge Bases 기반 자연어 검색 시스템을 구축했습니다. 하이브리드 검색과 메타데이터 필터링, 병렬 처리로 정확도와 응답 속도를 개선했습니다.
#Amazon Bedrock#검색
5800

기존 상품명 중심 검색의 한계를 해결하기 위해 Amazon Bedrock Knowledge Bases 기반 자연어 검색 시스템을 구축했습니다. 하이브리드 검색과 메타데이터 필터링, 병렬 처리로 정확도와 응답 속도를 개선했습니다.


GPU 수량 경쟁보다 풀스택 최적화가 AI 인프라 비즈니스의 핵심이라고 설명했습니다. 운영 효율과 총비용 관점에서 AI NIC와 베어메탈 아키텍처의 중요성을 짚었습니다.
챗GPT 이후 확산된 AI 저작권 소송과 미국 법원의 판단 기준을 다룬 글입니다. 다만 본문 접근이 불가해 세부 내용은 확인되지 않았습니다.

AI가 만든 PR의 동작 검증을 E2E와 데모 녹화로 자동화해 리뷰의 초점을 설계 판단으로 옮겼습니다. 또한 반복 실행 가능한 Acceptance 인프라와 그 한계까지 함께 정리했습니다.
Slack MCP와 Confluence MCP를 조합해 문의 대응과 사고 보고를 자동화하는 사내 워크숍을 소개했습니다. 실습과 스킬화를 통해 바로 업무에 적용할 수 있는 흐름을 공유했습니다.
AI 에이전트가 실제 업무에서 안전하고 일관되게 일하도록 돕는 하네스 엔지니어링을 설명했습니다. 프롬프트를 넘어 규칙, 도구, 검증, 관측 체계를 설계하는 방법을 정리했습니다.
업무용 LLM 봇에서는 모델보다 하네스가 더 중요하다는 점을 정리했습니다. 범위 설정, 근거 분리, 도구 실패 구분이 실제 운영 품질을 좌우했습니다.

Claude Code의 CLAUDE.md를 토큰 효율 중심으로 관리하는 방법을 정리했습니다. 컨텍스트 부패를 줄이기 위해 핵심 규칙만 남기고 Hook과 Skills로 분리하는 전략을 제안했습니다.
PR 리뷰의 첫 질문인 동작 확인을 E2E와 데모 녹화로 자동화했습니다. 그 결과 리뷰어가 설계와 구조 검증에 더 집중하도록 전환했습니다.
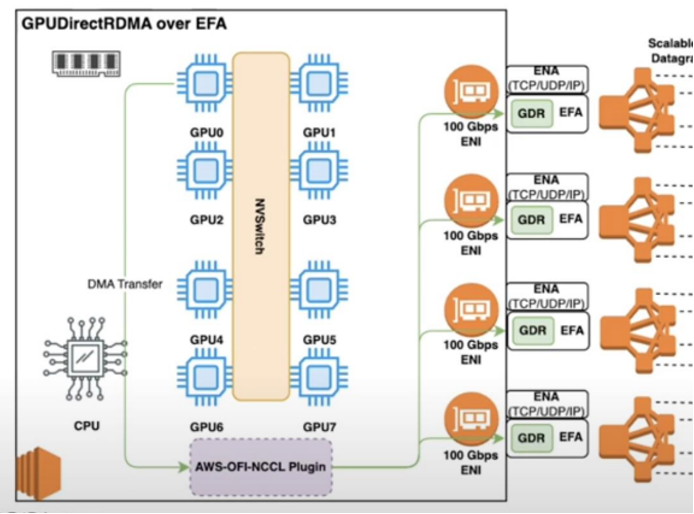
AWS 분산 트레이닝에서 GPU 간 통신 기술의 발전과 최적화 방향을 정리했습니다. MoE와 Dense 모델에 따라 NCCL, NVSHMEM, PPLX-kernels의 선택 기준을 설명했습니다.

Strands Agents와 AgentCore로 RDS for SQL Server 진단 스크립트를 에이전트화하는 방법을 소개했습니다. Deadlock과 Blocking을 조사하고 SNS 보고까지 자동화하는 흐름을 설명했습니다.
Slack 봇 창식이를 통해 하네스 엔지니어링과 컨텍스트/피드백 루프 설계를 실제 운영에 적용한 사례를 정리했습니다. MCP 채널, 지식 베이스, 교정 로그로 장기 작업의 정확도를 높인 구성이 핵심입니다.

LLM은 정답을 맞히는 능력만큼, 모를 때 멈추는 능력도 중요하다고 정리했습니다. 모델 크기나 추론 강화만으로는 부족해, 별도의 평가와 정렬 설계가 필요했습니다.

vLLM Tensor Parallelism으로 G5/G6의 24GB GPU 여러 장에 LLM을 분산 서빙하는 방법을 설명했습니다. 벤치마크에서 TP=4는 응답 속도와 처리량을 크게 개선했으며, 비용 효율적인 대안으로 제시했습니다.