
AI를 활용한 고용률 예측 모델 개발기(1)
AI를 활용한 고용률 예측 모델 개발기(1)
뉴스 정보를 이용해 고용률 변화를 예측하는 멀티모달 모델 개발 과정을 소개했습니다. 이번 글에서는 고용 기사 분류와 감정 분석을 위한 KoELECTRA 기반 설계를 다뤘습니다.
#LLM#NLP
800

뉴스 정보를 이용해 고용률 변화를 예측하는 멀티모달 모델 개발 과정을 소개했습니다. 이번 글에서는 고용 기사 분류와 감정 분석을 위한 KoELECTRA 기반 설계를 다뤘습니다.

SOFA·qSOFA의 사후 평가 한계를 보완하기 위해 패혈증 조기 예측용 VitalCare를 개발했습니다. 시계열·고정형 데이터를 결합한 RNN 모델과 임상시험 검증 과정을 소개합니다.
DenseNet 사전학습 모델의 분류기를 교체해 커스텀 이미지 분류 전이학습을 구현했습니다. 검증 기반 가중치 저장과 CSV·heatmap 시각화로 학습 결과를 관리했습니다.
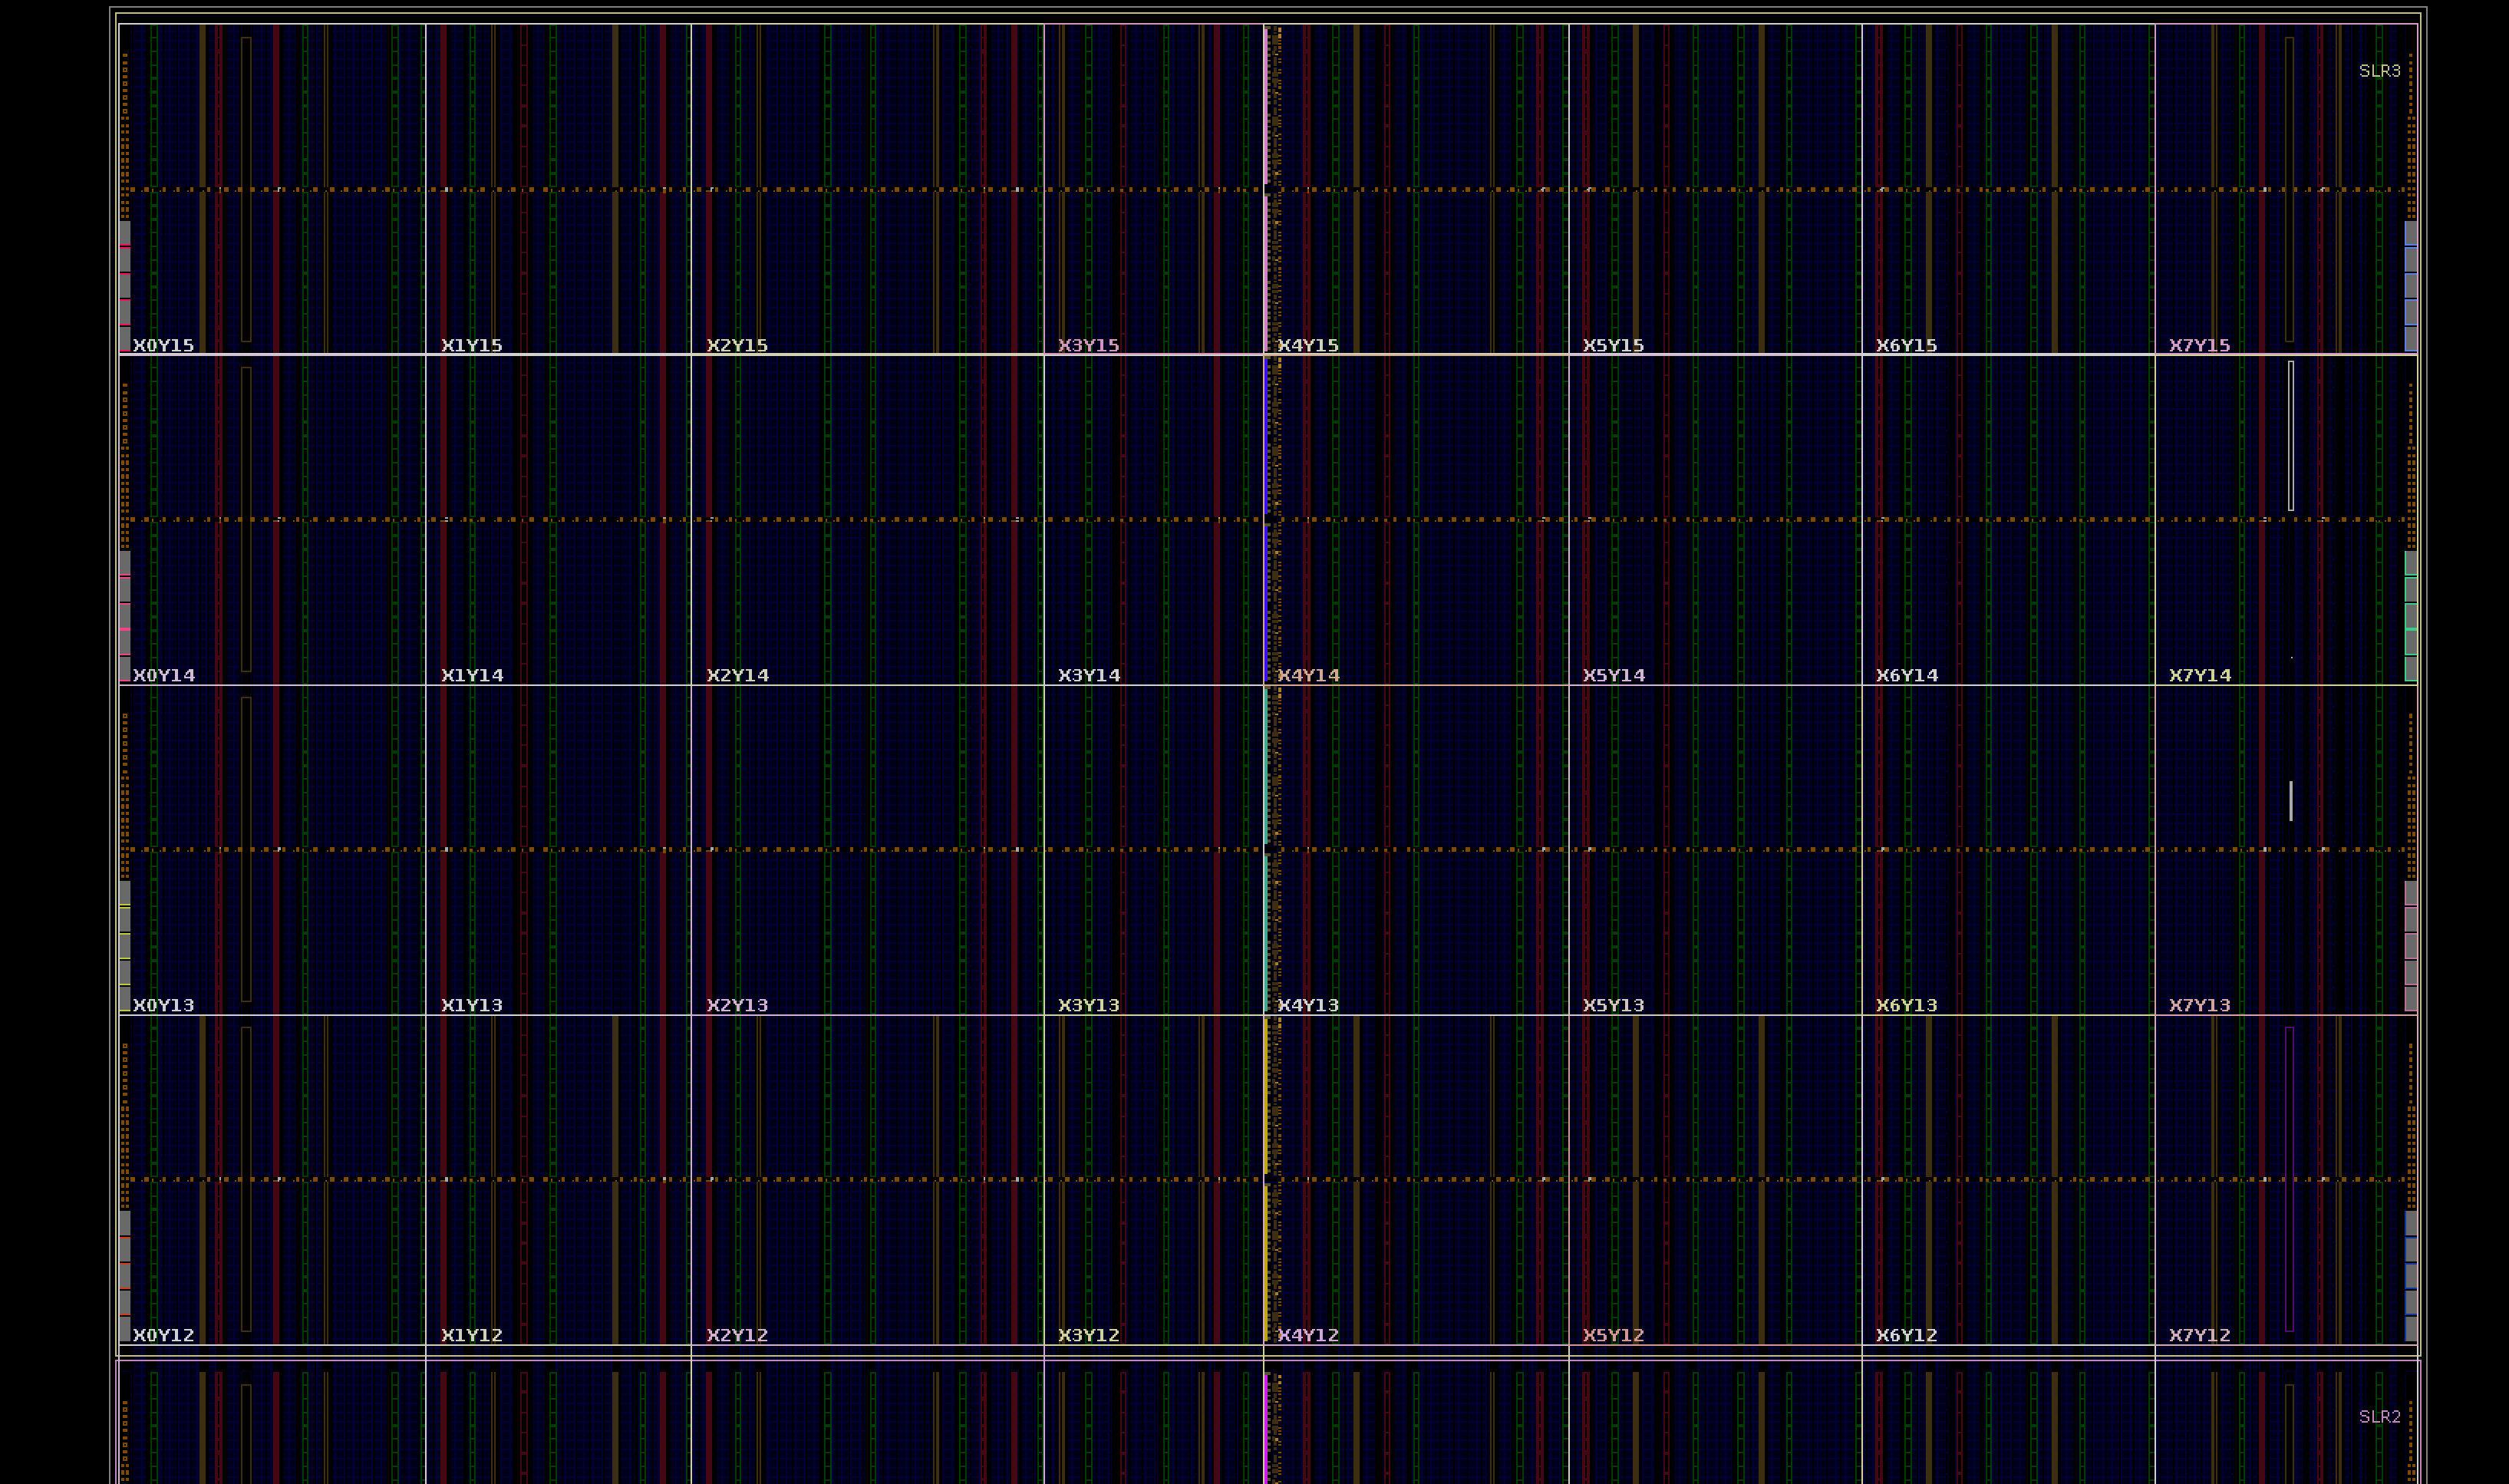
FPGA의 소자 배치를 강화학습으로 자동화하기 위한 환경과 에이전트 구조를 소개했습니다. Grid·Mask·보상·그래프 임베딩 설계에서의 도메인 특화 고려사항을 정리했습니다.
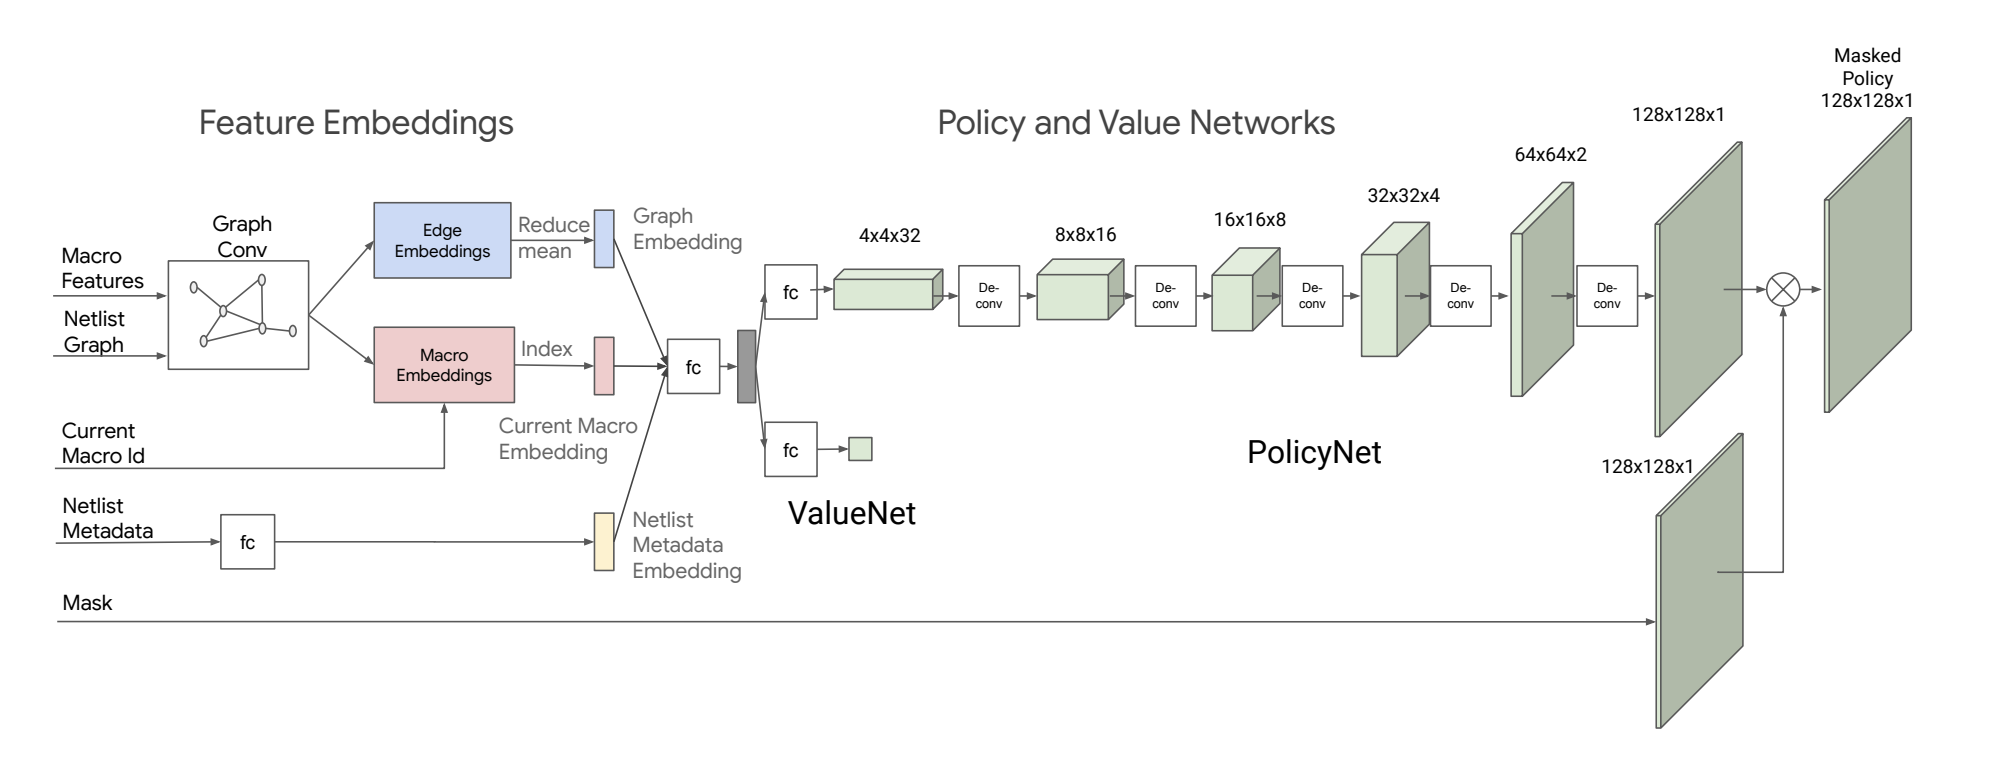
Chip Placement를 Hard Macro 순차 배치 MDP로 정의한 Google의 강화학습 방식을 소개했습니다. GNN 상태 인코딩과 Wire Length·혼잡도 보상으로 PPA 제약을 근사했습니다.
줌인터넷의 가짜뉴스 판별 특허를 소개하며 제목과 본문 불일치 기반 탐지 구조를 설명했습니다. 중요문단 추출 뒤 반의어·거리·도치 점수를 합산해 스팸뉴스 여부를 판단했습니다.
블록체인에서 공개 검증과 프라이버시 보호를 동시에 만족하기 위한 영지식 증명을 소개했습니다. NIZK와 zk-SNARK의 기본 용어, 동작 방식, 활용 사례를 함께 정리했습니다.

강화학습 퍼즐 봇으로 대규모 3매치 게임의 밸런싱 작업을 자동화했습니다. Mock 환경과 PPO 모델을 활용해 업데이트 영향과 캐릭터 성능을 사전 정량화했습니다.
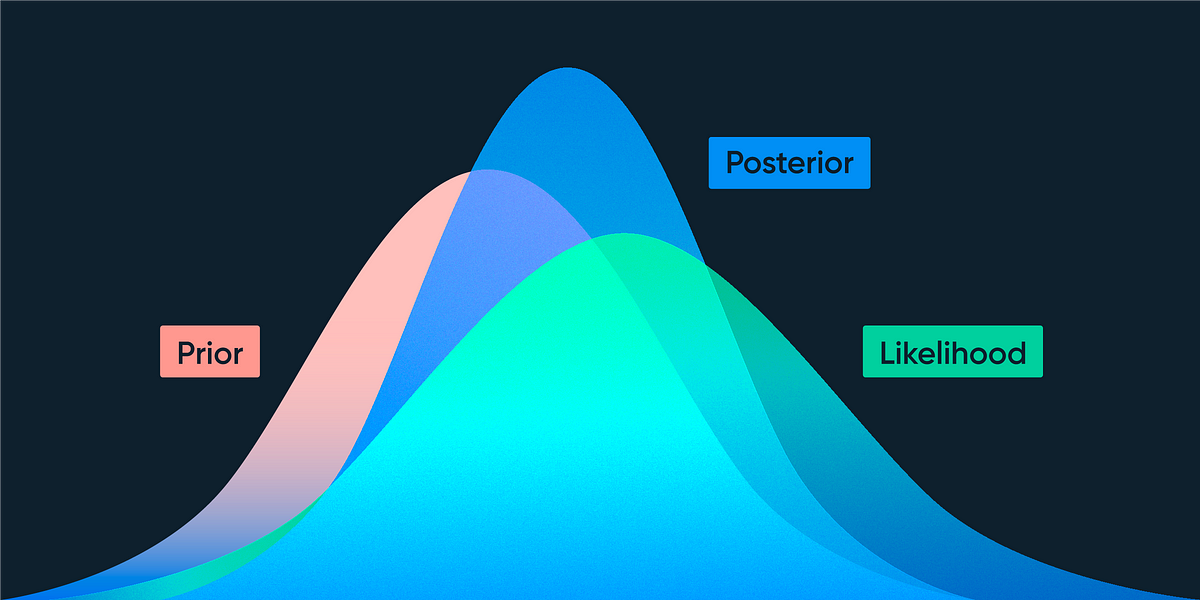
소규모·비균형 신약개발 데이터에서 발생하는 과잉확신 문제를 베이지안 딥러닝으로 다뤘습니다. GNN과 SWAG 등을 비교해 가상탐색 예측의 신뢰도와 불확실성 정량화 가능성을 확인했습니다.

TensorFlow 기반 N-gram 마스킹 위치 계산 병목을 C++ Custom Op으로 교체했습니다. 문장당 처리 시간을 4.697ms에서 17.147μs로 줄이며 약 250배 성능을 개선했습니다.
2020 인공지능 그랜드 챌린지 행동인지 트랙 참가 과정을 정리한 글입니다. 이미지 탐지 기반 접근과 데이터 보강, 설정 조정으로 최종 1위를 달성했습니다.
AI 아나운서 개발 과정과 데이터 전처리, TTS·STF 기반 모듈 구성을 소개했습니다. 프로토타입은 높은 품질을 보였지만 데이터 효율성과 전용 TTS 고도화가 과제로 남았습니다.

PyTorch 리서치와 TensorFlow Serving 배포를 병행한 모델 운영 방식을 소개했습니다. 양방향 가중치 변환과 결과 비교 테스트, 레이어별 차이 대응 방법을 정리했습니다.

신약개발의 방대한 화합물 탐색을 효율화하는 AI 활용 방안을 소개했습니다. 베이지안 딥러닝과 분자 그래프, 물리 기반 계산의 보완적 활용을 다뤘습니다.