
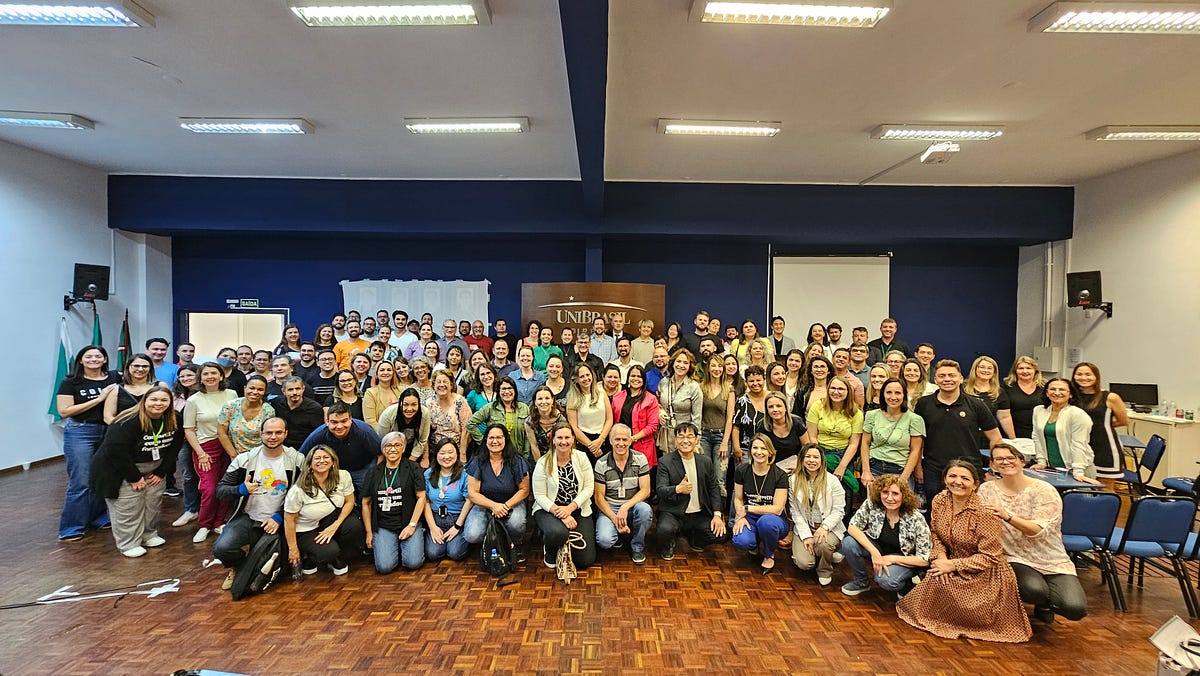
문제 생성 AI 서비스 Quizium, 브라질 출장에서 100명의 현지 교사들에게 소개하며
브라질 파라나주에서 Quizium을 100명의 교사들에게 소개하고 시연했습니다. 현지 피드백을 바탕으로 제품 개선과 글로벌 교육 혁신 방향을 점검했습니다.
#LLM#RAG
1900

브라질 파라나주에서 Quizium을 100명의 교사들에게 소개하고 시연했습니다. 현지 피드백을 바탕으로 제품 개선과 글로벌 교육 혁신 방향을 점검했습니다.
Node.js 애플리케이션에 OpenTelemetry를 붙여 Grafana Tempo로 트레이스를 수집하는 방법을 소개했습니다. 자동 계측과 수동 span, 분산 추적 활용 가능성도 함께 설명했습니다.

생성형 VLM과 멀티턴 이미지 대화 데이터를 구축해 포토챗의 문맥 이해를 개선했습니다. 언어 모델 고정과 이미지-캡션 사전학습으로 리트리벌 모델보다 높은 성능을 확인했습니다.

vLLM의 PagedAttention과 Continuous Batching을 코드 흐름 중심으로 분석했습니다. KV 캐시 블록 관리, 스케줄링, CUDA 기반 Single Query Attention을 설명합니다.
SK플래닛의 클라우드 기반 검색 시스템 구조와 주요 기능을 소개했습니다. 또한 ChatGPT 이후 대화형 검색으로의 확장 가능성을 함께 살펴봤습니다.
SK플래닛의 Elasticsearch 기반 공용 검색 시스템 구조와 기능을 소개했습니다. 또한 ChatGPT 이후 대화형 검색으로의 확장 가능성을 함께 살펴보았습니다.
한국어 음성 4건으로 VITO·Clova·Google STT 전사 결과를 CER로 비교했습니다. VITO API가 평균 CER 6.32%로 가장 낮았으며, 제한된 샘플 기반 결과임을 함께 언급했습니다.
TypeScript 기반 React·Express 환경에서 VITO 파일 STT API 연동 과정을 안내했습니다. 인증, 파일 업로드, 폴링 기반 결과 조회와 커스텀 훅 리팩터링을 다뤘습니다.
TypeScript 기반 Express 서버에서 VITO 파일·스트리밍 STT API 연동 방법을 안내했습니다. 파일 전사 polling과 WebSocket 청크 전송, 결과 반환 흐름을 다뤘습니다.
게임 유저를 활동력과 구매력 기준으로 분류하는 BigQueryML 기반 모델 개발 사례를 소개했습니다. 주기적 학습·서빙 자동화와 대시보드 제공으로 마케팅 활용도를 높였습니다.

INTERSPEECH 2023 참가와 포스터 발표 경험을 중심으로 음성 언어 처리 연구 동향을 정리했습니다. 데이터 부족, 음성 모델 활용, 벤치마크의 중요성을 다시 확인했습니다.
쿠팡의 머신러닝 플랫폼이 개발부터 배포, 모니터링까지 전 과정을 어떻게 지원하는지 소개했습니다. 노트북, 피처 스토어, 분산 학습, 추론 서빙, 하이브리드 클러스터 운영이 핵심입니다.
NAVER GLACE AI 개발팀의 서비스 적용 사례와 운영 체계를 소개했습니다. 또한 PlaceLM을 중심으로 태그 추출과 서빙 효율 개선 방향을 설명했습니다.

해외 감성 AI 사례와 국내 팬덤·크리에이터 서비스의 접목 가능성을 분석했습니다. 몰입감 있는 관계 형성과 함께 어색한 모방, 과몰입 위험도 함께 짚었습니다.