


비정형 데이터! Amazon Bedrock으로 제대로 활용하기
Amazon Bedrock의 비정형 데이터 처리 기능과 활용 사례를 정리했습니다. 멀티모달 처리와 GraphRAG로 RAG 품질을 높이는 방법을 소개했습니다.
#AWS#Amazon Bedrock
4200
Amazon Bedrock의 비정형 데이터 처리 기능과 활용 사례를 정리했습니다. 멀티모달 처리와 GraphRAG로 RAG 품질을 높이는 방법을 소개했습니다.

배달의민족은 GPT와 RAG를 활용해 상품 카탈로그 속성값 생성 자동화를 시도했습니다. 평가 모델을 보완해 작업 효율을 높이고 정확도도 개선했습니다.
Amazon Bedrock과 Amazon Neptune으로 GraphRAG 애플리케이션을 구축하는 방법을 소개했습니다. LlamaIndex와 NL2GraphQuery를 활용해 지식 그래프 검색과 개인화 추천을 연결했습니다.

SK하이닉스가 AWS 환경에서 RAG 플랫폼을 구축하고 성능을 평가한 사례를 소개했습니다. 데이터셋 크기와 인덱스 메모리가 검색 지연과 TTFT에 미치는 영향을 분석했습니다.

자동차 매뉴얼 검색을 위한 도메인 특화 RAG 데모 시스템을 개발했습니다. LLM과 메타 정보를 결합해 출처가 보이는 응답과 더 나은 사용자 경험을 제공했습니다.

LLM 파인튜닝에서 Optimizer, 학습률, 스케줄러, Warmup, 정밀도 선택 기준을 실험 결과로 정리했습니다.메모리와 안정성을 함께 고려해 AdamW 계열과 BF16, 1e-4 근처 학습률을 중심으로 검증하는 방법을 제시했습니다.

사내 AI 챗봇 서비스를 Next.js 템플릿 기반으로 구축하고, Azure OpenAI와 GraphQL 도구 연동을 확장한 과정을 공유했습니다. 배포와 필터링, 컨텍스트 초과 같은 문제를 해결하며 내부 구성원용 서비스로 운영한 사례입니다.
AWS re:Invent 2024에서 공개된 AI 개발 도구의 최신 업데이트를 정리한 글입니다. 행사의 2편으로, 개발자 관점에서 확인할 만한 변화들을 소개합니다.
밸런스히어로가 국제 금융 데이터 사이언스 대회에서 2위를 수상했습니다. 대안신용평가시스템(ACS)의 기술력과 다른 지역으로의 확장 가능성을 입증했습니다.
AWS re:Invent 2024에서 소개된 금융 회사의 생성형 AI 구축 사례를 다룬 글입니다. AWS 기반 적용 사례의 개요를 간단히 소개했습니다.

DeepSeek-R1의 강화 학습 기반 추론 향상 방식과 지식 증류 전략을 정리했습니다. 또한 API 활용, 소형 모델 성능, 향후 개선 과제까지 함께 살펴봤습니다.
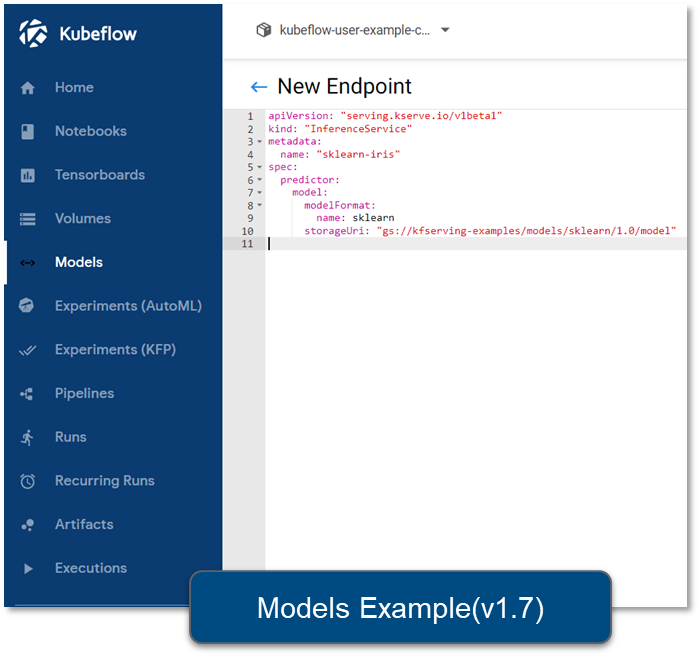
Kubeflow의 개념을 소개하는 글입니다. MLOps 관점에서 Kubeflow가 무엇인지 간단히 안내했습니다.

GPU 메모리 사용을 줄이기 위한 그레이디언트 누적, 체크포인팅, ZeRO, LoRA, QLoRA를 정리했습니다. 각 기법이 절감하는 메모리 영역과 적용 효과를 예시와 함께 설명했습니다.
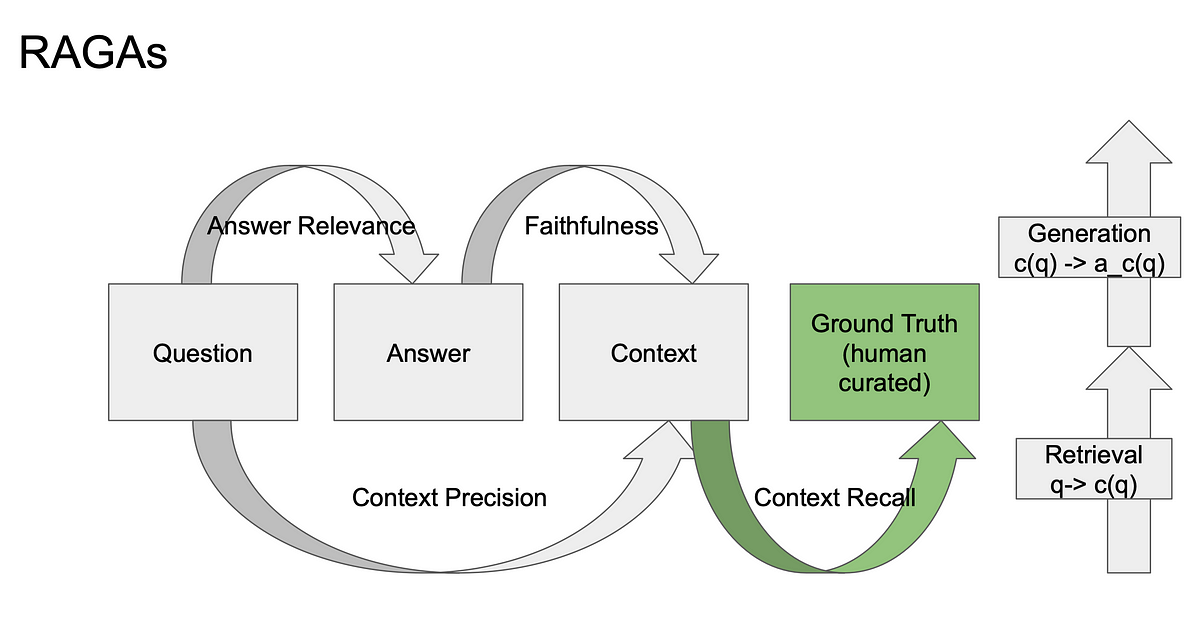
생성형 검색(RAG) 평가의 최근 트렌드와 주요 플랫폼, 지표 변화를 정리했습니다. LC와 RAG의 비교 결과를 통해 질문 유형별 적합한 접근도 살펴봤습니다.