
데이터사이언스팀이 예측모델을 개발하고 운영하는 방법을 소개합니다.
데이터사이언스팀의 예측모델 개발·운영 구조와 MLOPS 기반 서빙 체계를 소개했습니다. 또한 배포 후 대응, 성능 분석, Leakage 주의 등 실무에서 배운 점을 정리했습니다.
#ML#MLOps#Airflow
3200
데이터사이언스팀의 예측모델 개발·운영 구조와 MLOPS 기반 서빙 체계를 소개했습니다. 또한 배포 후 대응, 성능 분석, Leakage 주의 등 실무에서 배운 점을 정리했습니다.
컬리는 배치 피킹 물류센터의 생산 계획을 유전 알고리즘으로 최적화하는 논문을 발표했습니다. 고유 상품 수가 적은 배치 계획을 탐색해 현장 생산성 향상을 검증하고 있습니다.

확률적 작업자 행동을 MLE·회귀분석으로 추정해 물류센터 Digital Twin을 구축했습니다. 유전 알고리즘의 처리 시간 감소와 실제 현장 상품 가짓수 감소를 검증했습니다.

도구 분산으로 커진 ML 실험 환경의 복잡성을 해결하기 위해 Kubeflow를 도입했습니다. Elyra, S3·IRSA, SealedSecrets 기반의 운영 설정과 보안 관리 팁을 공유합니다.
Kubernetes 기반 MLOps 환경에서 GPU 자원 운영 부담을 줄이기 위한 기반을 설계했습니다. Karpenter와 NVDP로 GPU 노드의 자동 생성·회수 흐름을 구성했습니다.

QPS 생산성을 바구니 처리 속도로 정의하고, 고유 상품 수 최소화 문제로 전환했습니다. 유전 알고리즘 적용으로 기존 방식보다 고유 상품 수를 약 10% 이상 줄였습니다.
후기 이미지 분류 모델 재훈련을 위해 이미지 정제와 수작업 라벨링 방식을 비교했습니다. SageMaker Ground Truth의 협업 장점과 대규모 작업 비용 부담을 검토했습니다.
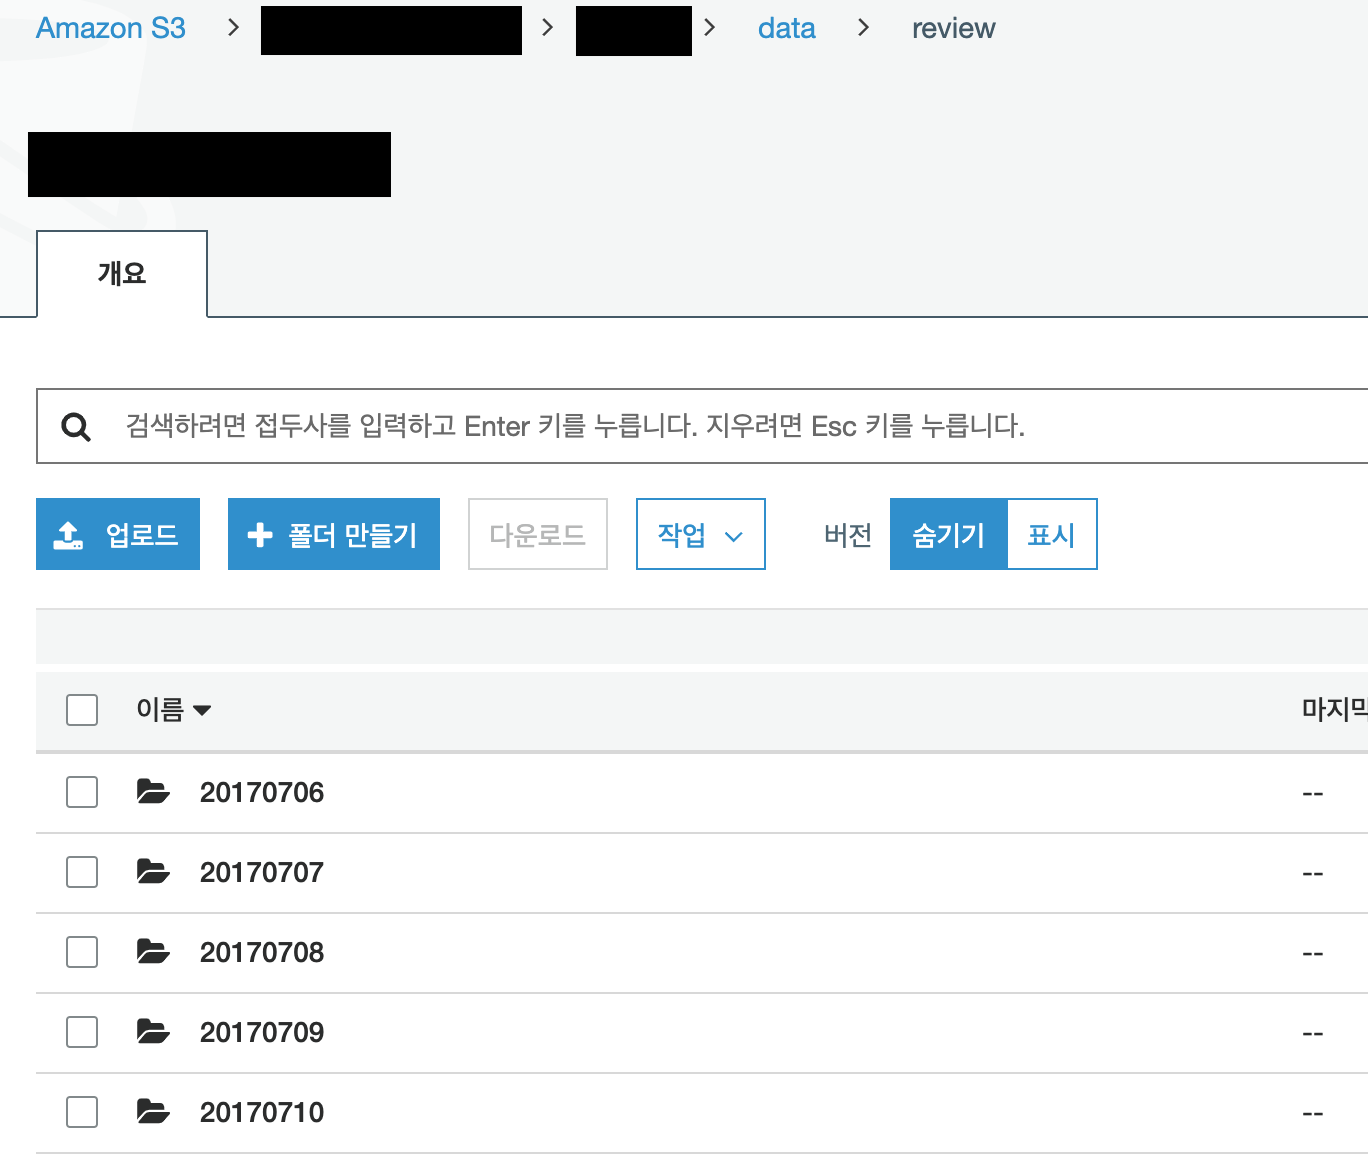
훈련 이미지의 중복·손상 파일을 정리하고 수작업 분류 방식들을 비교했습니다. SageMaker Ground Truth로 협업 분류를 검토했지만 높은 과금이 도입 장벽이었습니다.