

Slack 대화 한 번으로 끝나는 CDC 파이프라인 온보딩
Slack 대화 한 번으로 끝나는 CDC 파이프라인 온보딩
Slack 대화만으로 CDC 파이프라인 온보딩을 처리하는 AI Agent 사례를 소개했습니다. LangChain/LangGraph와 MCP를 연결해 반복 절차를 자동화한 구성입니다.
#LangChain#LangGraph
5400
새로운 기술 블로그가 추가되었어요
Slack 대화만으로 CDC 파이프라인 온보딩을 처리하는 AI Agent 사례를 소개했습니다. LangChain/LangGraph와 MCP를 연결해 반복 절차를 자동화한 구성입니다.
의료 전자기록 데이터는 전처리와 평가 기준이 복잡해 모델 재현성이 낮았습니다. Clairvoyance는 이를 표준화하는 파이프라인 툴로 개발·평가·최적화를 돕습니다.
대출 심사 로직의 복잡도를 줄이기 위해 Pipeline, Job, Store 구조를 적용한 사례를 소개했습니다. 정책 변경과 테스트를 더 쉽게 만들기 위한 설계 고민을 정리했습니다.
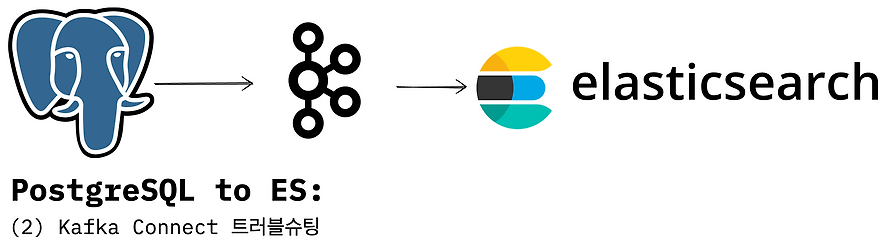
PostgreSQL에서 ES로의 CDC 파이프라인을 Kafka Connect로 구성한 뒤의 트러블슈팅 글입니다. 제공된 본문만으로는 구체적 문제와 해결 내용은 확인되지 않습니다.
CDC 파이프라인 정합성 검사 Spark 잡의 최적화 방법을 다룬 후속 글입니다. 앞선 코드 설계편에 이어 Spark 잡 성능 개선과 운영 관점을 소개했습니다.
시계열 분석용 AI 모델 개발에서 전처리와 훈련 자동화를 위한 MLOps 파이프라인 구축 경험을 소개했습니다. 상세 본문은 확인되지 않아 핵심 주제만 파악할 수 있었습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
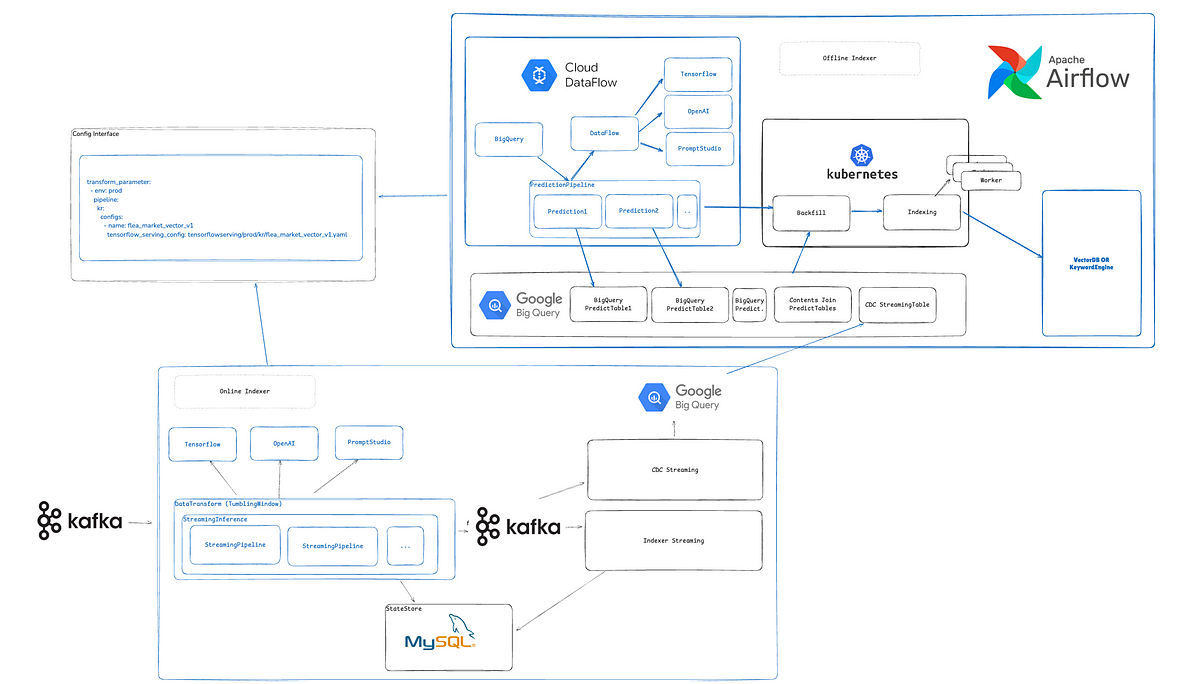
검색 색인 파이프라인의 생산성과 안정성을 높이기 위해 설정 기반 자동화, Offline Storage 활용, 배치 처리 구조를 도입했습니다. 이를 통해 대용량 이벤트와 풀색인 비용 문제를 줄이고 운영 효율을 개선했습니다.

GitLab Secret Detection으로 리포지터리의 시크릿 유출을 자동 탐지하는 방법을 소개했습니다.\nPipeline 설정, 전체 히스토리 스캔, 취약점 리포트 활용까지 실무 적용 흐름을 정리했습니다.


허깅페이스 Trainer API로 KLUE/ynat 텍스트 분류 모델을 학습하고 평가하는 과정을 정리했습니다. 또한 학습한 모델을 허브에 업로드하고 pipeline으로 추론하는 방법도 함께 소개했습니다.

웹 기반 배치 생성 툴 FAST로 데이터 파이프라인 작성 과정을 단순화했습니다. 비개발자도 입력값만 채워 Airflow 배치를 만들고, 운영 공수도 줄였습니다.
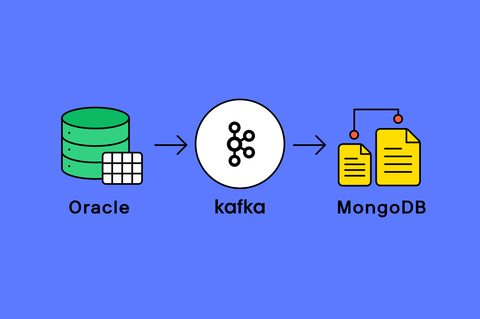
Oracle에서 MongoDB로 초기 데이터 이관과 CDC 파이프라인 구축 경험을 공유했습니다. 관계형 DB에서 문서형 DB로의 변경 데이터 연동 흐름을 다뤘습니다.
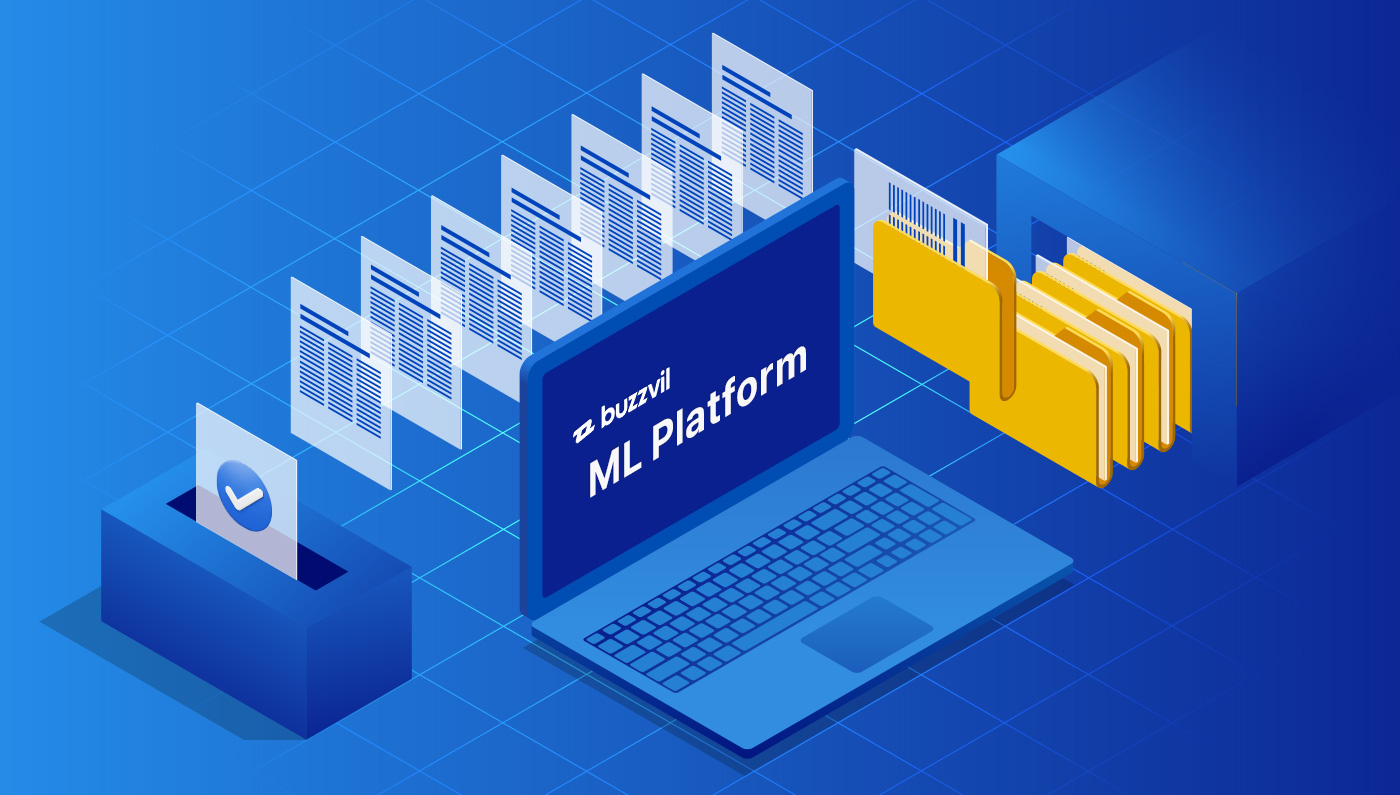
버즈빌의 머신러닝 플랫폼 Buzzflow를 소개하며, 모델 개발과 관리를 위한 파이프라인과 저장소 구성을 설명했습니다. 모델 배포 방식은 다음 글에서 이어서 다룰 예정입니다.
다나와 상품 색인 파이프라인을 logstash로 이관해 유지보수성을 높이고 MQ 의존성을 줄였습니다. 1G 로그 처리 테스트에서는 기존 대비 처리 시간이 크게 줄어 성능 개선도 확인했습니다.
셀프 서빙 데이터 플랫폼을 구축한 사례를 소개했습니다. Airflow를 활용해 데이터 파이프라인 운영 부담을 줄이는 방향을 다뤘습니다.