

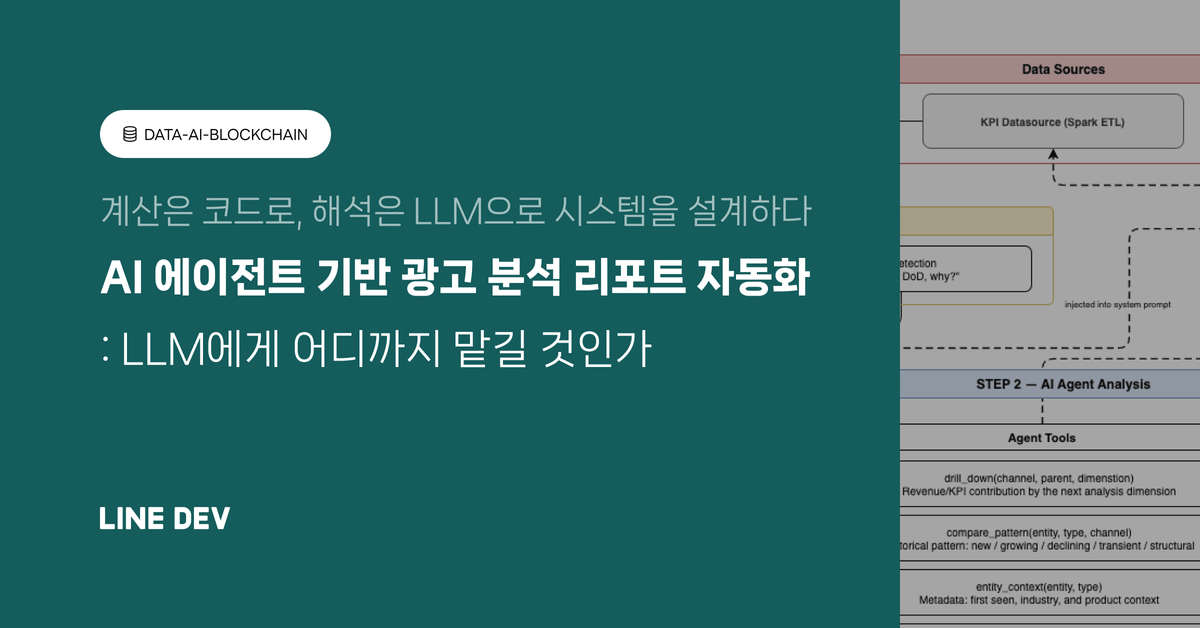
LLM에게 어디까지 맡길 것인가: AI 에이전트 기반 광고 분석 리포트 자동화
AI 에이전트로 광고 분석 리포트를 자동 생성하되, 계산과 해석을 분리해 신뢰성을 높였습니다. 섹션별 컨텍스트 분리와 평가 루프로 품질을 운영 가능하게 만들었습니다.
#LLM#AI 에이전트
4500
새로운 기술 블로그가 추가되었어요
AI 에이전트로 광고 분석 리포트를 자동 생성하되, 계산과 해석을 분리해 신뢰성을 높였습니다. 섹션별 컨텍스트 분리와 평가 루프로 품질을 운영 가능하게 만들었습니다.


흩어진 클라우드 운영 데이터를 하나의 기준으로 모으기 위해 레이크하우스 기반 통합 플랫폼 Deck 구축 과정을 소개했습니다. Object Storage를 SSOT로 두고 레이어를 분리해 과금과 분석의 신뢰성을 높였습니다.


Trino는 빠른 실시간 분석과 멀티 소스 조인에 적합하고, Spark는 대규모 배치와 ETL에 유리하다고 설명했습니다. 두 엔진을 역할 분담하는 하이브리드 전략과 Trino의 운영 한계도 함께 정리했습니다.
Apache Pinot를 실시간 OLAP 용도로 도입해 운영하며 얻은 안정성·보안·DR 노하우를 정리했습니다. Upsert, Kafka 재개, Trino gRPC 등 실무에서 겪은 주의점과 대응 방법도 함께 소개했습니다.
Elasticsearch 기반 로그 저장 구조의 비용과 확장성 한계를 해결하기 위해 Iceberg 기반 Alaska를 도입했습니다. Kafka 로그를 오브젝트 스토리지에 직접 적재하고, 실시간 조회와 장기 보관을 분리해 운영 효율을 높였습니다.
로그 누적으로 발생한 대시보드 타임아웃과 slow query 문제를 Trino 도입으로 개선한 사례를 다뤘습니다. OBS와 Parquet, MySQL tier down 구조를 통해 집계 성능과 저장 효율을 함께 고려했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

YARN 환경의 Trino 리소스를 재조정해 장비 증설 없이 가용 메모리를 늘리는 과정을 정리했습니다. AM Container와 RESERVED Resource를 고려해 Worker 중심으로 설정을 최적화했습니다.
SK플래닛이 오픈소스 Trino를 전사 분석 엔진으로 도입해 실시간 데이터 조회 환경을 구축했습니다. 운영계 데이터 접근성과 소용량 쿼리 성능을 높이고 리포트 주기도 단축했습니다.