하나의 데이터, 멀티 엔진: Apache Iceberg로 구축하는 데이터레이크
Redshift 단일 클러스터의 적재 지연과 리소스 경합 문제를 해결하기 위해 Iceberg 기반 데이터레이크를 구축했습니다.\nGCS, BigLake Metastore, Spark, BigQuery를 분리해 멀티 엔진 운영과 벤더 종속 완화를 노렸습니다.
새로운 기술 블로그가 추가되었어요

Redshift 단일 클러스터의 적재 지연과 리소스 경합 문제를 해결하기 위해 Iceberg 기반 데이터레이크를 구축했습니다.\nGCS, BigLake Metastore, Spark, BigQuery를 분리해 멀티 엔진 운영과 벤더 종속 완화를 노렸습니다.


에이전트 서비스의 실행 이력과 툴 매핑을 DynamoDB, Redshift, Valkey로 나눠 설계하는 방법을 설명했습니다. 액세스 패턴 기반 스키마와 분석·캐시 구조로 성능과 추천 정확도를 높이는 방향을 제안했습니다.


YAML 템플릿과 Airflow 팩토리 패턴으로 셀프 서빙 데이터 파이프라인을 구축했습니다.\n파티셔닝·의존성·멱등성을 추상화해 데이터 엔지니어 의존도를 낮췄습니다.


매드업의 DMP 프리즘 구조와 운영 경험을 소개한 글입니다. V1의 한계를 바탕으로 V2에서 비동기화, 매니지드 서비스, RA3 전환을 통해 개선한 내용을 설명했습니다.


화해는 분산된 원천 데이터를 Redshift Data Lake와 BigQuery DW로 이관·구축했습니다. 반정규화 FACT 테이블과 데이터 카탈로그로 분석 효율과 지표 일관성을 높였습니다.


Athena와 Redshift 직접 조인의 비용·성능 문제를 데이터마트로 완화하려 했습니다.\nPostgreSQL dblink와 자동 생성 프로시저로 Redshift 데이터를 선별 동기화했습니다.


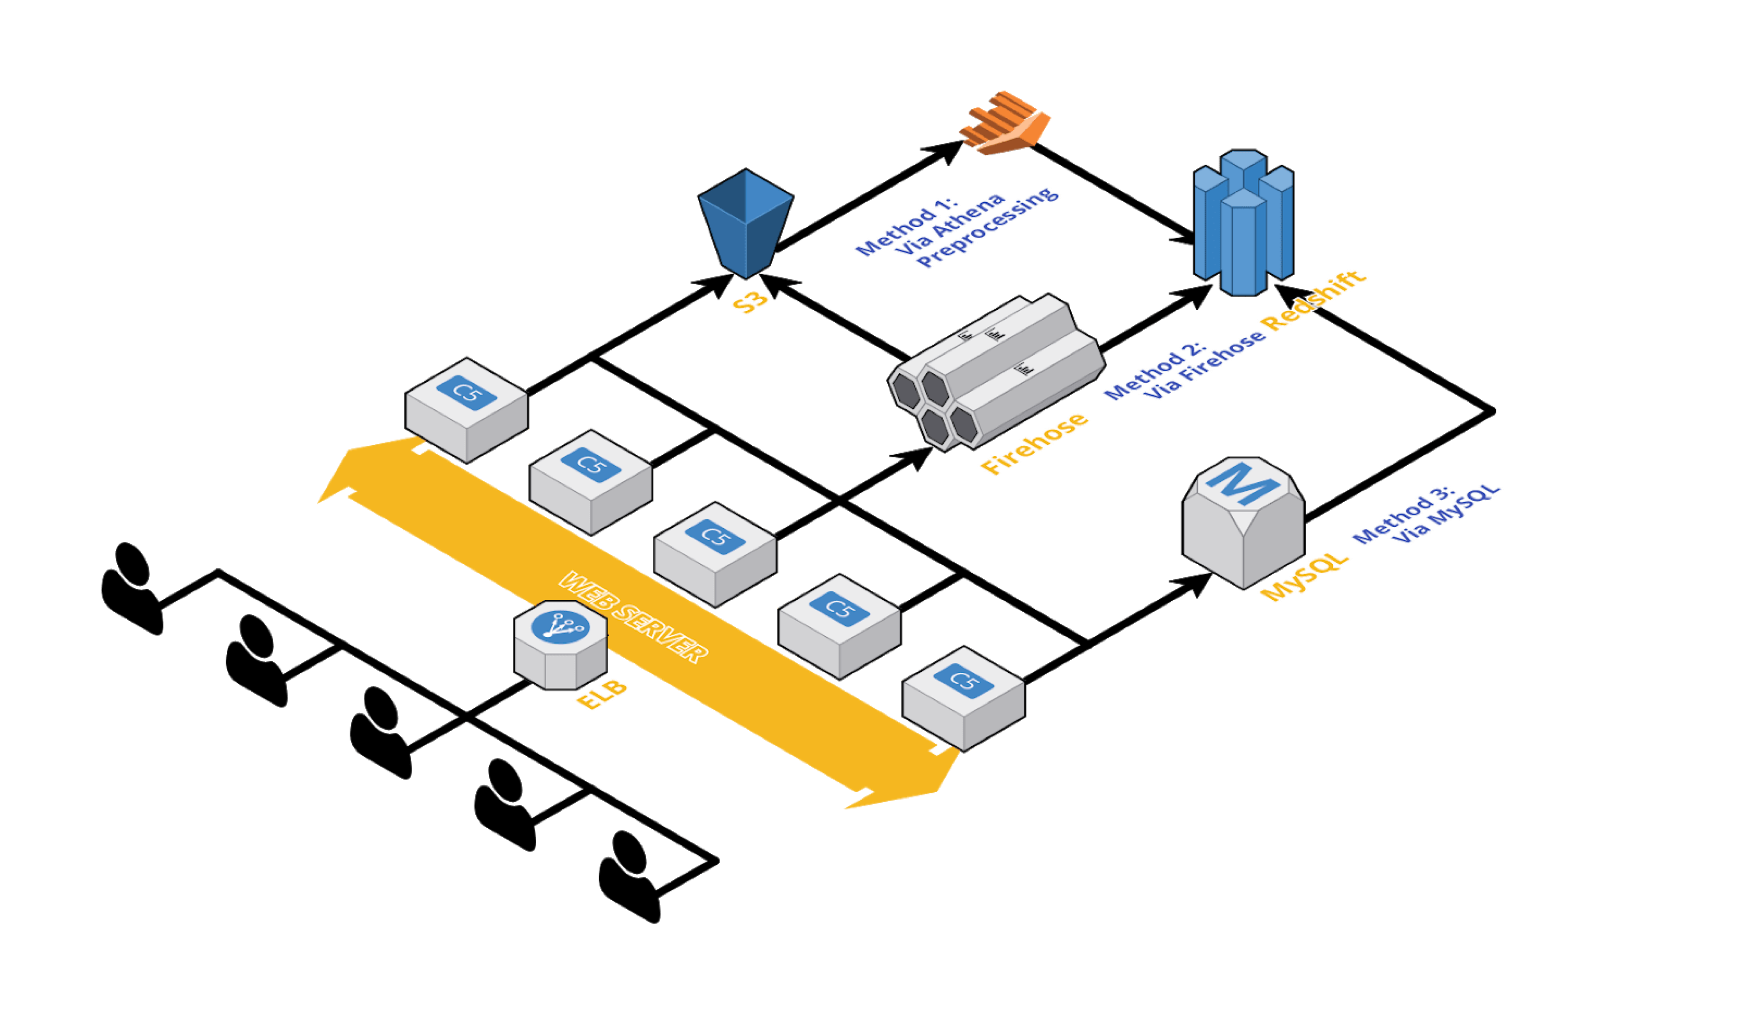
여러 저장소에 분산된 사용자·광고 활동 데이터를 Redshift로 통합하는 파이프라인을 소개했습니다. 컬럼형 저장, 빠른 적재, 수평 확장성을 핵심 선택 이유로 설명합니다.