

로그가 서비스를 죽였다
로그가 서비스를 죽였다
동기 stdout 로깅이 커넥션 풀 고갈과 요청 실패로 이어진 원인을 분석했습니다. caller에서 추적 ID를 캡처해 비동기 로깅과 관측성을 함께 유지했습니다.
#logging#OpenTelemetry
5900
새로운 기술 블로그가 추가되었어요
동기 stdout 로깅이 커넥션 풀 고갈과 요청 실패로 이어진 원인을 분석했습니다. caller에서 추적 ID를 캡처해 비동기 로깅과 관측성을 함께 유지했습니다.

OpenTelemetry와 ClickHouse로 APM 스캐터 차트를 만들고 Grafana 커스텀 패널로 10만 점 산점도를 그린 사례를 다뤘습니다. 구현 후 드러난 함정 3가지와 대용량 시각화 시 점검 포인트를 정리했습니다.
OpenTelemetry로 APM 데이터를 수집하고 ClickHouse에 저장해 스캐터 차트를 만드는 과정을 소개했습니다. 1편에서는 수집과 저장 단계에 초점을 맞췄습니다.

ZEP의 교육용 퀴즈 생성 아키텍처를 LangGraph와 Amazon Bedrock AgentCore Runtime 중심으로 설명했습니다. 하나의 그래프를 실시간 서빙과 배치 생성에 재사용하고 관측 체계까지 분리해 운영하는 방식입니다.


Cloud Native 운영에서는 모니터링만으로 원인을 찾기 어려워 Observability와 데이터 연결이 중요합니다. kt cloud는 AI가 활용할 수 있는 운영 데이터와 접근 통제 구조를 함께 설계했습니다.

Amazon CloudWatch의 네이티브 OpenTelemetry 지표 수집과 PromQL 지원을 소개했습니다. EKS, Grafana, 애플리케이션 지표를 하나의 파이프라인과 쿼리 언어로 통합하는 방법을 설명했습니다.
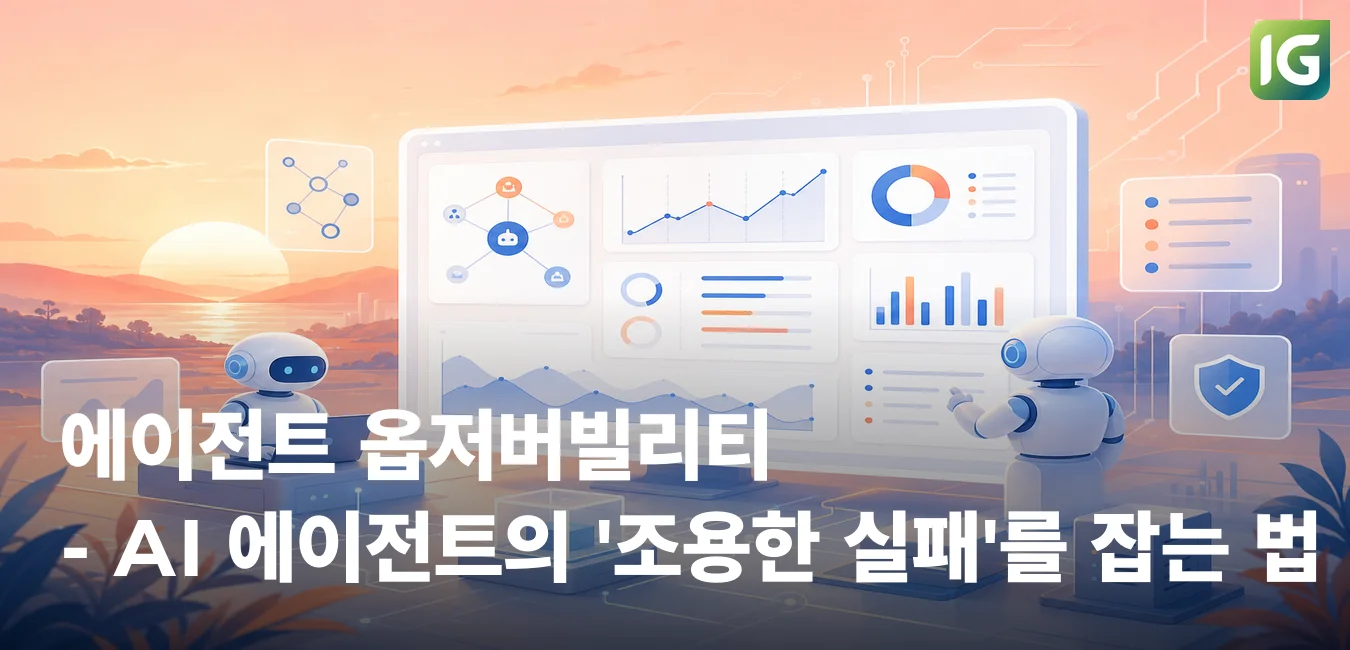
AI 에이전트의 조용한 실패를 잡기 위한 에이전트 옵저버빌리티 개념과 APM·LLM 옵저버빌리티와의 차이를 정리했습니다. Langfuse와 Gemini로 PR 리뷰 에이전트를 추적·평가하는 실습과 운영 시 유의사항도 다뤘습니다.


MSA 로컬 개발의 병목을 줄이기 위해 Rewrite Host로 수정 중인 서비스만 노트북 인스턴스로 교체하는 방식을 소개했습니다. 디버그 헤더와 응답 피드백으로 부분 검증과 라우팅 전환을 단순화했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
Kubernetes Pod의 Request와 Limit을 실제 사용 패턴에 맞게 조정하는 Right-Sizing 기준 수립 과정을 다뤘습니다. P95, 버퍼율, 컴포넌트 특성, Throttling 지표를 함께 고려하는 방법을 정리했습니다.
Hexagonal Architecture 기반의 일관된 구조가 멀티클라우드, AI 백엔드, Observability 전환의 기반이 되었다고 설명했습니다. 표준 인터페이스와 경계 분리가 이후 변경 비용을 크게 낮춘 사례를 다루었습니다.

Hexagonal Architecture와 표준화된 인프라에 투자해 멀티클라우드, AI 백엔드, Observability 전환 비용을 낮춘 사례를 다뤘습니다. 벤더가 바뀌어도 코드와 운영을 크게 흔들지 않는 구조의 효과를 설명했습니다.
Kubernetes 환경에서 OpenTelemetry를 도입해 로그·메트릭·트레이스를 통합 수집했습니다. 기존 정책과의 호환성과 데이터 무결성을 보완하며 MTTR도 개선했습니다.
Claude Code의 세션·비용·사용량을 보기 위해 AWS 관리형 서비스로 Observability 플랫폼을 구축하는 방법을 소개했습니다. 메트릭과 이벤트를 분리해 실시간 모니터링과 심층 분석을 함께 제공했습니다.
OpenTelemetry와 ClickHouse로 대용량 로그 파이프라인을 다시 설계한 사례를 소개했습니다. 하루 41TB 로그를 20초 이내 처리하고 비용을 크게 줄인 과정을 정리했습니다.