
TurboQuant가 시장을 흔든 진짜 이유: AI 최적화는 이제 메인스트림
TurboQuant의 KV 캐시 양자화가 AI 메모리·전력 효율 경쟁의 핵심 신호임을 분석했습니다. 연구 단계인 만큼 실제 서빙 환경에서의 검증 필요성도 짚었습니다.
#TurboQuant#LLM
000
TurboQuant의 KV 캐시 양자화가 AI 메모리·전력 효율 경쟁의 핵심 신호임을 분석했습니다. 연구 단계인 만큼 실제 서빙 환경에서의 검증 필요성도 짚었습니다.
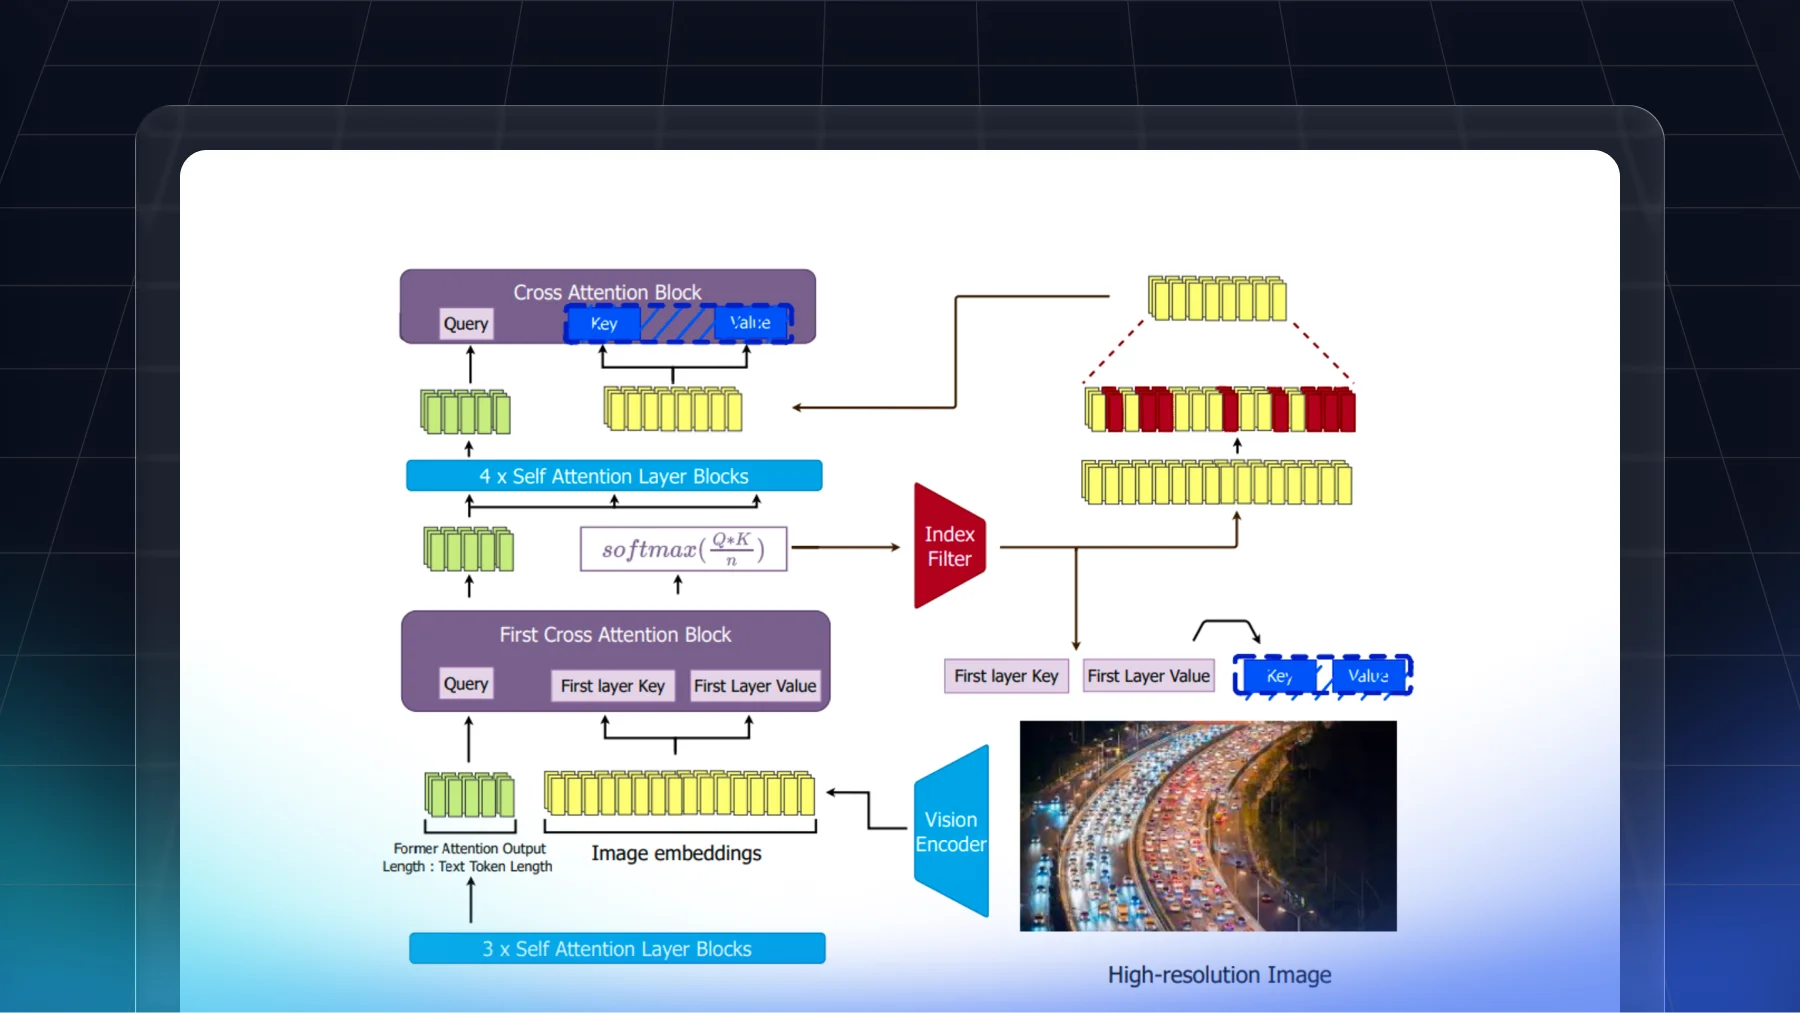
크로스 어텐션의 희소성을 활용해 LLaMA-3.2-Vision의 불필요한 시각 토큰을 제거했습니다. 성능을 유지하며 KV 캐시, 메모리 사용량, 추론 지연을 줄였습니다.


vLLM의 PagedAttention과 Continuous Batching을 코드 흐름 중심으로 분석했습니다. KV 캐시 블록 관리, 스케줄링, CUDA 기반 Single Query Attention을 설명합니다.