

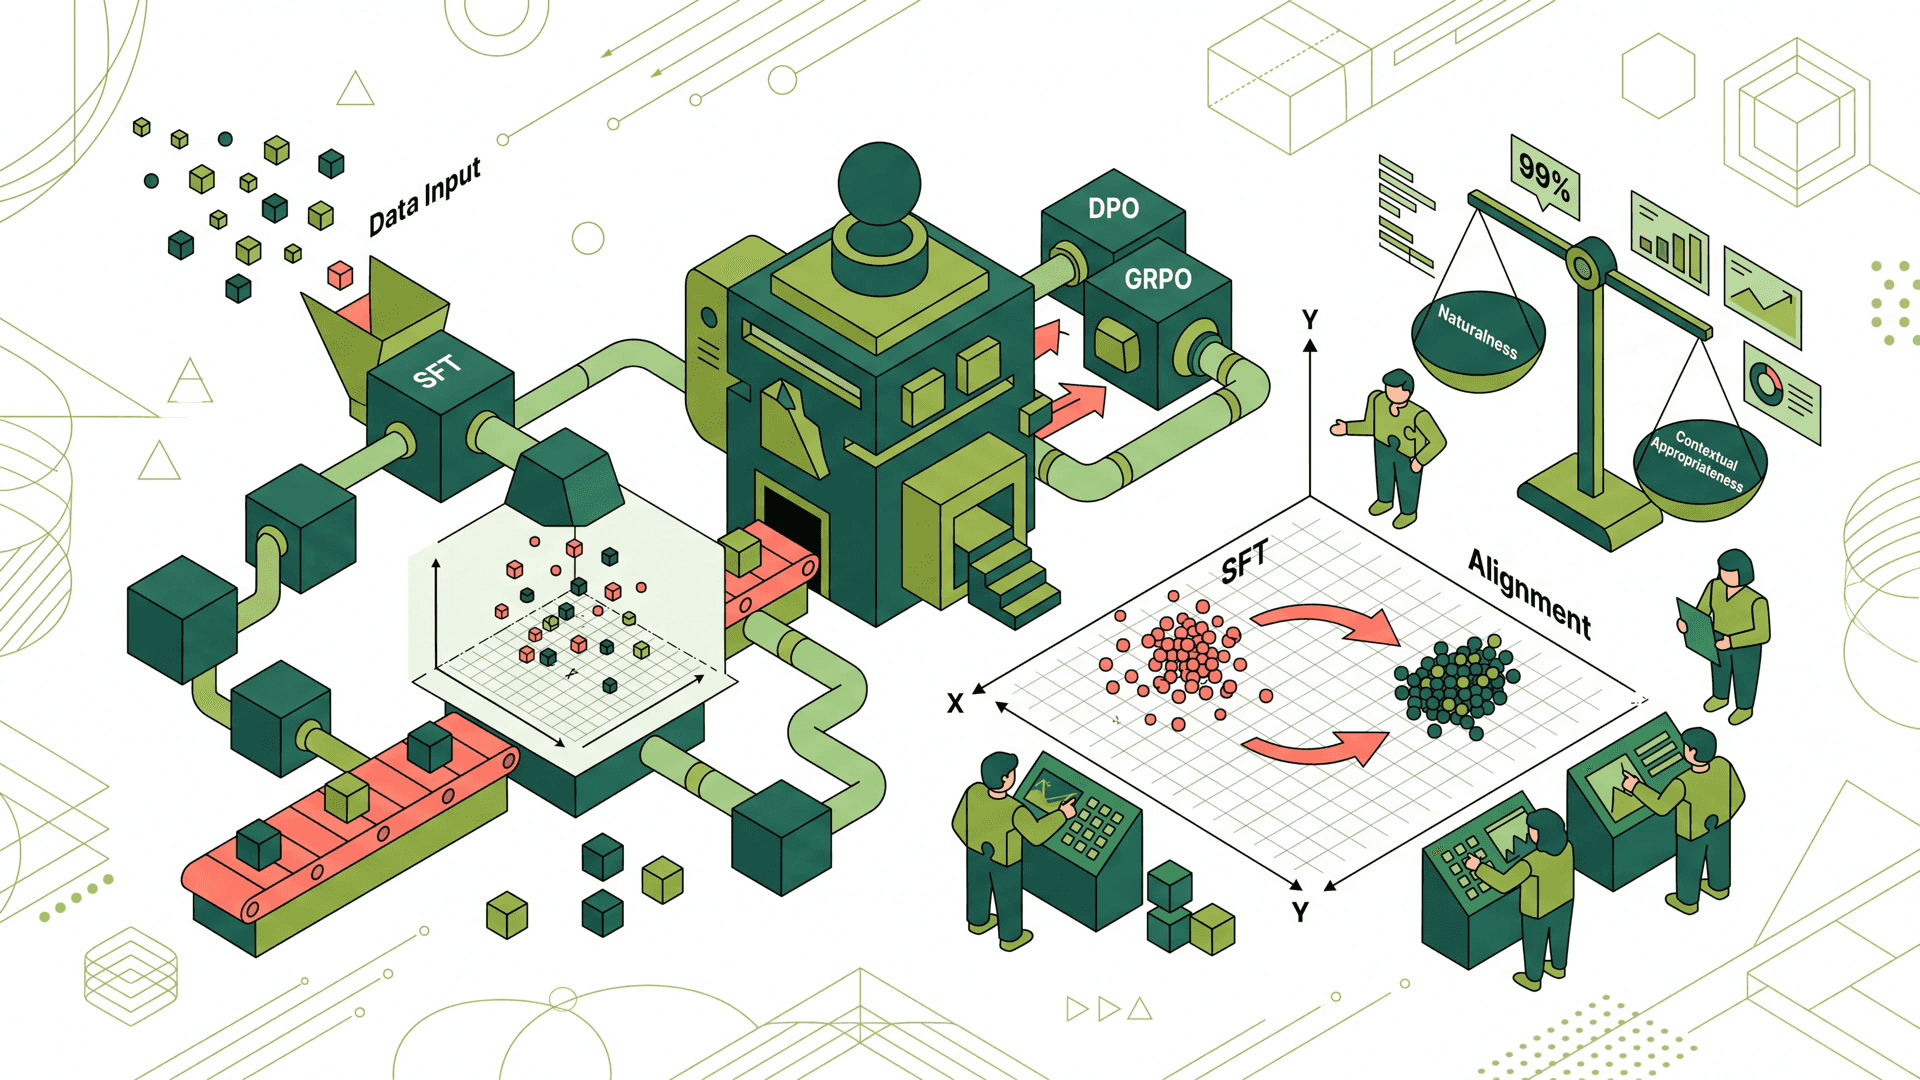

측정할 수 없으면 개선할 수 없다 - AI Pick 추천 카드를 위한 sLLM 정렬 학습기
AI Pick 카드 생성 품질을 높이기 위해 SFT 이후 정렬 학습과 평가 지표를 설계한 과정을 공유했습니다. 형식 검증기와 NLL 프록시로 선호 쌍을 만들고 DPO, GRPO로 품질과 형식을 함께 개선했습니다.
#LLM#DPO
5500
새로운 기술 블로그가 추가되었어요
AI Pick 카드 생성 품질을 높이기 위해 SFT 이후 정렬 학습과 평가 지표를 설계한 과정을 공유했습니다. 형식 검증기와 NLL 프록시로 선호 쌍을 만들고 DPO, GRPO로 품질과 형식을 함께 개선했습니다.


비동기 GRPO 인프라와 TIS 보정으로 rollout·학습 간 확률 불일치를 안정화했습니다. 리워드 해킹을 완화해 DPO 대비 이용시간과 리텐션을 개선했습니다.

답변 재생성 시그널을 정제해 DPO 학습용 선호 페어를 구성했습니다. 강한 거부 신호와 분포 조정으로 이용 시간·리텐션을 개선했습니다.
상담사처럼 발화하는 TTS를 만들기 위해 한국어 적응, 단일 화자 미세조정, GRPO, DPO를 단계적으로 적용했습니다. 명료도와 상담사향 프로소디를 함께 개선하며 실제 전화 상담에 맞는 음성을 추구했습니다.
상담사처럼 말하는 한국어 TTS를 만들기 위해 데이터 학습, 명료도 개선, 선호도 기반 후학습을 단계적으로 적용했습니다. GRPO와 DPO로 상담사향 프로소디와 화자 일관성을 높인 과정을 소개했습니다.