
흩어진 행동을 연결하다: 네이버 전 지면의 사용자 행동을 학습하는 추천 모델 개발기

흩어진 행동을 연결하다: 네이버 전 지면의 사용자 행동을 학습하는 추천 모델 개발기
검색·피드·광고 데이터를 연결하는 버티컬 추천 모델의 개발과 적용 경험을 소개합니다. 실시간 GPU 서빙 최적화와 지식 증류 기반 도메인 간 지식 전이를 다룹니다.
#추천 시스템#GPU
900
검색·피드·광고 데이터를 연결하는 버티컬 추천 모델의 개발과 적용 경험을 소개합니다. 실시간 GPU 서빙 최적화와 지식 증류 기반 도메인 간 지식 전이를 다룹니다.
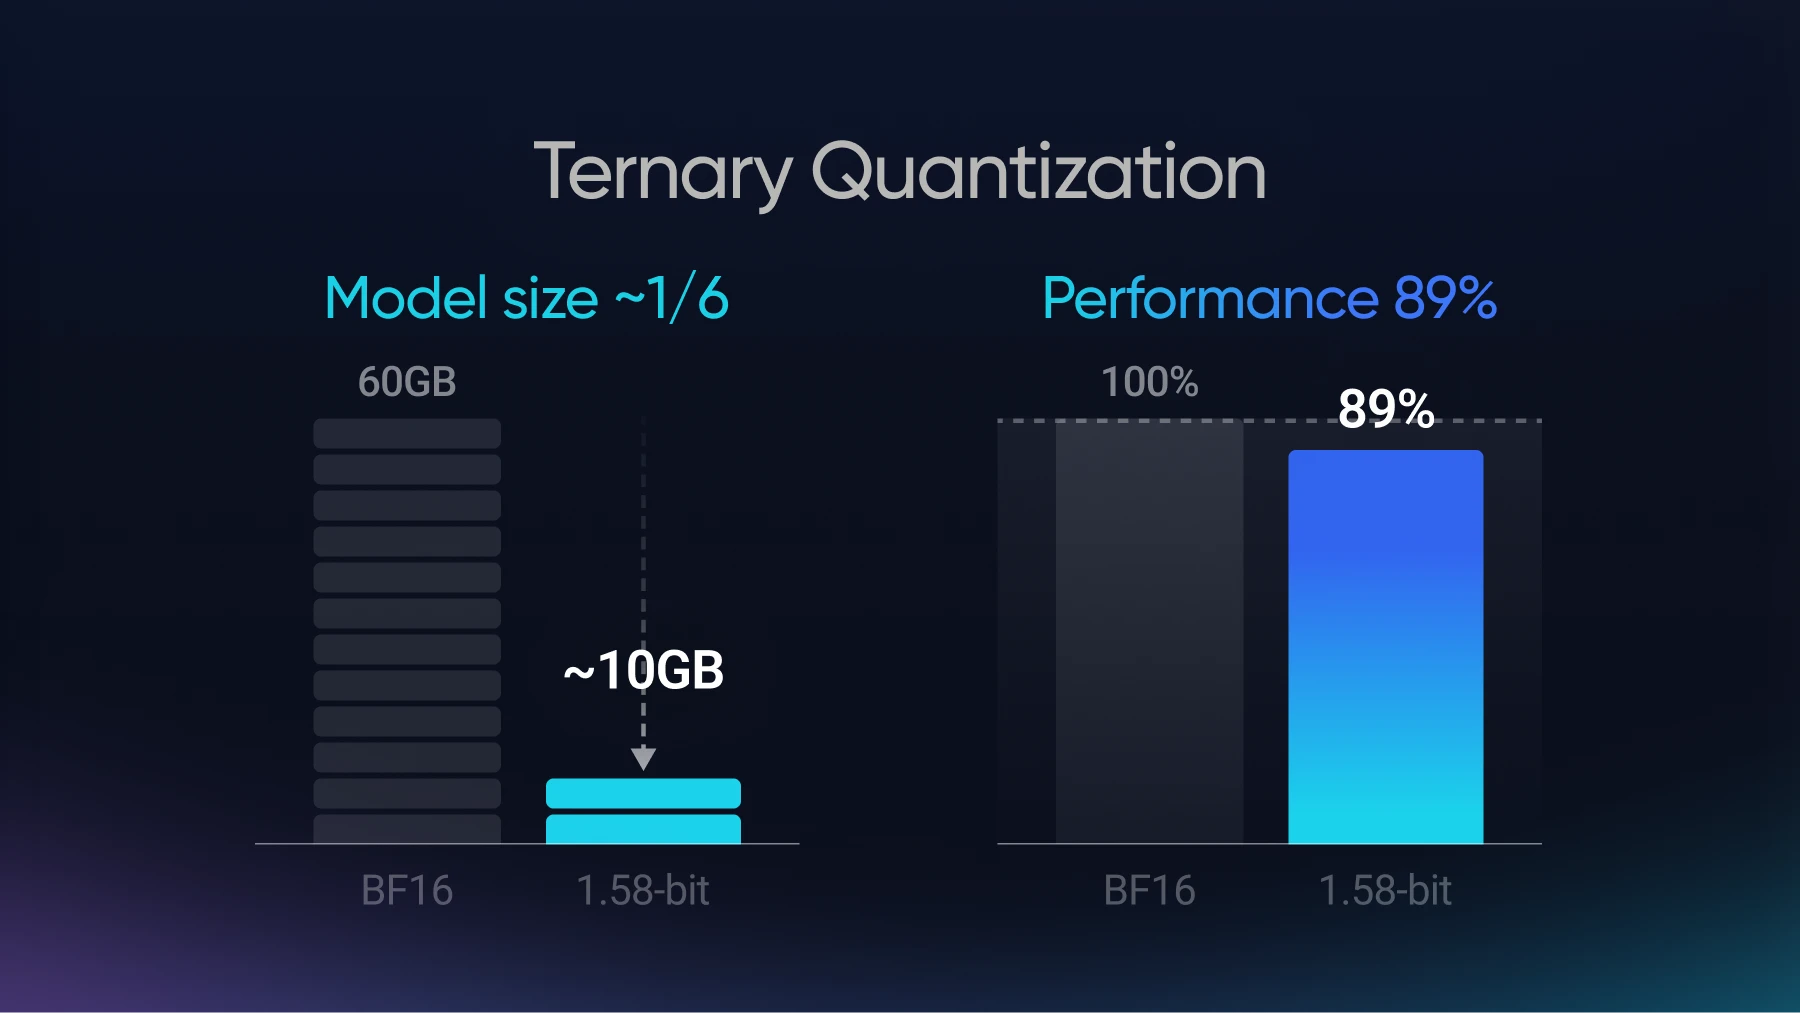
1.58비트 터너리 양자화로 30B LLM 가중치를 약 10GB까지 줄였습니다. 증류와 경계 마스킹으로 성능을 복원해 24GB 이상 맥북 실행 가능성을 제시합니다.
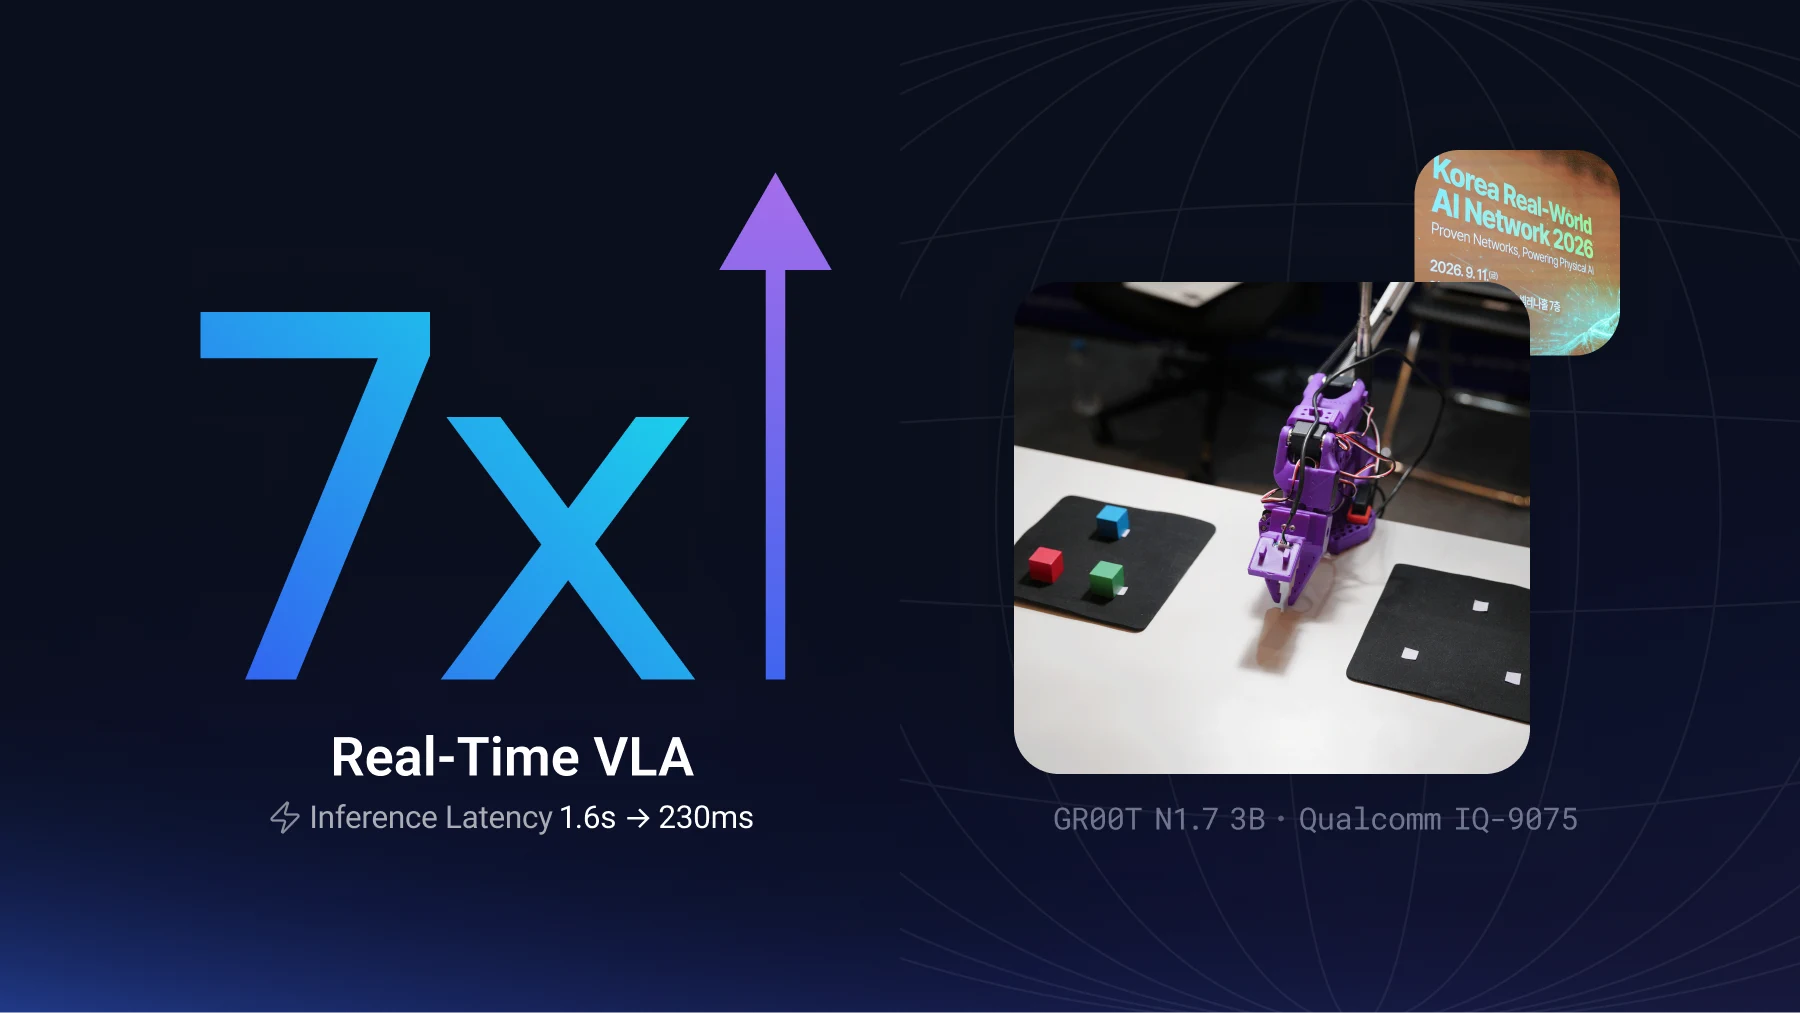
퀄컴 NPU에서 VLA를 실시간 구동하기 위해 백본·런타임·제어 루프를 함께 최적화했습니다. GR00T N1.7을 약 230ms까지 줄이고 RTC로 로봇팔의 연속 동작을 검증했습니다.
LLM으로 리뷰의 진심을 점수화해 별점만으로는 보이지 않던 맛집 변별력을 높였습니다. 지식 증류와 개인화 리랭킹을 더해 추천 품질과 전환율을 함께 개선했습니다.
모바일 메신저용 이미지 캡션 생성을 위해 비자기회귀 디코딩과 지식 증류를 적용했습니다. 캡션 재생성과 다단계 정제로 200~400ms 지연과 실사용 가능한 품질을 달성했습니다.
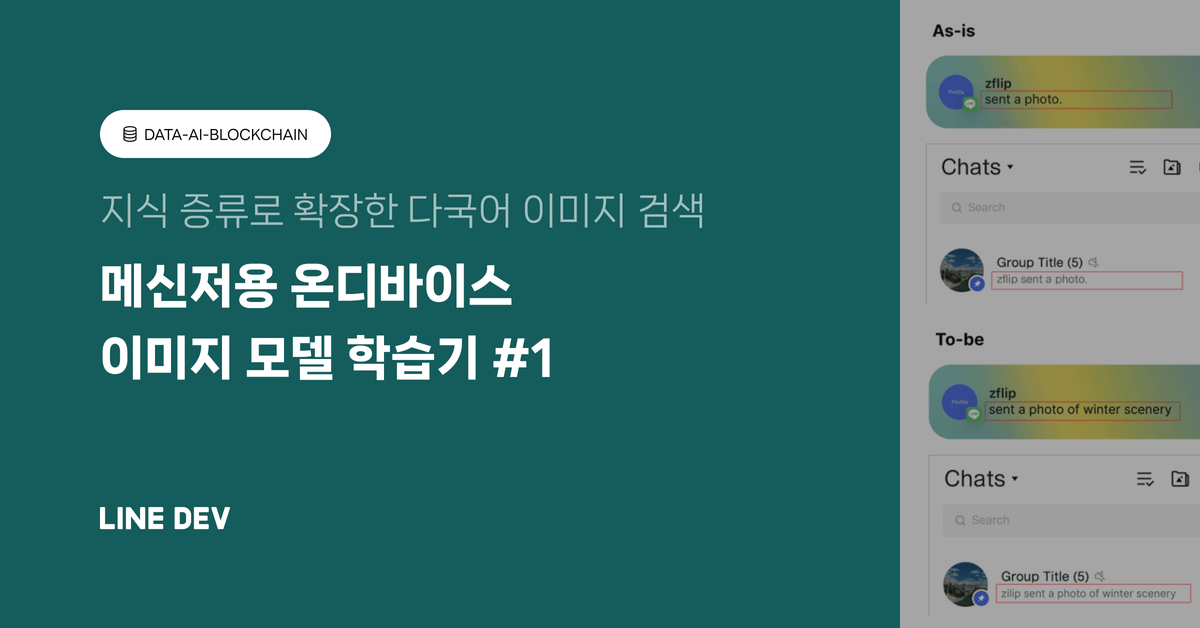
네트워크 없이 모바일 기기에서 동작하는 메신저용 이미지 이해 기능을 만들고 지식 증류로 다국어 검색을 구현했습니다. 또한 LiteRT 변환과 벡터 DB 튜닝으로 온디바이스 배포와 실사용 성능을 맞췄습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.


Amazon Bedrock에서 Nova 모델 지식 증류와 온디맨드 배포, 평가 흐름을 실험 사례로 정리했습니다. 표준 벤치마크와 LLM as a Judge를 함께 활용해 성능과 비용 효율을 비교했습니다.
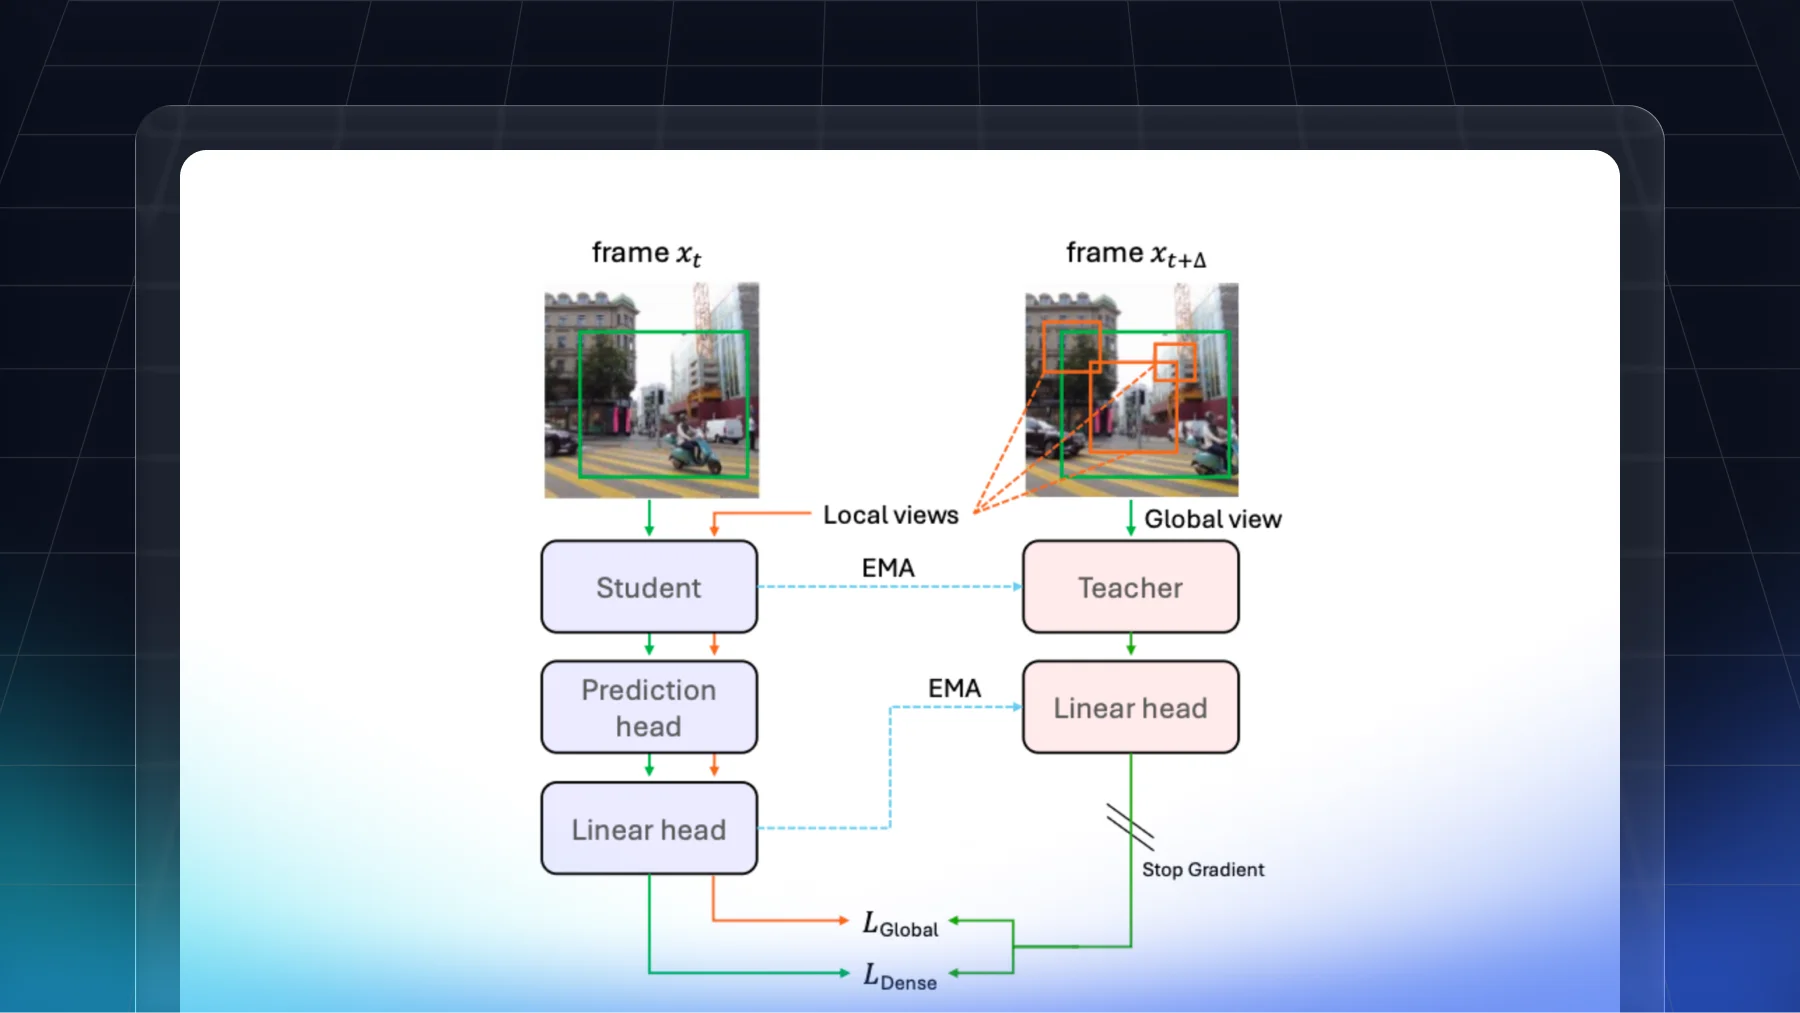
다음 프레임 예측과 EMA 교사를 결합한 비디오 자기지도학습 프레임워크를 제안했습니다. 광류·객체 추적 없이 ADE20K 분할과 COCO 검출 성능을 높였습니다.
호텔 검색에서 LLM을 sLLM으로 옮기기 위해 지식 증류를 적용한 과정을 다뤘습니다. 성능과 효율을 함께 확보하기 위한 모델 선정, 데이터 구성, 학습 기법 개선을 설명했습니다.

DeepSeek-R1의 구조와 학습 방식, GRPO와 지식 증류의 특징을 OpenAI o1과 비교해 정리했습니다. 비용 절감과 추론 성능 강점, 한국어 적용 시 주의점도 함께 살펴봤습니다.


DeepSeek-R1의 강화 학습 기반 추론 향상 방식과 지식 증류 전략을 정리했습니다. 또한 API 활용, 소형 모델 성능, 향후 개선 과제까지 함께 살펴봤습니다.
검색어와 문서를 함께 고려해 사용자 의도를 세분화하는 LLM 기반 모델을 설계했습니다. 이를 통해 추천의 맥락 정확도를 높이고 CTR도 개선했습니다.
홈피드 추천 고도화를 위해 LLM으로 사용자 관심 주제를 세분화하는 분류기와 선호도 추출 방식을 소개했습니다. 데이터 증강과 지식 증류, 가이드 생성으로 안정성과 클릭률 개선 효과를 확인했습니다.
롱테일 질의의 검색 랭킹을 개선하기 위해 LLM의 재순위화 능력을 경량 랭커로 이식한 방법을 다루었습니다. 정답 데이터셋 구축과 지식 증류로 성능과 추론 효율을 함께 확보했습니다.