


한/글 문서 파일 형식: Python을 통한 HWPX 포맷 파싱하기 (1)
HWPX를 ZIP 기반 XML 포맷으로 보고 Python 내장 라이브러리로 메타정보를 추출하는 방법을 설명했습니다. 문서 시작 번호, 커서 위치, 바이너리 목록을 `Document` 객체로 구조화하는 흐름을 다뤘습니다.
#Python#XML
7600
새로운 기술 블로그가 추가되었어요
HWPX를 ZIP 기반 XML 포맷으로 보고 Python 내장 라이브러리로 메타정보를 추출하는 방법을 설명했습니다. 문서 시작 번호, 커서 위치, 바이너리 목록을 `Document` 객체로 구조화하는 흐름을 다뤘습니다.

무신사 QA 팀이 엑셀 기반 리포트와 수기 입력의 비효율을 줄이기 위해 QA Admin 도구를 구축했습니다.\nPython과 Flask로 데이터를 구조화해 리포트 자동화, 리뷰 분석, XPath 관리를 통합했습니다.


iOS 이미지 리소스를 파일명 규칙 기반 스크립트로 자동 정리하는 방법을 소개했습니다. 수작업 교체와 설정 부담을 줄여 실수를 줄이고 반복 작업을 크게 줄였습니다.
1:1 비디오 채팅의 회귀 테스트를 두 개의 driver와 pytest hook, segment, 병렬 실행으로 자동화했습니다. 이를 통해 매칭 간섭을 줄이고 실행 시간을 크게 단축하며 QA 반복 업무를 줄였습니다.

Langchain 없이 Python으로 ReAct 기반 LLM Agent를 직접 구현하는 예제를 소개했습니다. 프롬프트 설계와 멀티턴 흐름에 따라 함수 호출 결과가 달라질 수 있음을 보여줬습니다.
프롬프트 품질을 정량 평가하는 방법을 Prometheus 2와 OpenAI API 실습으로 설명했습니다. 각 평가 방식의 장단점과 환각 탐지 한계를 비교하며 자동화된 평가 파이프라인 필요성을 제시했습니다.
프롬프트 성능을 정량적으로 평가하는 방법을 Prometheus 2와 OpenAI API 실습으로 소개했습니다. 문맥 평가는 강점이지만 최신 사실 검증은 도구별 한계가 있어 반복 평가가 필요합니다.

AI 에이전트의 실무 적합성을 τ-bench로 재평가한 글입니다. 기존 벤치마크와 달리 대화, 정책, 멀티스텝 처리, 일관성까지 함께 봐야 한다고 설명했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

레거시 정산 시스템의 성능 한계와 복잡도를 해결하기 위해 Spring Boot와 Spring Batch로 전면 재설계했습니다. 정산 기준별 Step 분리와 일간 집계 추가로 확장성과 운영 안정성을 높였습니다.

MCP를 AI의 USB-C에 비유하며 LLM과 외부 시스템을 표준 인터페이스로 연결하는 방법을 소개했습니다. Python으로 MCP Server, Claude 연동, Streamlit Host, REST API Wrapper 실습까지 다뤘습니다.

RAG 서비스의 검색 품질을 높이기 위해 OpenSearch 하이브리드 검색을 도입한 사례를 소개했습니다. 키워드 검색과 시맨틱 검색을 결합하고, 가중치 조정과 벡터 구조 개선 방향도 함께 정리했습니다.
생성형 AI로 마케팅 영상을 만드는 AI Moment 개발 사례를 소개했습니다. LLM 응답 구조화, 예외 처리, 비동기 처리와 캐싱으로 서비스 품질을 높이는 방법을 다뤘습니다.
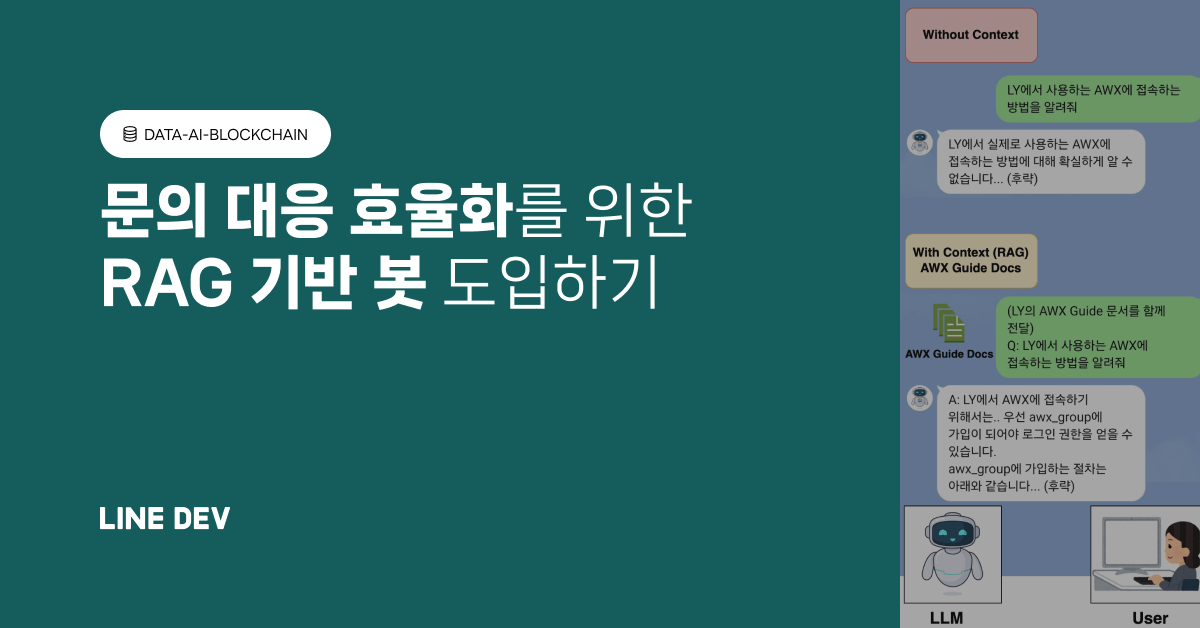
AWX 운영 문의를 줄이기 위해 RAG 기반 지원 봇을 도입한 사례를 소개했습니다. 사내 문서와 Slack 스레드를 벡터 검색해 1차 답변을 제공하고, 필요 시 관리자 호출로 넘기는 흐름을 구성했습니다.

오픈AI의 AI 기기 개발, SKT 해킹 대응 검토, 통신사 이용자 보호 점검 등 산업·보안 이슈를 묶어 소개했습니다. 또한 LLM 게이트웨이, Airflow 버전관리, Codex 리뷰 같은 기술 기사도 함께 정리했습니다.