

해커톤 경험을 통해 엿본 AI시대에 개발자가 가져야 할 자세
해커톤에서 AI 채용 도우미 AIVA를 만들며 이력서와 과제 분석, 코드 실행 검증까지 실험했습니다. 프롬프트 설계와 캐싱, 토큰 제한을 고민하며 AI 시대 개발자의 자세도 함께 성찰했습니다.
#LLM#prompt
15900
새로운 기술 블로그가 추가되었어요
해커톤에서 AI 채용 도우미 AIVA를 만들며 이력서와 과제 분석, 코드 실행 검증까지 실험했습니다. 프롬프트 설계와 캐싱, 토큰 제한을 고민하며 AI 시대 개발자의 자세도 함께 성찰했습니다.

여기어때의 BFF가 각 클라이언트에 맞춘 API와 데이터 가공을 맡는 역할을 소개했습니다. 성능 최적화, 보안 분리, 독립 배포 측면의 장점도 함께 정리했습니다.
monorepo CI에서 Runner 증설과 Matrix 병렬 빌드를 도입해 빌드 시간을 단축했습니다. Turborepo 캐시 사전 점검으로 캐시 적중 시 오버헤드도 줄였습니다.
monorepo CI에서 병렬 빌드와 캐시 사전 점검으로 빌드 시간을 크게 줄인 사례를 정리했습니다. Runner 개선과 검증 단계 분리로 안정성까지 함께 높였습니다.

Amazon Bedrock의 프롬프트 캐싱 동작 방식과 적합한 사용 사례, 구성 방법을 설명했습니다. 또한 usage 메트릭과 CloudWatch로 캐시 효율을 모니터링하는 방법을 안내했습니다.

재사용 가능한 컨퍼런스 구조를 만들기 위해 템플릿 분리, 브라우저 대응, 로드·렌더링 최적화를 진행했습니다. 모바일과 데스크탑 모두에서 자연스럽게 동작하도록 성능과 인터랙션을 다듬었습니다.


OMS를 판매처와 풀필먼트 사이의 주문 인터프리터로 설계한 과정을 소개했습니다.\nshared cache 중심 MSA로 트래픽을 줄이고 병렬 개발·상시 배포를 지원합니다.
OMS를 판매처와 풀필먼트를 잇는 인터프리터로 보고, 최소 동기화와 재가공 서빙을 중심으로 마이크로서비스와 shared cache 구조를 설계했습니다. 이를 통해 작은 단위 개발과 상시 배포, 피크 트래픽 흡수를 가능하게 했지만, 팀 전체의 높은 컨텍스트 공유가 필요했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

이벤트 트래픽 급증으로 발생한 DB 부하를 Redis 캐시로 완화했습니다. 자동·수동·배치 갱신을 결합해 응답 속도와 운영 안정성을 개선했습니다.

카카오내비가 대규모 트래픽을 안정적으로 처리하기 위해 응답 크기 축소와 웜업, 모니터링을 적용한 사례를 공유했습니다. 운영 관점에서 초기 지연을 줄이고 서비스 상태를 지속적으로 관리하는 방법을 소개했습니다.


NVIDIA Dynamo는 분산 추론을 위한 오픈 소스 프레임워크로, Prefill·Decode 분리와 스마트 라우팅으로 성능을 높였습니다.\nKV cache 오프로딩과 NIXL 전송을 통해 GPU 자원 효율과 지연 시간 개선을 노렸습니다.

당근은 피드 콘텐츠를 Feed-Entity로 표준화해 여러 서비스의 데이터를 한 구조로 관리했습니다. 수집·변환·검증·서빙을 모듈화하고 지역별 캐시로 읽기 성능과 확장성을 높였습니다.

약관 서버의 DB 부하를 줄이기 위해 Redis 캐시와 강한 일관성 전략을 적용했습니다. 캐시 무효화 실패와 이벤트 순서 문제는 트랜잭션 동기화와 정책으로 해결했습니다.
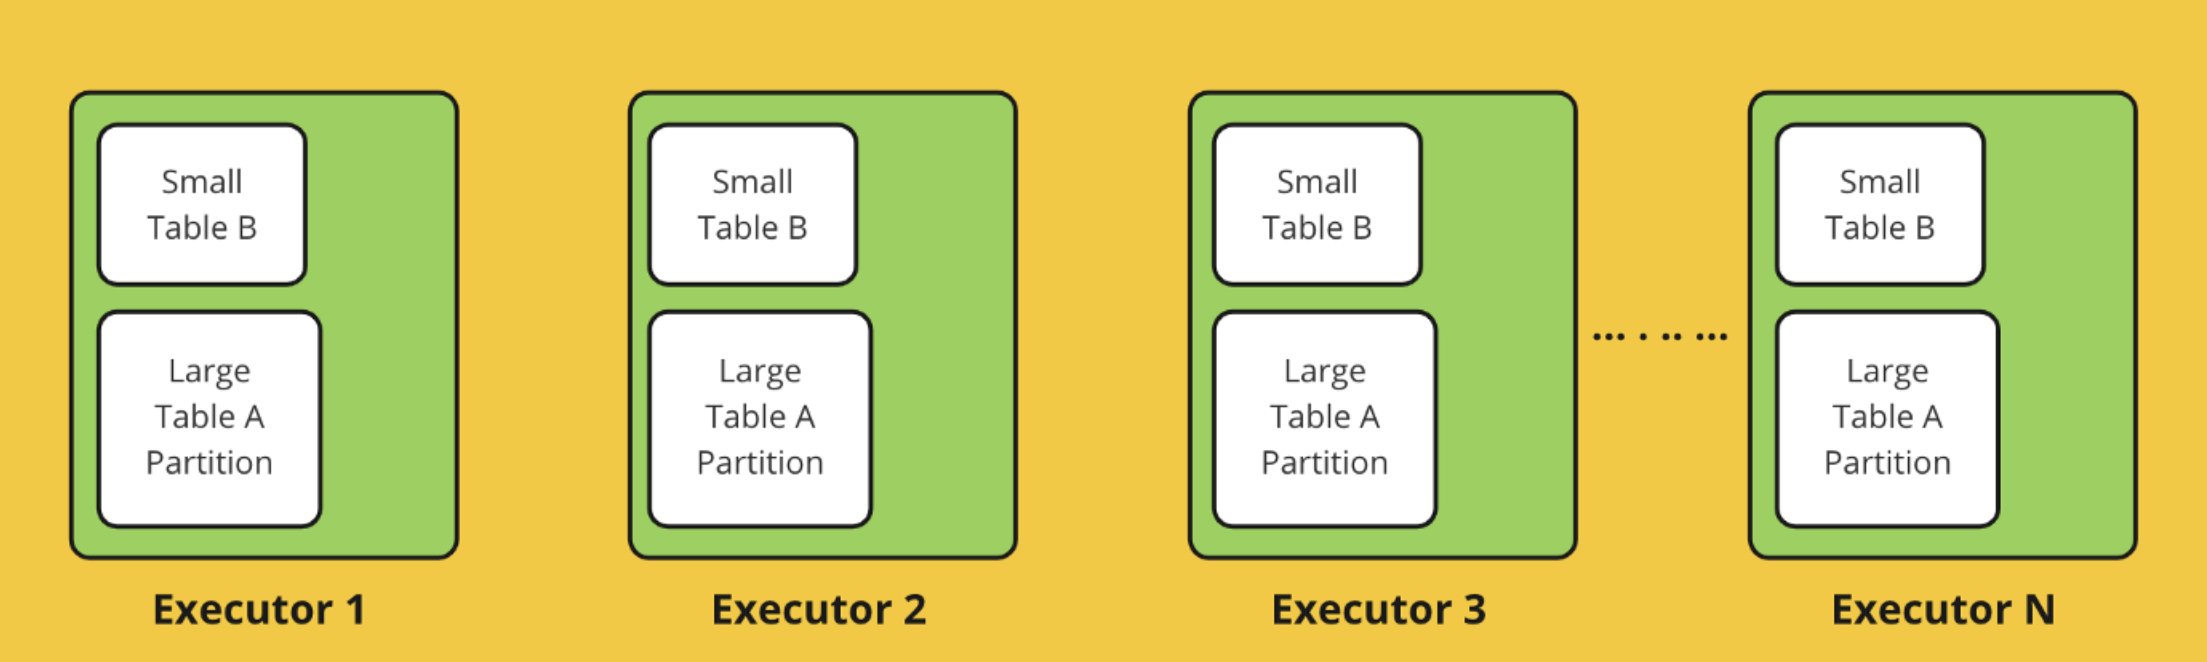
Spark의 Broadcast 기능으로 셔플을 줄이고 join 성능을 높이는 방법을 소개했습니다. 작은 데이터셋에는 자동 broadcast 감지와 설정 조건도 함께 설명했습니다.