
DynamoDB 핫 파티션을 해결하는 3가지 방법 (3): 조회를 인덱스 테이블로 옮기기
DynamoDB GSI의 조회 경로를 인덱스 테이블과 공통 라이브러리로 전환한 사례를 정리했습니다. limit, 커서, 삭제 데이터 처리 함정을 규칙화해 GSI를 최종 제거했습니다.
#DynamoDB#GSI
4500
DynamoDB GSI의 조회 경로를 인덱스 테이블과 공통 라이브러리로 전환한 사례를 정리했습니다. limit, 커서, 삭제 데이터 처리 함정을 규칙화해 GSI를 최종 제거했습니다.


Amazon Aurora와 RDS의 PostgreSQL 18에서 보안, 모니터링, 복제, 개발자 기능 개선을 정리했습니다. MD5 인증 중단, uuidv7(), COPY 및 RETURNING 개선, 복제 슬롯 보호 방법을 함께 소개했습니다.
배달의민족은 앱과 로컬 웹을 배포 없이 연결하기 위해 ITDA 프록시 시스템을 설계했습니다. CloudFront Function과 웹소켓 터널링으로 요청을 분리하고 로컬 개발 환경으로 안전하게 전달했습니다.

AI 에이전트가 Figma 디자인을 코드로 바꾸는 흐름에서 디자인 시스템 컴포넌트를 제대로 쓰게 만드는 방법을 다룹니다. 디자인과 코드 변환 과정의 기준을 정리하는 데 초점을 둡니다.

합성 데이터와 원시 픽셀 중심의 로봇 학습 한계를 짚고, 단안 영상에서 장면 시맨틱을 추출하는 F.R.A.N.T.Z. 접근을 소개했습니다. 또한 추출 결과를 어포던스와 정책 학습으로 연결하고, JEPA 스타일 월드 모델로 확장하는 방향을 제시했습니다.

Kubernetes에서 발생하는 OOMKilled의 원인과 JVM 메모리 구성을 함께 분석했습니다. Heap뿐 아니라 Non-Heap, Off-Heap까지 고려해 JVM 옵션을 조정하는 방법을 정리했습니다.

2026년 기준 Java 25와 Spring Boot 4.x 중심의 백엔드 변화와 실무 전환 포인트를 소개했습니다. 단일 예제 프로젝트로 마이그레이션 판단과 AI 통합까지 다루는 커리큘럼입니다.
당근 실험플랫폼이 지표 UI화, 상호배제 그룹, Experiment MCP로 실험 운영 병목을 줄인 사례를 소개했습니다. 실험 설계와 반복 작업을 더 빠르고 편하게 만들기 위한 구조와 자동화 방향을 다뤘습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.


Gradle 멀티모듈로 경계를 강하게 고정하면 잘못된 의존은 막을 수 있지만, 경계를 옮기는 비용도 커졌습니다. 그래서 함께 바뀌는 리듬을 기준으로 모듈 경계를 다시 설계하는 방법을 정리했습니다.
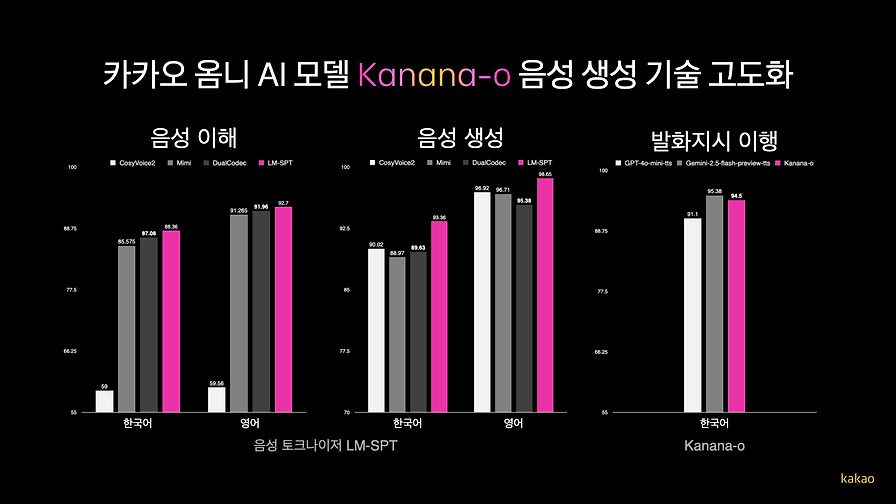
Kanana-o 음성 생성 고도화 과정을 소개하는 글입니다. 잘 말하는 AI를 넘어 원하는 대로 말하는 음성 AI를 목표로 한 맥락을 다룹니다.

벡터DB를 걷어낸 뒤 MySQL과 배치로 유사글 추천을 다시 구현했습니다. Gemini 임베딩과 운영 사고 대응까지 포함해 비용과 안정성을 함께 개선했습니다.

통합 테스트를 TS/TC 구조로 재설계해 역할별 흐름과 예외 케이스를 체계화했습니다. 환경별 검증과 ID 관리 원칙으로 회귀 테스트와 추적성을 높였습니다.

애플리케이션 계층에서 관계를 다루는 이유와 구조를 정리했습니다. DB/JPA에 맡기기보다 이벤트 전파와 메타데이터로 관계를 명시적으로 관리하는 방식입니다.

아임웹이 Valkey 9.1 업그레이드로 캐시 엔진 효율을 실측한 사례를 공유했습니다. 같은 트래픽에서 CPU와 지연 시간이 줄고, 메모리와 운영 안정성도 개선되었습니다.