
Opensearch 검색엔진을 이용한 네이버 페이 검색 하기
Opensearch 검색엔진을 이용한 네이버 페이 검색 하기
네이버페이 검색 서비스를 OpenSearch로 구축하며 색인 구조와 한글 검색 품질 개선 과정을 소개했습니다. 또한 무중단 패치, 최근 검색어 저장, 특수문자 예외 처리까지 운영 경험을 정리했습니다.
#OpenSearch#검색
28000
네이버페이 검색 서비스를 OpenSearch로 구축하며 색인 구조와 한글 검색 품질 개선 과정을 소개했습니다. 또한 무중단 패치, 최근 검색어 저장, 특수문자 예외 처리까지 운영 경험을 정리했습니다.


RAG 서비스의 검색 품질을 높이기 위해 OpenSearch 하이브리드 검색을 도입한 사례를 소개했습니다. 키워드 검색과 시맨틱 검색을 결합하고, 가중치 조정과 벡터 구조 개선 방향도 함께 정리했습니다.
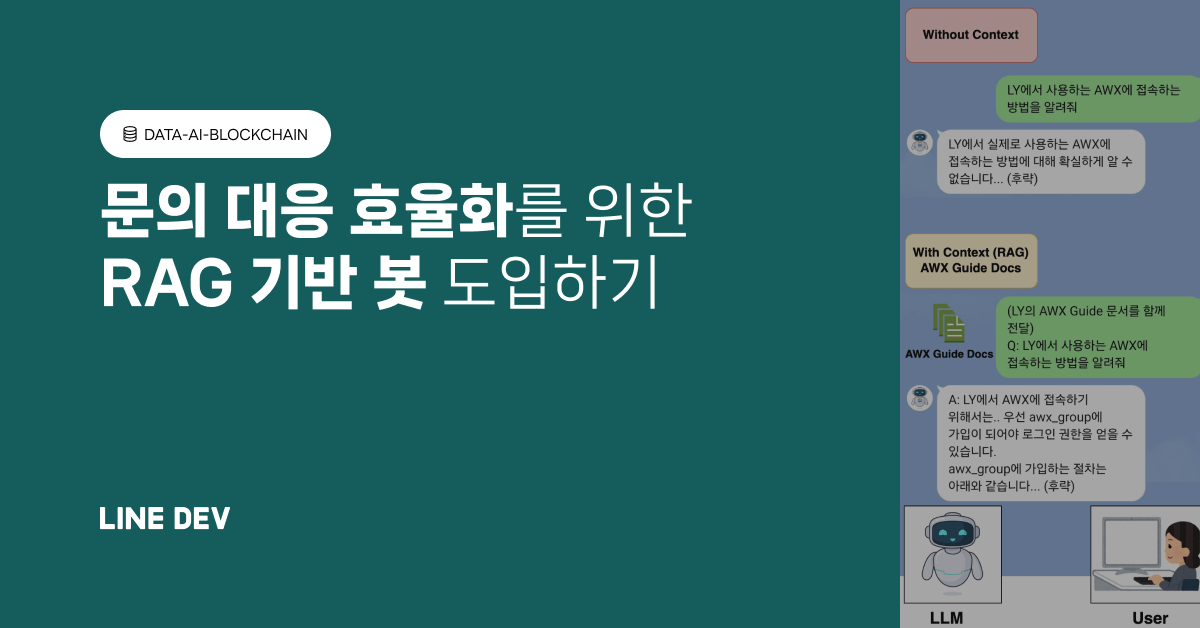
AWX 운영 문의를 줄이기 위해 RAG 기반 지원 봇을 도입한 사례를 소개했습니다. 사내 문서와 Slack 스레드를 벡터 검색해 1차 답변을 제공하고, 필요 시 관리자 호출로 넘기는 흐름을 구성했습니다.
Spring AI와 AWS 기반으로 FAQ 데이터를 검색·정제·생성하는 RAG 챗봇 구축 과정을 소개했습니다. Hybrid Search, Chunking, 관련성 평가의 선택 기준과 운영 고려사항을 정리했습니다.

Amazon OpenSearch Service의 LTR 플러그인으로 BM25 결과를 재정렬해 검색 품질을 높이는 과정을 소개했습니다. Bedrock, RankLib, NDCG 평가를 통해 학습·배포·비교 흐름을 실습 형태로 설명했습니다.

디프로모션은 성장 과정에서 기존 데이터 구조의 한계를 보완하기 위해 DynamoDB, zero-ETL, ElastiCache Serverless를 도입했습니다. 실시간 동기화와 캐시 최적화로 응답 속도와 운영 효율을 함께 개선했습니다.

AWS OpenSearch에서 로그 보관 기간 문제를 해결하기 위해 여러 로그 분리 방식을 비교했습니다. Firehose와 Lambda, Fluent Bit 조합으로 특정 로그를 별도 인덱스로 분리하는 방법을 정리했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
OpenSearch와 Analyzer로 부분 검색, 대소문자 무시, 특수문자 제거 검색을 구현하는 방법을 설명했습니다. 또한 카카오페이손해보험의 검색 서비스 활용 사례도 함께 소개했습니다.

Amazon Bedrock과 Amazon OpenSearch로 헤지펀드용 Company Screener Agent를 구현한 사례를 소개했습니다. 금융 특화 임베딩과 하이브리드 검색으로 종목 선별, 요약, 검증을 자동화한 효과를 설명했습니다.
Amazon OpenSearch Service OR1 인스턴스의 내부 구조와 데이터 흐름을 설명했습니다. Amazon S3 기반 원격 저장과 물리 복제로 처리량, 내구성, 복구 효율을 높이는 방식을 다뤘습니다.
Amazon OpenSearch Service의 Multi-AZ with Standby에서 검색과 색인 트래픽이 어떻게 분산되고 전환되는지 설명했습니다. 가중치 라운드 로빈과 영역별 장애 조치로 고가용성과 일관된 성능을 확보하는 방식도 다뤘습니다.

DocumentDB 슬로우쿼리를 수집·시각화하고, COLLSCAN 쿼리에 대해 AI로 인덱스를 추천받는 파이프라인을 구축했습니다. 이를 통해 슬로우쿼리 합계가 약 30% 감소하고 무거운 쿼리가 개선되었습니다.
SmartThings 기록 시스템의 DB를 HBase에서 OpenSearch로 교체한 사례를 소개했습니다. 성능 개선과 비용 절감을 목표로 전환을 진행했습니다.

SK하이닉스가 AWS 환경에서 RAG 플랫폼을 구축하고 성능을 평가한 사례를 소개했습니다. 데이터셋 크기와 인덱스 메모리가 검색 지연과 TTFT에 미치는 영향을 분석했습니다.