

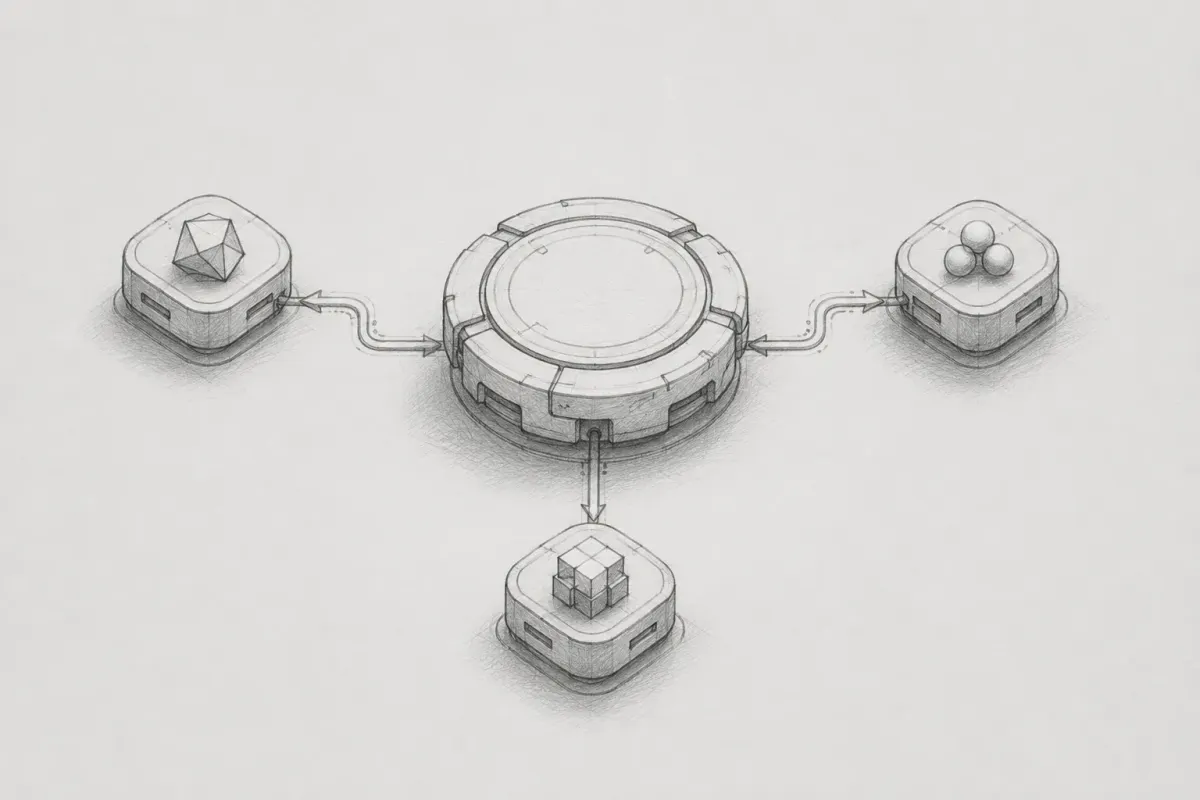
Herdr 기반 Multi-Agent Workflow 구축기
단일 AI 에이전트의 한계를 줄이기 위해 조사, 설계, 구현, 검증을 분리한 멀티 에이전트 워크플로우를 구축했습니다. Herdr의 멀티 Pane과 이종 모델 조합으로 컨텍스트를 격리하고 품질 검증을 자동화했습니다.
#LLM#multi-agent
7400
새로운 기술 블로그가 추가되었어요
단일 AI 에이전트의 한계를 줄이기 위해 조사, 설계, 구현, 검증을 분리한 멀티 에이전트 워크플로우를 구축했습니다. Herdr의 멀티 Pane과 이종 모델 조합으로 컨텍스트를 격리하고 품질 검증을 자동화했습니다.
수백 MB 로그를 LLM에 그대로 넣는 비효율을 줄이기 위해 AI 이슈 분석 에이전트를 개발한 사례입니다. 이슈를 찾고 읽는 시간을 줄이면서 근거를 검증 가능한 방식에 초점을 맞췄습니다.


한국어·일본어 전용 토크나이저를 기존 LLM 백본에 이식해 토큰 효율을 개선했습니다. 실서비스 A/B에서 GPU 사용량과 응답 지연을 줄이고 이용 시간을 높였습니다.
리서치 분석을 LLM으로 만들고 전달하는 구조를 정리했습니다. 작업 분해와 평가 루프, SSE·알림음·채팅으로 사용자 경험을 개선했습니다.

ZEP의 교육용 퀴즈 생성 아키텍처를 LangGraph와 Amazon Bedrock AgentCore Runtime 중심으로 설명했습니다. 하나의 그래프를 실시간 서빙과 배치 생성에 재사용하고 관측 체계까지 분리해 운영하는 방식입니다.
LangGraph 기반 자연어 질의 에이전트를 Bedrock AgentCore로 프로덕션에 배포한 사례를 소개했습니다. Gateway, Memory, Observability, Evaluations, Policy로 운영성과 보안을 보완했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
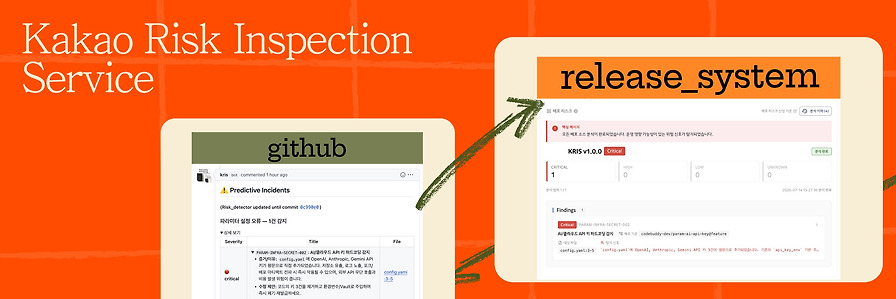
배포 전에 리뷰해 같은 장애의 재발을 막으려는 개발기 글입니다. 본문이 부족해 구체적 내용은 확인하기 어렵습니다.

올리브영이 MCP를 개발하며 LLM이 툴을 잘 이해하도록 설명과 구조를 다듬은 과정을 공유했습니다. 가격 해석, 툴 체이닝, 미호출 문제를 예시·규칙·네이밍 조정으로 개선했습니다.
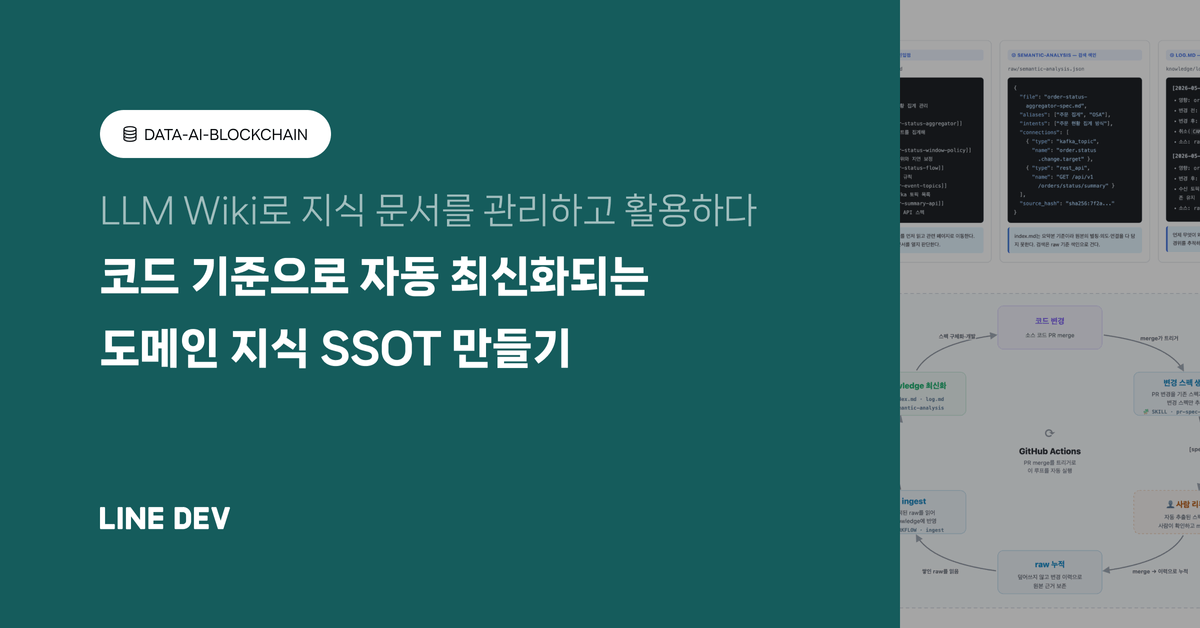
MSA 환경의 분산된 도메인 지식을 코드 기준 SSOT로 정리하고, 변경 시 자동 최신화하는 LLM Wiki 구축 사례를 소개했습니다. 사람과 AI가 같은 지식 문서를 기준으로 스펙 정리와 영향도 분석을 수행하도록 구성했습니다.

AI를 새로운 데이터 소비자로 보고 데이터 플랫폼의 조건을 세 가지 질문으로 정리했습니다. 맥락 제공, 접근 통제, 공통 인터페이스를 통해 AI-Ready Data Platform을 설계하는 방향을 소개했습니다.
LLM은 문서 유사성뿐 아니라 데이터 간 관계를 함께 활용할 때 더 유용해졌습니다. Graph DB는 이런 관계 정보를 제공해 GraphRAG와 AI Agent의 탐색 범위를 넓혀줬습니다.
똑닥 AI 모더레이터의 유저 인터뷰 에이전트 설계와 자가 발전 구조를 공유했습니다. 안전은 코드로 고정하고 전략은 스킬 세트로 분리해 피드백 기반 재합성을 구현했습니다.
AI 네이티브 조직에서 도메인 지식을 사람과 여러 AI 에이전트가 공유하는 방법을 다룬 글입니다. 표준 기반 Core 위에 조직 특화 시맨틱 레이어를 얹는 접근을 소개합니다.
글로벌 상담 AI Agent의 메인 모델을 GPT-5.6 Luna로 바꾼 이유를 자체 벤치마크로 설명했습니다. 공개 리더보드보다 실제 워크로드에서의 품질, 비용, 속도를 함께 보고 전환했습니다.