

API 연동 자동화를 위한 여정: 토스는 왜 사내 MCP 서버를 개발하였는가? with Spring-AI
사내 API 스펙 공유와 연동 자동화를 위해 MCP 서버를 개발한 사례를 소개했습니다. Spring-AI 기반 구현과 운영상 문제 해결, Swagger 자동화 방향까지 정리했습니다.
#MCP#Spring Boot
19600
사내 API 스펙 공유와 연동 자동화를 위해 MCP 서버를 개발한 사례를 소개했습니다. Spring-AI 기반 구현과 운영상 문제 해결, Swagger 자동화 방향까지 정리했습니다.

Amazon EKS에 vLLM DLC를 적용해 DeepSeek 모델을 배포하는 과정을 설명했습니다. EFA와 FSx for Lustre를 활용해 고성능 추론 환경을 구성했습니다.


OpenAI Eval for Agents와 Google Stax의 차이를 QA 관점에서 비교했습니다. 에이전트 전체 흐름 진단은 Eval for Agents, 텍스트 응답 평가와 시각화는 Stax가 강점입니다.

SageMaker AI에서 GPT-OSS 120B 추론 성능 테스트와 GPU 용량 산정 방법을 다뤘습니다. vLLM과 SGLang을 비교하며 워크로드별 성능 지표와 최적화 포인트를 정리했습니다.
LLM과 벡터 검색을 결합해 마케터의 자연어를 실행 가능한 세그먼트로 바꾸는 Seg Lens 개발기를 소개했습니다. 기존 수동 조건 생성의 한계를 줄이고 의미 기반 탐색과 권한 제어를 함께 구현했습니다.

통화제목이 더 구체적이고 핵심적인 방향으로 개선되도록 학습데이터와 프롬프트를 재설계했습니다. 또한 3중 안전 장치를 더해 유쾌함은 살리되 불편한 재미요약은 줄였습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
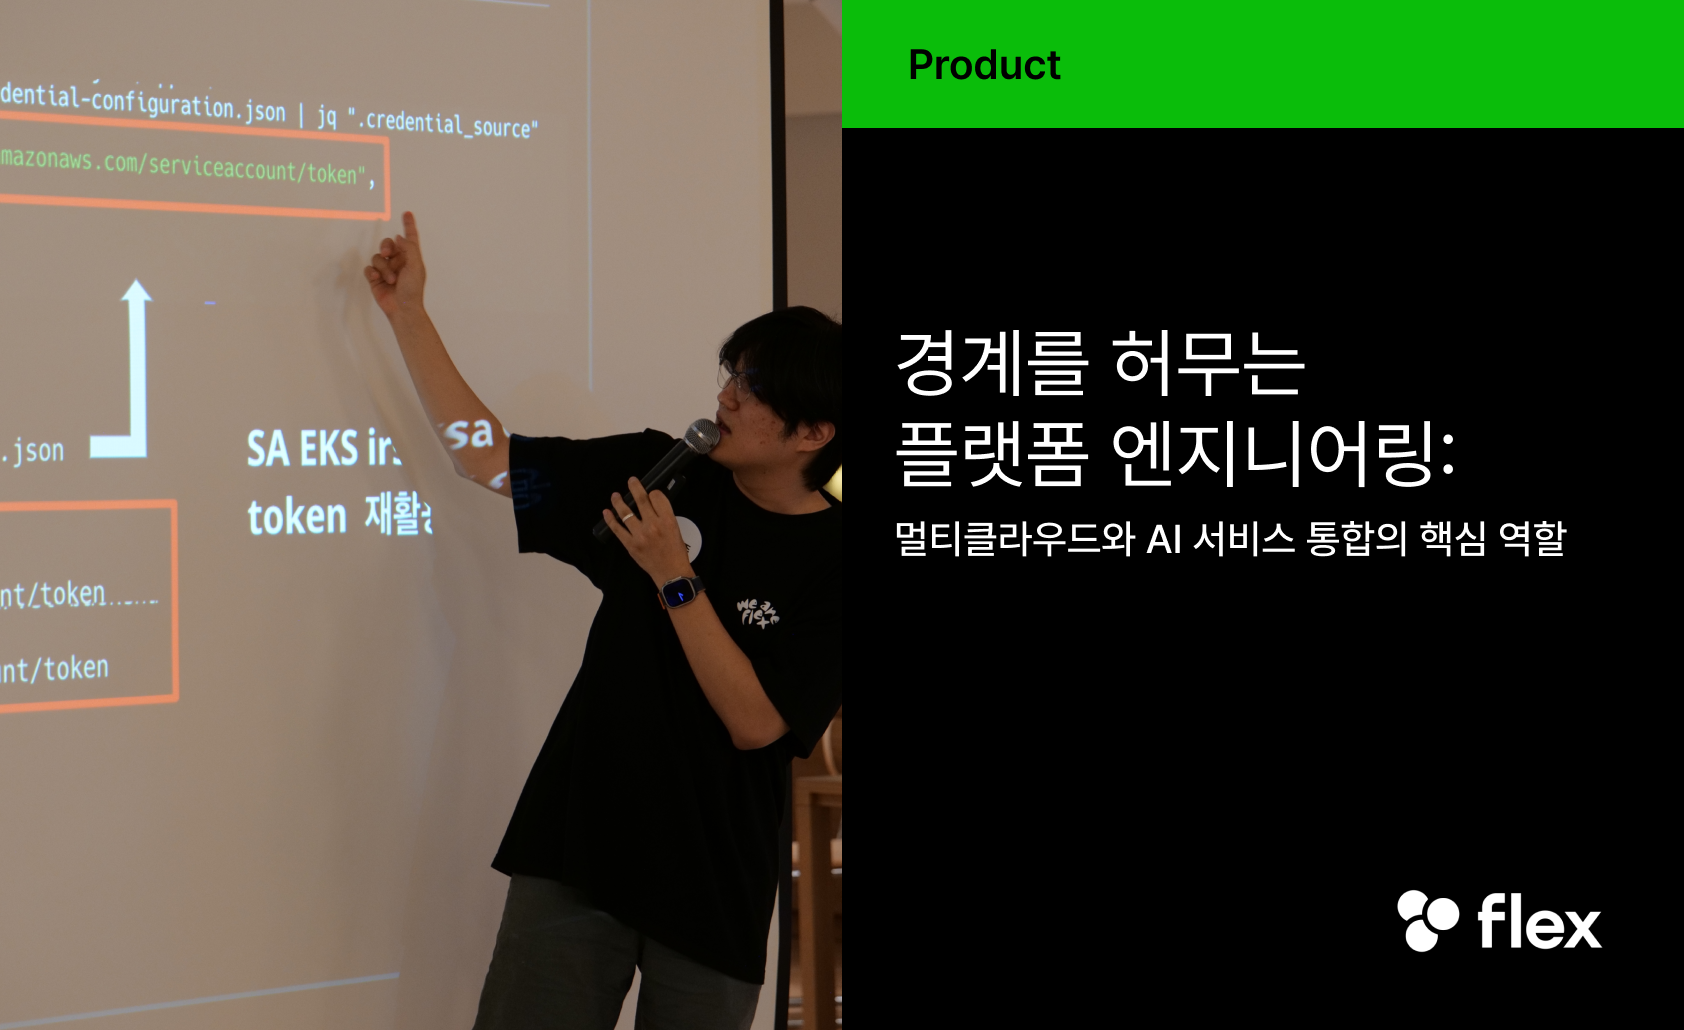

멀티클라우드와 AI 통합을 위해 LLM 비종속 아키텍처와 권한 자동화 체계를 구축했습니다. 또한 호출 로그를 모아 비용을 추적하고 FinOps 인사이트를 확보했습니다.

if(kakao)25에서 카카오모빌리티가 자율주행 AI와 경로탐색, AI 업무 자동화 사례를 공유했습니다. 실서비스 적용과 기술 교류를 함께 강조한 행사 리뷰였습니다.

Python 기반 에이전트 워크플로우 엔진을 Golang으로 전환한 사례를 소개했습니다. 고루틴과 채널로 스트리밍과 병렬 오케스트레이션을 구현해 응답 시간과 인프라 효율을 개선했습니다.
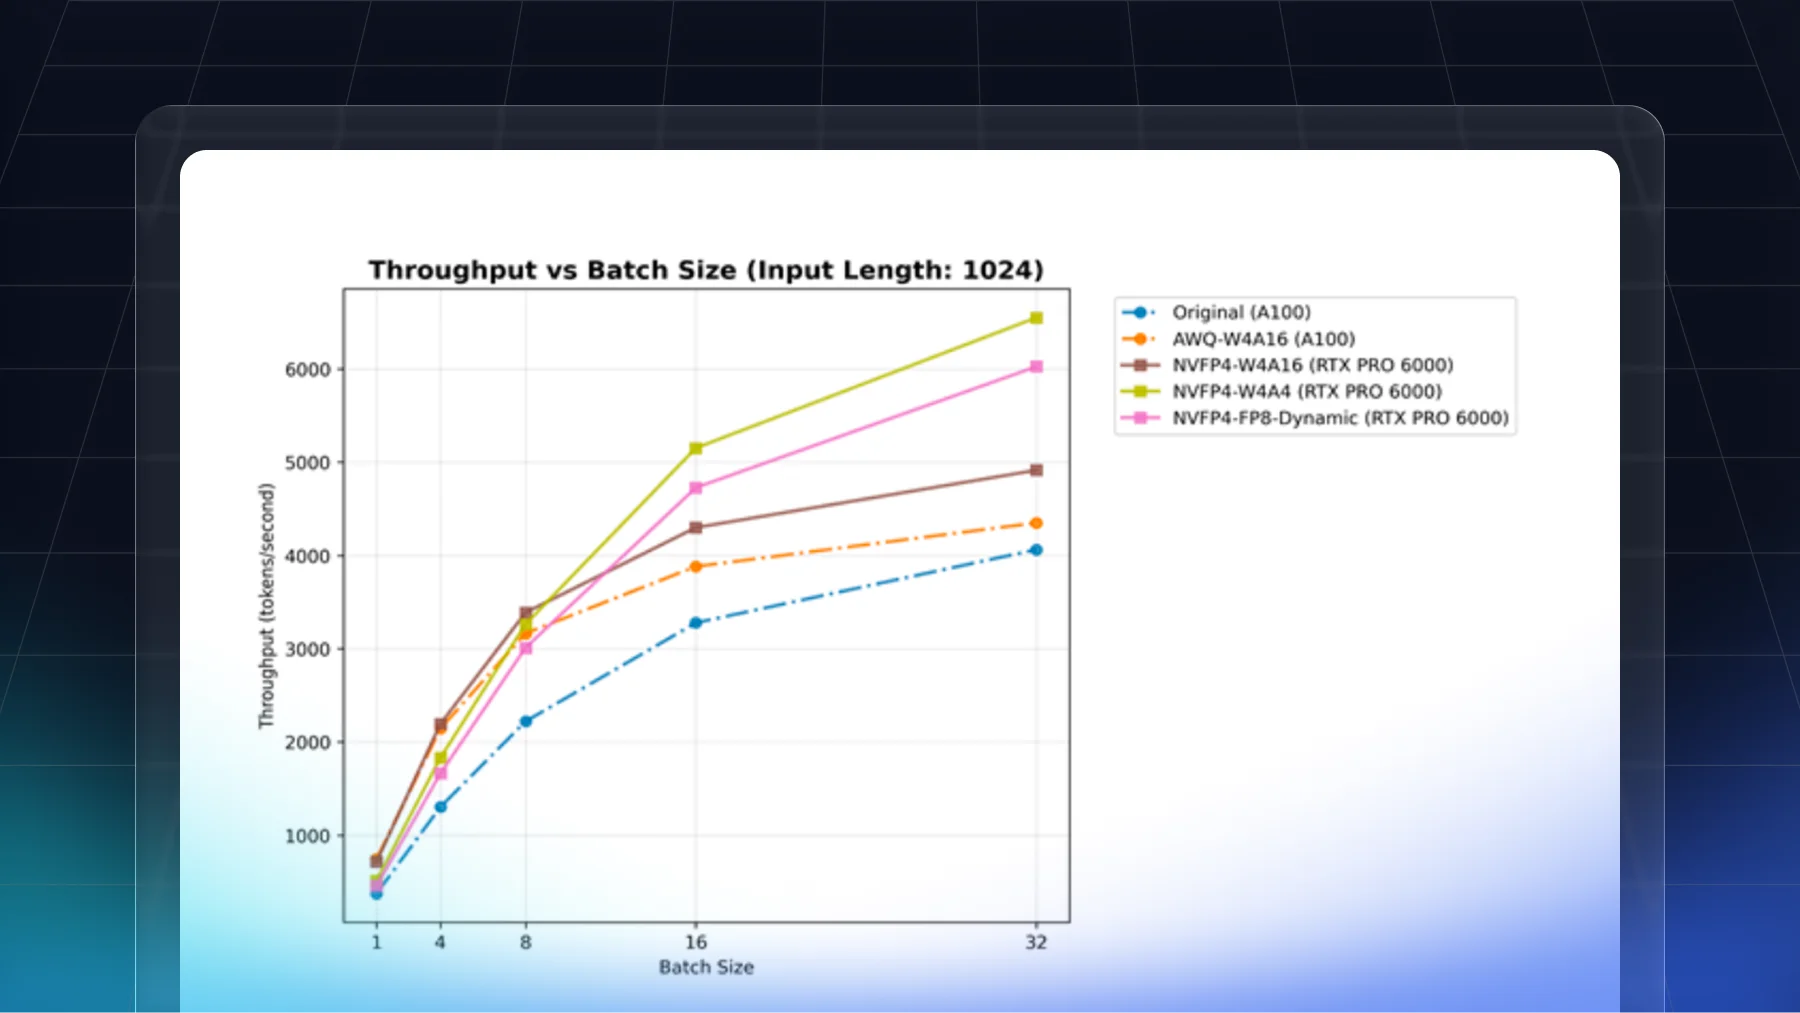
Blackwell용 NVFP4의 2단계 스케일링 구조와 LLM 추론 실측 결과를 분석했습니다. RTX PRO 6000에서 A100 대비 최대 2배 처리량과 미미한 정확도 차이를 확인했습니다.

제로 클릭 시대에 맞춘 GEO 전략과 AI 친화적 콘텐츠 제작 방법을 정리했습니다. 브랜드 엔티티와 채널 운영을 정비해 AI 인용과 전환을 높이는 실무 과제를 소개했습니다.
VLM 기반 상품 메타데이터 추출에서 Human-in-the-loop를 지원하는 어드민 구축 과정을 소개했습니다. 모델 추론, 검증, 골든셋 관리, 평가를 하나의 순환 구조로 묶어 운영 효율을 높였습니다.
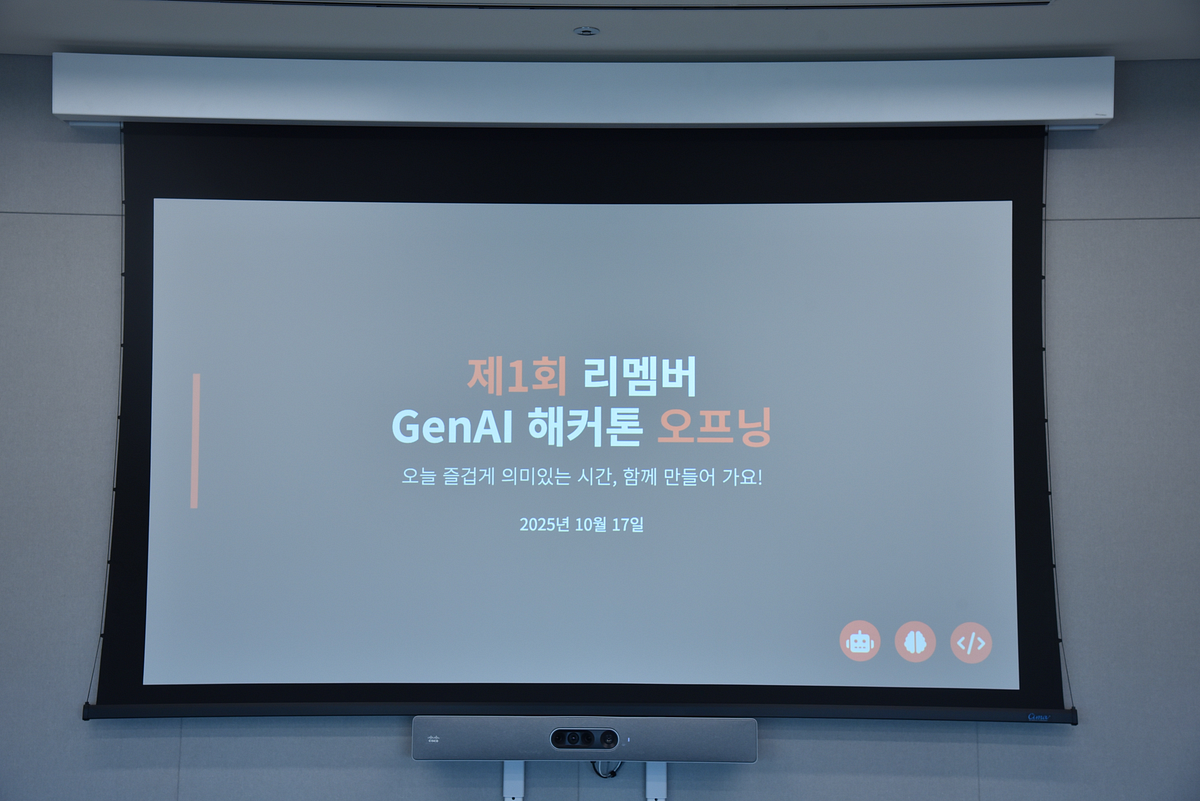
리멤버가 첫 사내 Gen AI 해커톤을 AWS와 함께 운영한 후기를 공유했습니다. 12개 팀의 열정적인 발표와 현장 대응 경험, 그리고 AI 아이디어의 실제 적용 기대를 전했습니다.
AWS Bedrock Prompt Caching으로 Chat DIC의 반복 프롬프트 재계산을 줄이고 응답 지연과 Throttling을 개선했습니다. 또한 system과 tools 문맥을 캐싱해 평균 응답 시간을 단축하고 비용도 절감했습니다.