

클린 코드의 기초
초심자 관점에서 좋은 코드를 클린 코드와 가독성 중심으로 설명했습니다. UML, 네이밍, 함수 분리, 주석 최소화, null 처리 원칙을 정리했습니다.
#클린 코드#가독성
5300
초심자 관점에서 좋은 코드를 클린 코드와 가독성 중심으로 설명했습니다. UML, 네이밍, 함수 분리, 주석 최소화, null 처리 원칙을 정리했습니다.
FMOps를 LLM 시대의 AI 앱 개발 방법론으로 소개했습니다. 프롬프트 체이닝과 데이터 연동, 모니터링을 중심으로 주요 플랫폼 사례를 정리했습니다.

iOS에서 음성대화 서비스를 구현하기 위해 WebRTC를 활용한 사례를 소개합니다. 멘토링매치의 1:1 음성 상담 기능에 적용한 접근을 다룹니다.

DNS를 서버보다 클라이언트 관점에서 바라보는 글입니다. DNS 보안 이슈를 클라이언트와 서버로 나눠 점검해야 한다고 설명했습니다.

젯브레인 계열 IDE에서 코드 가독성을 높이는 에디터 설정과 플러그인을 소개했습니다. 찾기 하이라이트, 변수 색상, 분리선, 인덴트 플러그인으로 코드 흐름을 더 쉽게 추적할 수 있습니다.
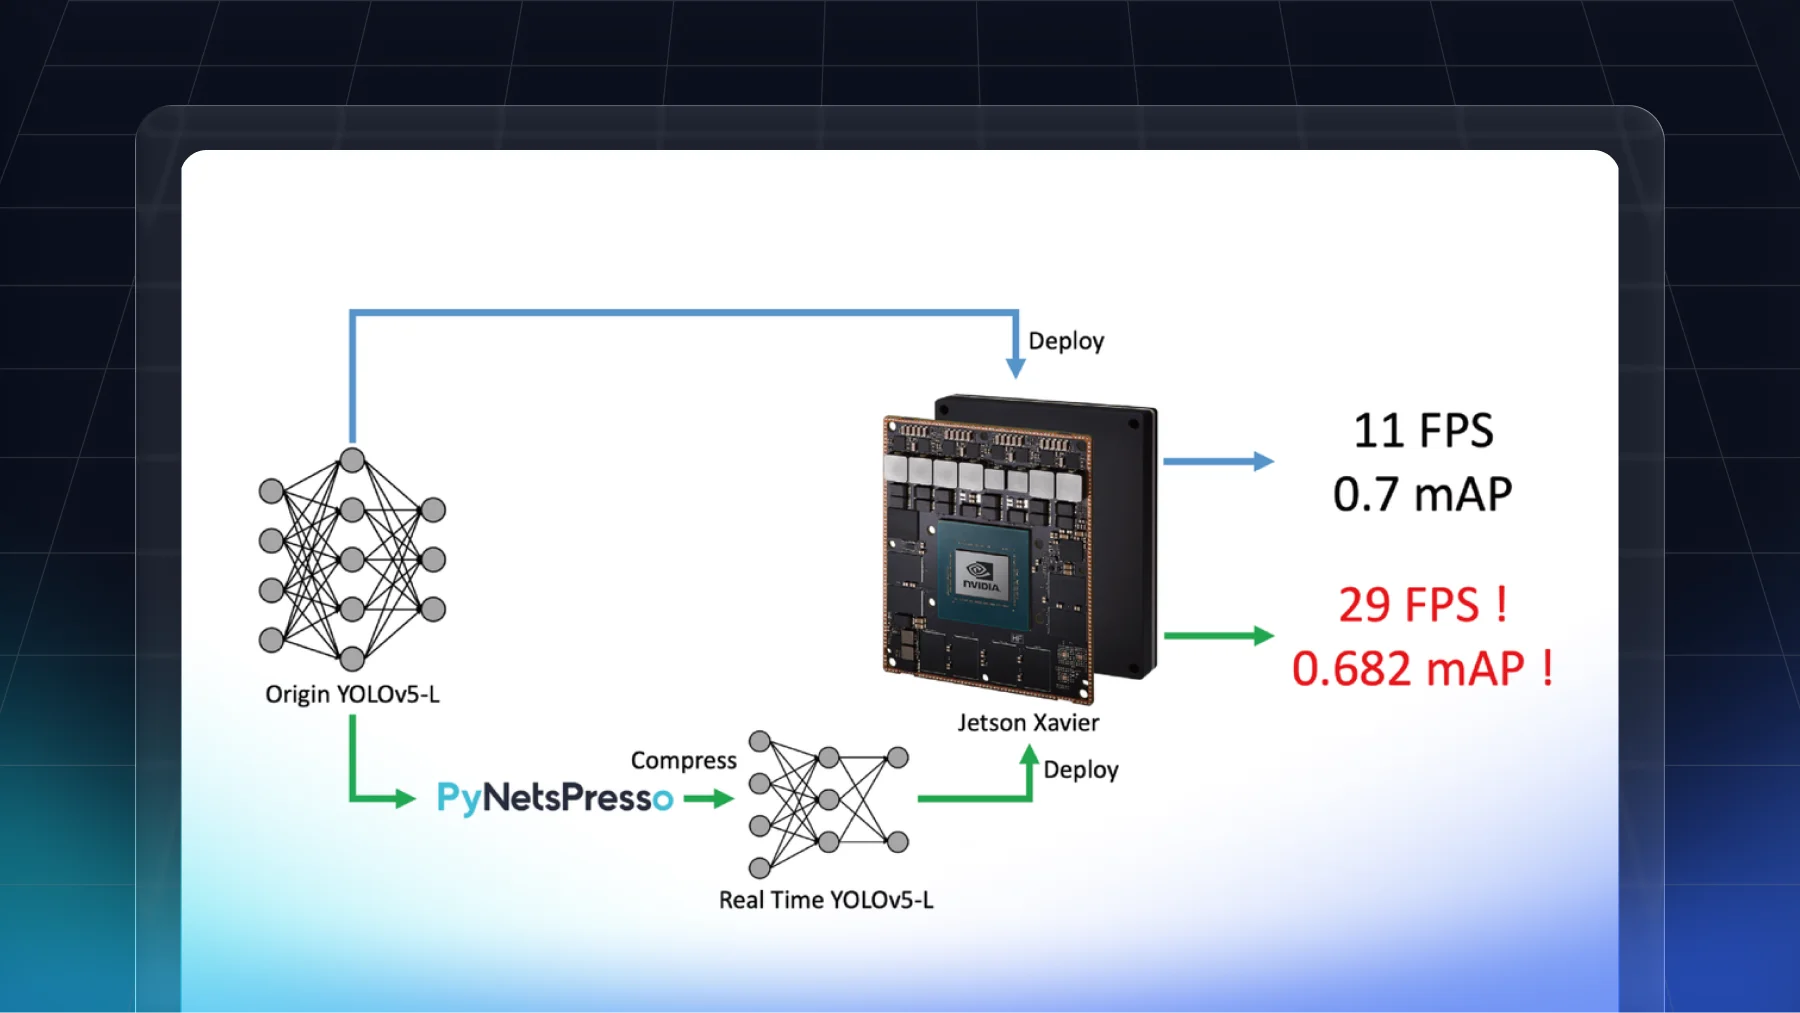
PyNetsPresso의 DAP로 YOLOv5-L에서 의존성을 고려한 파라미터 제거 방식을 소개했습니다. Jetson Xavier·TensorRT 환경에서 2.63배 성능 향상과 2% 수준의 성능 저하를 제시했습니다.

MSW를 활용해 브라우저와 Node 환경에서 API 목킹을 통합하는 방법을 정리했습니다. 개발 속도 차이와 테스트용 목업 중복 문제를 줄인 사례를 소개했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

Next.js의 이미지 최적화가 요청 시점에 어떻게 동작하는지 정리했습니다. 캐시 재사용, 포맷 선택, sharp와 Squoosh 성능 차이까지 살펴봤습니다.

슬랙봇으로 배포 업무를 자동화해 효율성을 높인 사례를 다뤘습니다. 반복 작업을 줄이고 운영 부담을 완화하는 방향을 제시했습니다.
Zustand의 상태 관리가 클로저와 React의 external store 구독으로 동작하는 방식을 설명했습니다. 또한 tearing 문제와 useSyncExternalStore의 역할을 통해 내부 원리를 따라 만들어 보았습니다.
MySQL 이력 데이터를 S3·Athena 구조로 옮기며 발생한 객체 호출 비용 문제를 분석했습니다. user id 버케팅과 일별 파티션으로 Athena 비용을 약 700배 줄였습니다.
이력성 데이터 증가로 MySQL 부담이 커져 S3와 Athena로 저장·조회 구조를 옮긴 사례를 다뤘습니다. Spark bucketing으로 필요한 데이터만 읽도록 최적화하는 흐름을 소개했습니다.
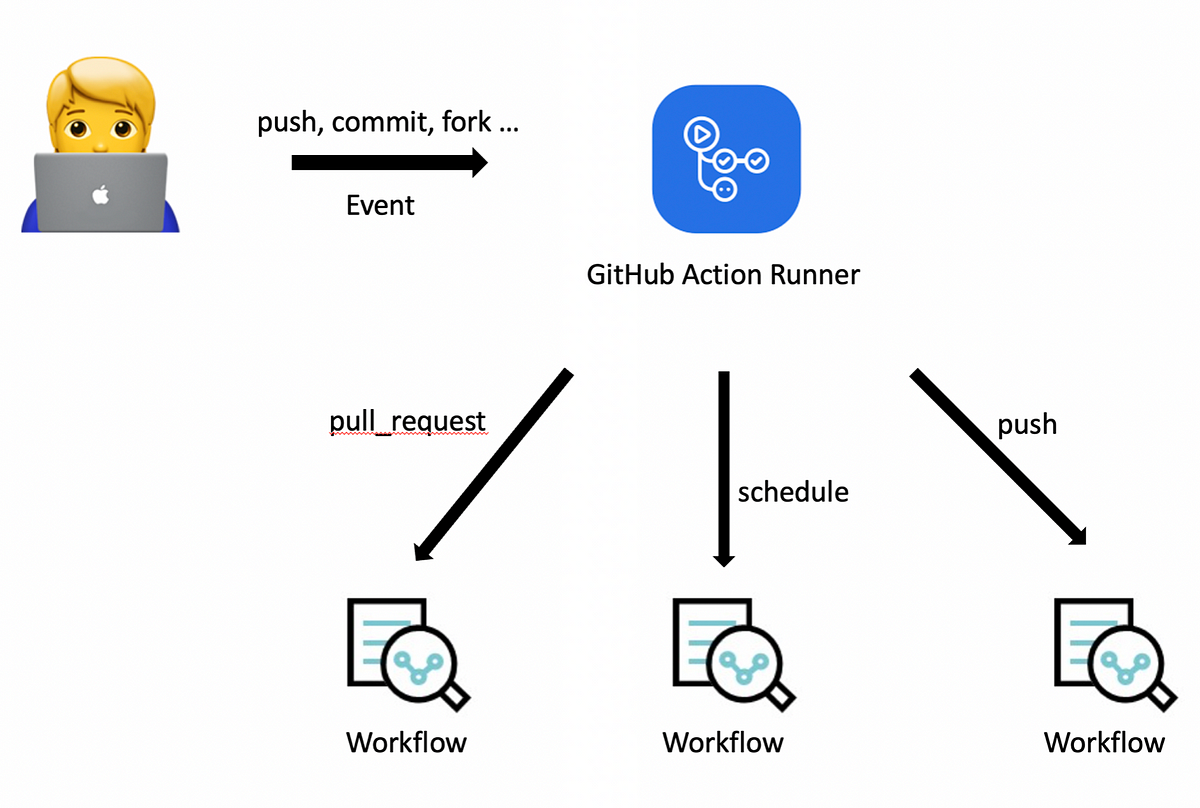
GitHub Actions로 PR 검사, 자동 승인, 코멘트 작성 같은 반복 작업을 자동화한 사례를 소개했습니다. 워크플로우, 컨텍스트, Marketplace 활용과 GitHub Enterprise 적용 시 유의점도 함께 정리했습니다.
분석 테이블을 API로 제공하는 dataserving 플랫폼 구축 과정을 소개했습니다. protobuf 명세와 데이터 파이프라인으로 다양한 데이터 제품 개발을 지원했습니다.