
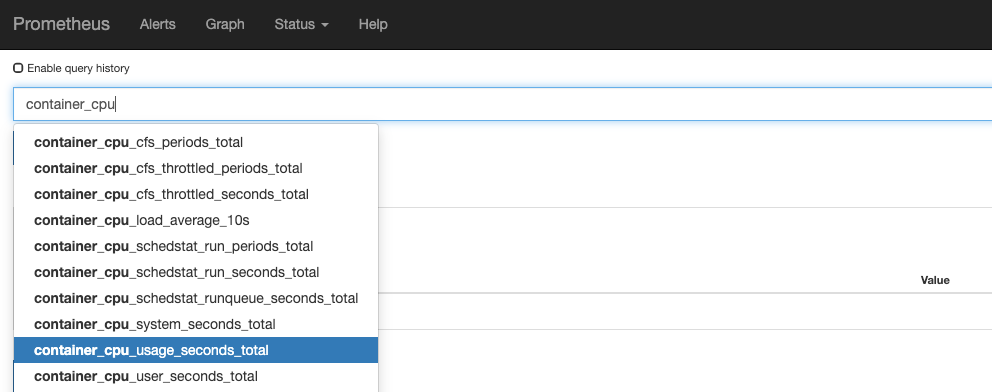

Prometheus 모니터링 실무 적용기 2탄
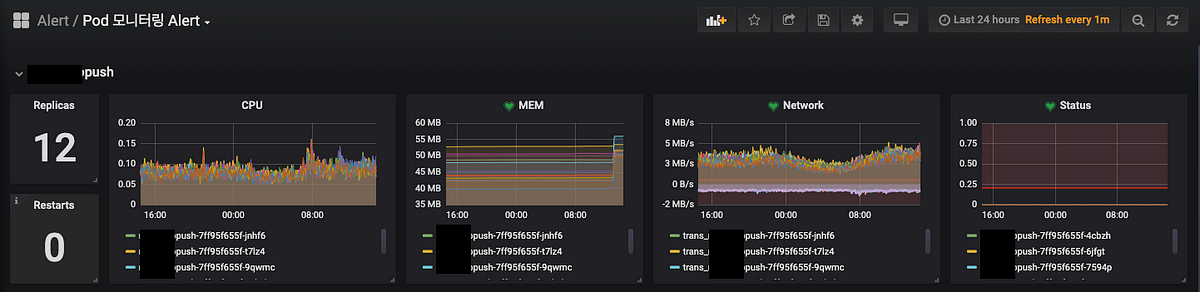
Prometheus와 Grafana로 Kubernetes의 Pod·Node 리소스 대시보드를 구성했습니다. 메모리 급증 알림과 Worker Node 자원 현황을 운영 대응에 활용했습니다.
#Prometheus#Grafana
2900
Prometheus와 Grafana로 Kubernetes의 Pod·Node 리소스 대시보드를 구성했습니다. 메모리 급증 알림과 Worker Node 자원 현황을 운영 대응에 활용했습니다.
Kubernetes와 기존 시스템을 통합 모니터링하기 위해 Prometheus와 Grafana를 도입했습니다. 데이터 보관 주기와 Persistent Volume 정책을 조정해 운영상 데이터 유실을 방지했습니다.

Windows 컨테이너의 HCS·HNS 기반 런타임과 네트워크 구조를 소개했습니다. OCI 호환성 및 Windows Server 라이선스·격리 방식 제약을 정리했습니다.


AWS 환경에서 gRPC 트래픽, Pod별 IAM, 로그·모니터링을 고려한 Kubernetes 구성 방식을 소개했습니다. NLB·NGINX와 Prometheus, Cluster Autoscaler의 선택 이유와 운영 주의점을 정리했습니다.

kops로 운영하던 Kubernetes 클러스터를 Amazon EKS로 무중단 이전한 과정을 공유했습니다. Terraform·Helm·Route 53 가중치 DNS로 서비스 재배포와 트래픽 점진 전환을 수행했습니다.

타다는 빠른 출시를 위해 Kotlin·Spring Boot와 AWS 관리형 서비스를 중심으로 시스템을 구성했습니다. SQS 배차, Kinesis 위치 수집, gRPC 실시간 이벤트로 모빌리티 흐름을 분리·확장했습니다.