
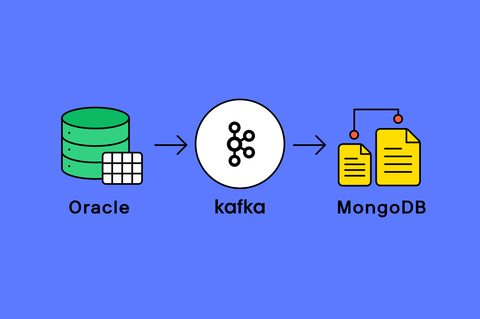
Oracle에서 MongoDB로의 CDC Pipeline 구축
Oracle에서 MongoDB로 초기 데이터 이관과 CDC 파이프라인 구축 경험을 공유했습니다. 관계형 DB에서 문서형 DB로의 변경 데이터 연동 흐름을 다뤘습니다.
#Oracle#MongoDB
2900
Oracle에서 MongoDB로 초기 데이터 이관과 CDC 파이프라인 구축 경험을 공유했습니다. 관계형 DB에서 문서형 DB로의 변경 데이터 연동 흐름을 다뤘습니다.
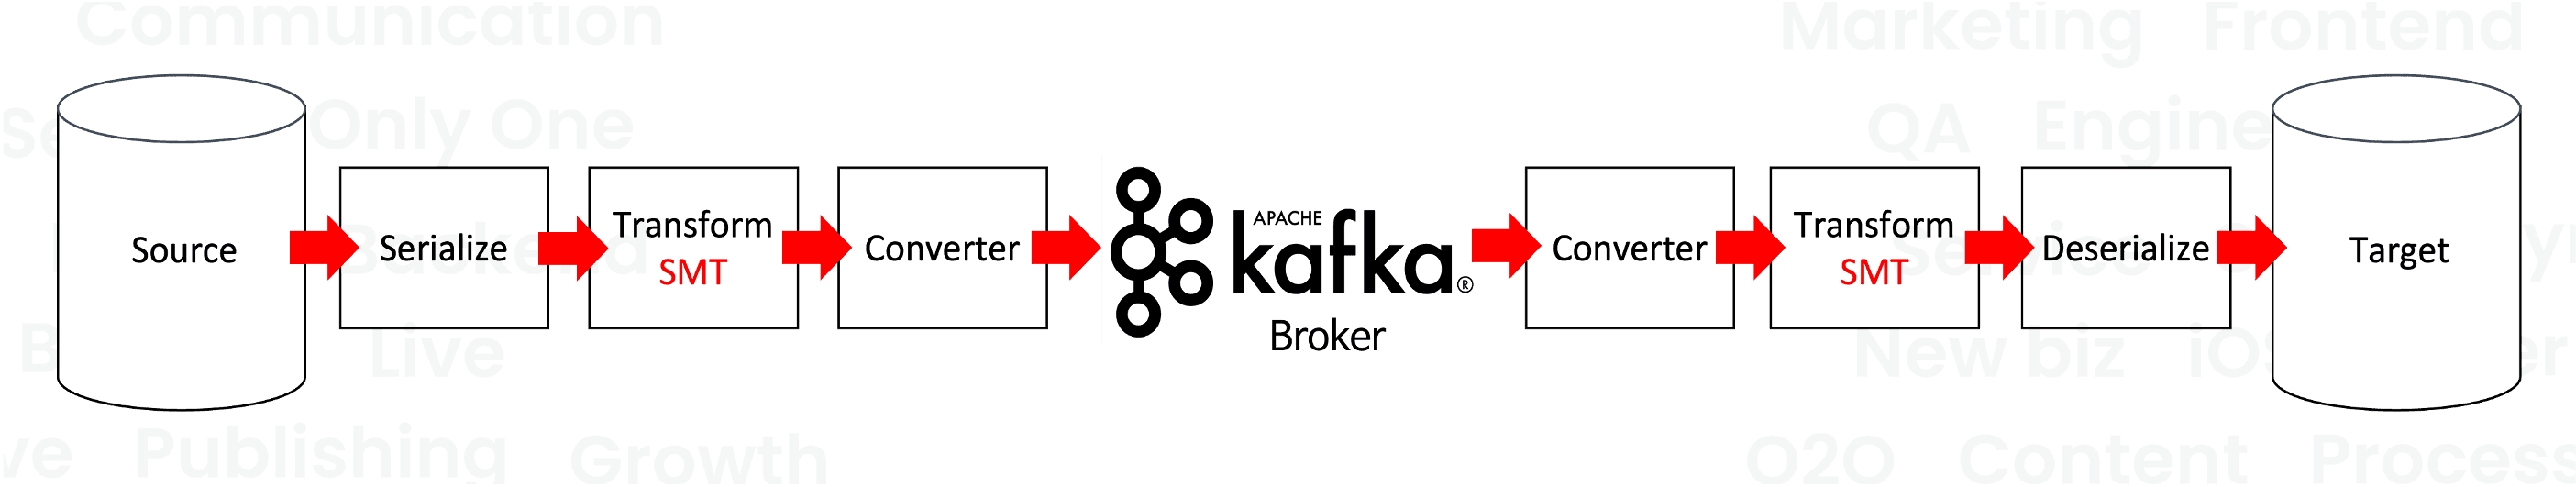

AWS MSK Connect와 Kafka 기반 CDC 운영 전략을 정리한 글입니다. 장애 대응, 데이터 경량화, DLQ, 모니터링 설정까지 실무 운영 포인트를 소개했습니다.

Debezium connector 재시작 때 오래된 binlog를 다시 읽으며 DB CPU가 급등한 원인을 분석했습니다. heartbeat.interval.ms를 적용해 상태 기록 주기를 보강하고 문제를 해결했습니다.

BigQuery 기반 CDC 파이프라인으로 정형·비정형 데이터를 Final 테이블에 동기화했습니다. Merge와 리소스 분리로 적재 시간·조회 응답 시간·비용을 개선했습니다.


Elasticsearch 색인 구조를 Kafka와 Debezium 기반 이벤트 처리로 전환한 사례를 소개했습니다. ECK를 함께 적용해 색인 속도와 운영 안정성을 함께 높였습니다.

CDC 데이터를 Kafka Streams로 가공해 Druid에 색인하고 API로 제공하는 PDS 구조를 소개했습니다. 실시간 집계와 운영 모니터링을 함께 설계한 사례를 다뤘습니다.