
고객 타게팅을 좀 더 정교하게, ClickHouse 도입기
고객 타게팅을 좀 더 정교하게, ClickHouse 도입기
고객 타게팅 정교화를 위해 주문·쿠폰·장바구니 데이터를 ClickHouse 기반 OLAP로 옮긴 과정을 정리했습니다. 다만 ReplacingMergeTree, JOIN, Point Query 한계를 보완하려고 하이브리드 아키텍처를 함께 도입했습니다.
#ClickHouse#OLAP
1100
고객 타게팅 정교화를 위해 주문·쿠폰·장바구니 데이터를 ClickHouse 기반 OLAP로 옮긴 과정을 정리했습니다. 다만 ReplacingMergeTree, JOIN, Point Query 한계를 보완하려고 하이브리드 아키텍처를 함께 도입했습니다.


Amazon RDS for PostgreSQL에서 시계열 데이터 수집을 빠르게 만드는 파티셔닝 방법을 정리했습니다. 벤치마크로 단일 테이블 대비 수집 시간이 크게 줄고, 인덱스 수가 성능에 미치는 영향도 확인했습니다.
AWS Transform for SQL Server를 사용해 SQL Server와 .NET 코드를 Aurora PostgreSQL 중심으로 현대화하는 흐름을 소개했습니다. 사전 준비부터 평가, 변환, 검증까지의 단계와 제한 사항도 함께 정리했습니다.
Amazon RDS for PostgreSQL에서 시계열 테이블을 고성능으로 설계하는 방법을 설명했습니다. 데이터 타입 최적화, BRIN 인덱스, 일별 파티셔닝으로 수집 성능을 크게 높였습니다.
AWS DMS의 Data Resync 기능으로 마이그레이션 중 데이터 불일치를 자동으로 수정하는 방법을 소개했습니다. Full load와 CDC 작업에서의 구성 방식과 운영 시 주의점도 함께 설명했습니다.

PostgreSQL의 JSON/JSONB 기능으로 스키마 유연성과 트랜잭션 무결성을 함께 확보하는 방법을 소개했습니다. CMS 예제를 통해 GIN 인덱스, JSON_TABLE, 전문 검색, AWS 운영 팁까지 정리했습니다.

Aurora PostgreSQL과 RDS PostgreSQL에서 TOAST OID 고갈이 INSERT 지연을 유발하는 원인과 진단 방법을 정리했습니다. 단기 대응과 함께 파티셔닝, 지속 모니터링 같은 장기 대응이 중요하다고 설명했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

일신비츠온은 MSSQL 레거시를 PostgreSQL로 옮기기 위해 DMS와 Babelfish를 먼저 활용했습니다. 복잡한 저장 프로시저와 함수는 Amazon Q Developer로 보완해 자동 변환율과 작업 속도를 크게 높였습니다.
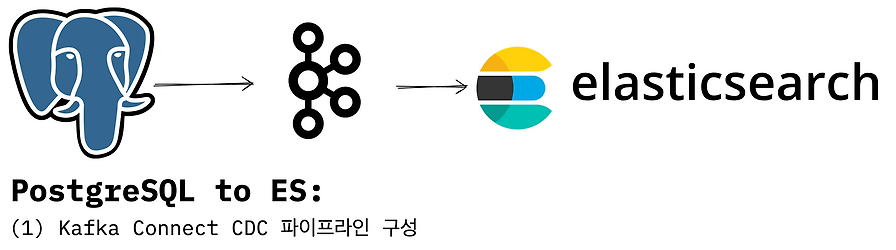
PostgreSQL 데이터를 Elasticsearch로 동기화하는 Kafka Connect CDC 파이프라인 구성 글입니다. 10년 넘게 운영한 레거시 시스템의 검색 연동 맥락을 소개합니다.
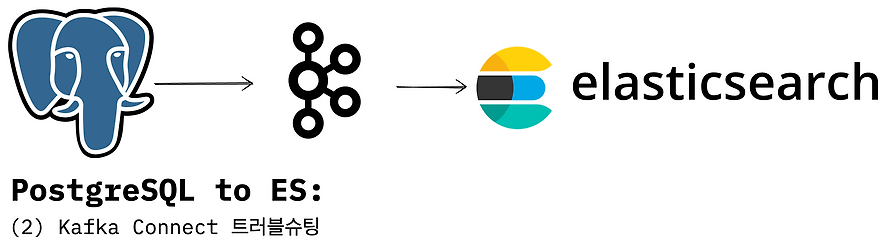
PostgreSQL에서 ES로의 CDC 파이프라인을 Kafka Connect로 구성한 뒤의 트러블슈팅 글입니다.

파티션 프루닝, 인덱스 정리, 조인 단순화로 PostgreSQL의 락 매니저 경합을 줄이는 방법을 다뤘습니다. 16개 빠른 경로 슬롯 초과 시 성능 저하가 커지며, 최적화로 TPS가 개선되었습니다.
Amazon Bedrock과 RDS for PostgreSQL로 대화 기록 기반 질의응답 기능을 구현한 사례를 소개했습니다. 의도 분석, 벡터 검색, 답변 생성 흐름으로 정확도와 다국어 대응을 높였습니다.
Amazon RDS for PostgreSQL에서 Dedicated Log Volume을 사용해 WAL을 분리하고 성능을 벤치마크한 사례를 다루었습니다. pgbench와 모니터링 지표를 통해 TPS 향상과 지연 시간 감소 효과를 확인했습니다.

PostgreSQL의 전체 텍스트, 벡터, 지리공간 검색을 결합해 구직 검색 엔진을 구축하는 방법을 소개했습니다.하이브리드 검색과 인덱싱, 파티셔닝 등 성능 최적화 포인트도 함께 정리했습니다.