
우아한형제들의 AI 거버넌스, 플랫폼에 담다
우아한형제들의 AI 거버넌스, 플랫폼에 담다
AI Studio와 AI Gateway로 LLM·Agent 사용 신청, 정책 승인, 호출 기록을 프로젝트 단위로 연결했습니다. 실시간 비용 관측과 프롬프트 캐싱으로 예산·보안을 관리하고 비용을 최적화했습니다.
#LLM#LiteLLM
6100
AI Studio와 AI Gateway로 LLM·Agent 사용 신청, 정책 승인, 호출 기록을 프로젝트 단위로 연결했습니다. 실시간 비용 관측과 프롬프트 캐싱으로 예산·보안을 관리하고 비용을 최적화했습니다.

격리된 자율 에이전트를 병렬 운영하고 사람은 결과를 검토·승인하는 플릿 모델을 설명합니다. 반복 업무부터 30·60·90일로 검증하며 거버넌스와 지식 베이스를 구축해야 합니다.
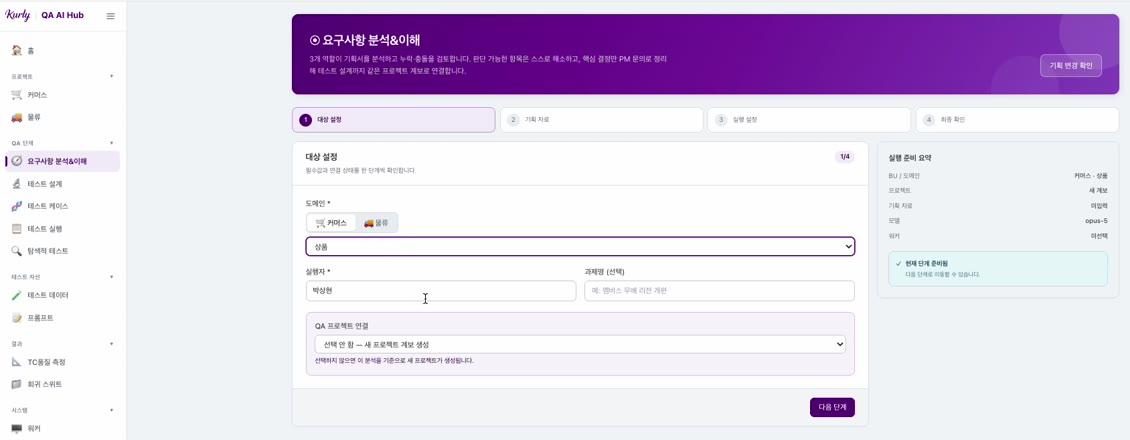
QA AI Hub로 기획서 분석부터 자연어 TC 실행, Jira 결함 등록까지 연결했습니다. 정답 TC·도메인 정책·이중 게이트로 생성 품질과 운영 신뢰도를 높였습니다.
반복적인 모델 학습·파라미터 수정 과정의 대기 문제를 다룹니다. 메신저와 LLM Agent를 연결한 MLOps 워크플로우를 소개합니다.

분산된 LLM 호출을 중앙 게이트웨이로 통합해 인증·비용·데이터 정책을 적용했습니다. EKS 기반 확장 구조와 CLI 자동화로 안정적인 전사 AI 사용 환경을 구축했습니다.
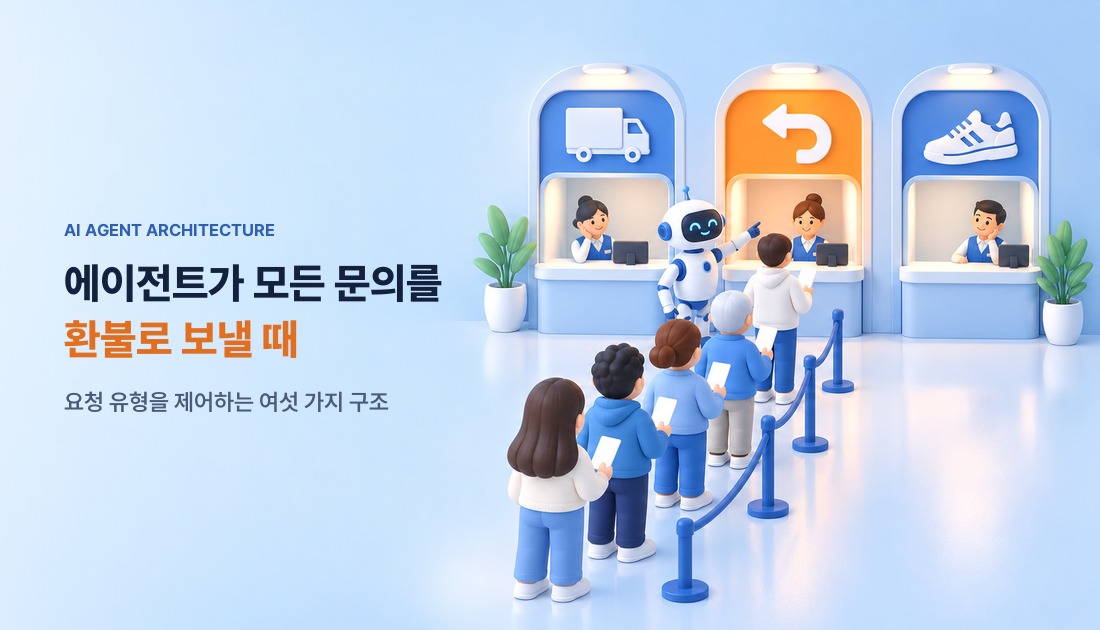

환불로 편향된 LLM 에이전트의 요청 유형 제어 문제를 여섯 가지 구조로 비교했습니다. 요청 특성·위험도·운영 여건에 따른 라우터, 가드레일, 검토 조합을 제안합니다.


MoE 전문가 사용량 편중을 분석해 REAP 기반 절반 프루닝을 적용했습니다. 유저 지표 차이 없이 GPU당 대화 처리량을 1.6배로 높였습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

블로그 발행 MCP 구현 경험으로 AI 에이전트의 구성요소와 단계적 도입 원칙을 정리했습니다. 운영 한계, 권한·데이터 거버넌스, 사람 승인 설계의 중요성을 설명합니다.
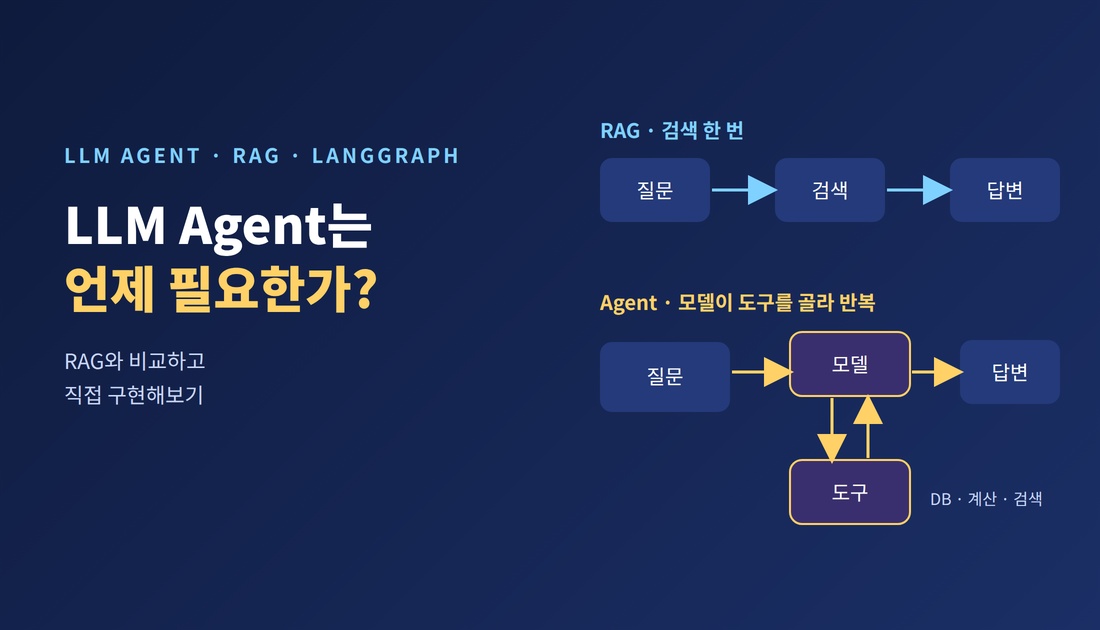
문서 질문에는 RAG가 충분하고 DB 조회·계산이 필요한 질문에는 Agent가 높은 정확도를 보였습니다. 다만 복합 질문의 오류와 비용 증가를 고려해 권한 통제와 도구 호출 기록 검증이 필요합니다.
MoE의 토큰별 라우팅, 총·활성 파라미터, 밀집 구조 대비 계산 효율을 설명했습니다. 메모리 요구량과 양자화 난점, 이를 줄이는 NMQ 접근도 소개했습니다.
데이터 거버넌스와 업무 맥락을 기반으로 AI 셀프서비스 분석 환경을 구축했습니다. 라우팅·역질문·평가 체계로 신뢰성을 높이고 데이터 요청 문의를 약 95% 줄였습니다.
AI 디자이너 MVP의 A/B 테스트와 발화 분석으로 이탈 원인을 기능 미지원·응답 지연으로 구분했습니다. 도구별 우선순위와 캔버스 맥락 활용 가설을 도출해 응답시간 개선과 제품 방향 논의에 반영했습니다.

SNAP은 LLM 로그를 작업별로 분류하고 소형 모델 학습 후보를 자동 발굴했습니다. 신뢰도 기반 폴백으로 품질을 유지하며 검증된 요청부터 LLM 비용을 줄였습니다.
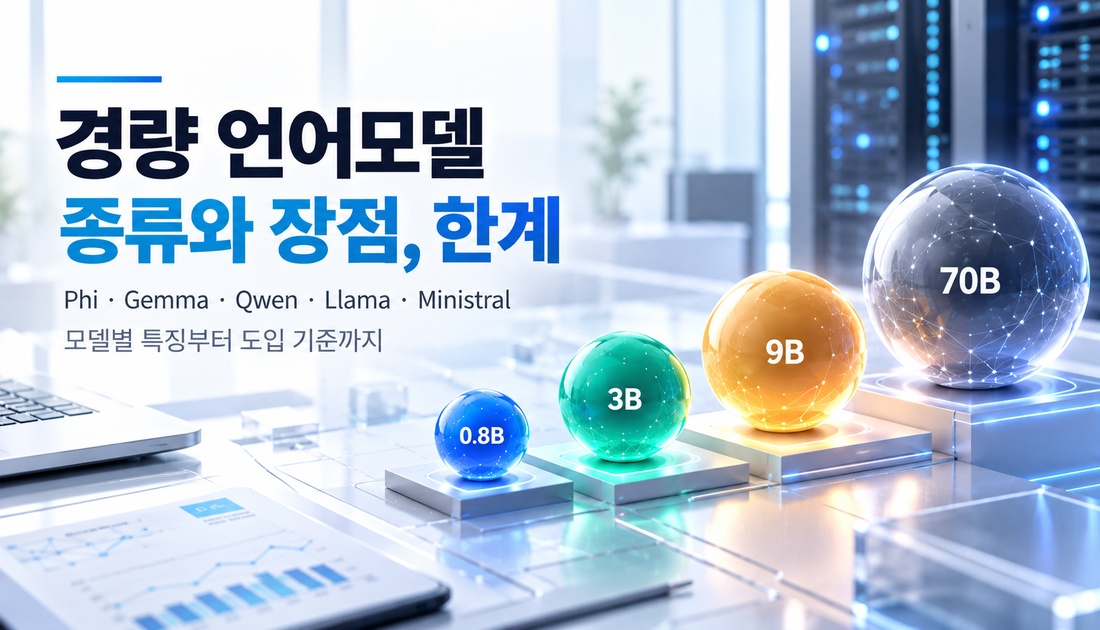
경량 언어모델의 종류와 메모리·비용·로컬 배포 측면의 장점을 정리했습니다. 실제 업무 데이터로 성능을 측정하고 RAG·검증 구조를 병행하는 방법을 제안합니다.