
Kafka와 ETL을 활용해 대용량 데이터 마이그레이션하기
대용량 이미지 데이터를 MySQL에서 MongoDB로 마이그레이션한 경험을 공유했습니다. Kafka, ETL, CDC를 조합해 동기화와 샤딩 최적화, 안정적 전환까지 진행했습니다.
#Kafka#ETL
6000
대용량 이미지 데이터를 MySQL에서 MongoDB로 마이그레이션한 경험을 공유했습니다. Kafka, ETL, CDC를 조합해 동기화와 샤딩 최적화, 안정적 전환까지 진행했습니다.


Talend Studio로 Oracle 테이블 ETL Job을 만들고 tMap, tFilterRow, 타입 변환 기능을 살펴보았습니다. TAC에서 빌드한 Job을 등록해 스케줄링과 모니터링까지 관리하는 흐름을 소개했습니다.
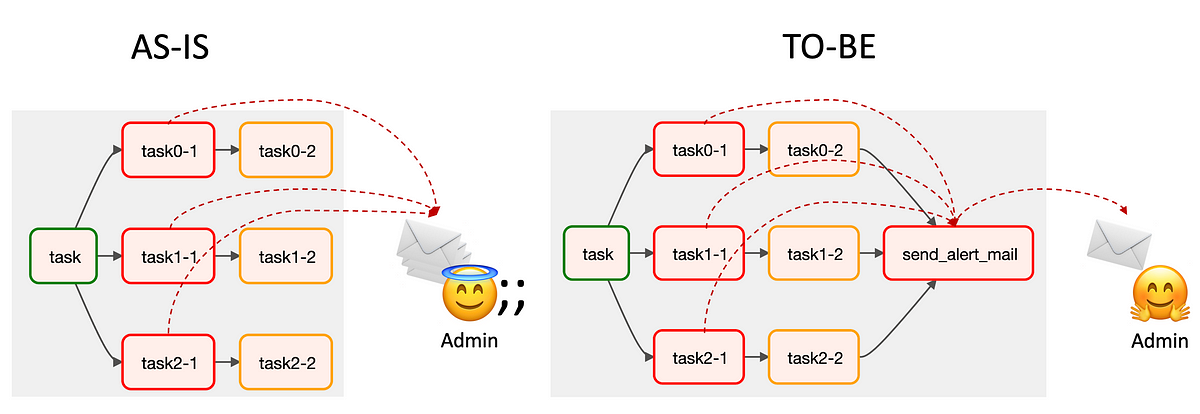
Airflow에서 동일 원인으로 반복 발송되는 Task 실패 알림을 하나로 통합하는 방법을 다루었습니다. DAG run의 Task Instance와 로그를 활용해 중복 메일 노이즈를 줄이는 구현을 소개했습니다.

Airflow 개발 환경을 Docker compose로 컨테이너화해 배포와 유사한 상태에서 실행·디버깅할 수 있게 구성했습니다. PyCharm 연동, Executor 분리, 설정 통합으로 개발 생산성과 관리 편의도 높였습니다.

원티드랩의 데이터 마트 설계 과정을 ERD 작성부터 운영 규칙 정립까지 정리했습니다. BigQuery와 Airflow를 활용해 확장성과 품질을 높인 운영 방식도 소개했습니다.

기존 오라클 프로시저 기반 랭킹 시스템의 확장성과 운영 비효율을 해결하기 위해 신규 아키텍처를 설계했습니다. AWS Glue, Athena, Step Function을 활용해 서버리스 랭킹 파이프라인을 구성했습니다.

분석 데이터를 프로덕션에서 쉽게 쓰기 위한 데이터서빙 서비스 구축 과정을 소개합니다. 분석 테이블을 API로 제공하기 위해 S3, Airflow, Spark 등을 활용했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
datapipe로 분석가가 데이터 파이프라인을 직접 정의·배포·운영하는 구조를 구축했습니다. 테스트와 데이터 품질 검증을 통합해 안정적인 자율 운영을 지원했습니다.
셀프 서빙 데이터 플랫폼을 구축한 사례를 소개했습니다. Airflow를 활용해 데이터 파이프라인 운영 부담을 줄이는 방향을 다뤘습니다.

올리브영은 IDC 기반 ETL·DW 구조를 GCP 기반 데이터 플랫폼으로 확장했습니다. Airflow·Spark·BigQuery로 데이터 수집·처리·분석과 로그 수집을 지원합니다.

Athena와 Redshift 직접 조인의 비용·성능 문제를 데이터마트로 완화하려 했습니다. PostgreSQL dblink와 자동 생성 프로시저로 Redshift 데이터를 선별 동기화했습니다.

HiveQL과 RDBMS 쿼리 구조를 개선해 ETL 처리 성능을 높이는 방법을 소개했습니다. 데이터 검증, 로그, 스케줄링을 통한 안정적인 ETL 운영 방식도 정리했습니다.
ETL의 추출·변환·적재 흐름과 데이터 웨어하우스에서의 역할을 정리했습니다. 멱등성, 점진 적재, 파티셔닝, 테스트와 모니터링 원칙을 제시했습니다.

제품 팀은 전원 원격근무 전환과 적극적 소통으로 업무 수행 역량을 유지했습니다. 데이터 파이프라인을 개선하고 위피 해외 실험과 콰트 앱·웹 출시를 진행했습니다.