


iOS 개발자를 위한 DocC 실무 튜토리얼
DocC를 활용한 iOS 문서화 실무 흐름과 배포 방법을 정리했습니다. 코드와 문서를 동기화해 협업 비용을 줄이는 효과도 소개했습니다.
#iOS#DocC
11800
DocC를 활용한 iOS 문서화 실무 흐름과 배포 방법을 정리했습니다. 코드와 문서를 동기화해 협업 비용을 줄이는 효과도 소개했습니다.
밸런스히어로 데이터사이언티스트의 ZINDI 2위 수상 경험을 인터뷰로 소개했습니다. 신용평가 도메인 지식과 피처 파이프라인이 성과의 핵심이었습니다.
밸런스히어로 데이터사이언티스트가 ZINDI 신용평가 대회 2위 수상 경험을 공유했습니다. 국가별 데이터 분포 차이와 시간 제약을 피처 파이프라인과 모델 분리 전략으로 극복했습니다.
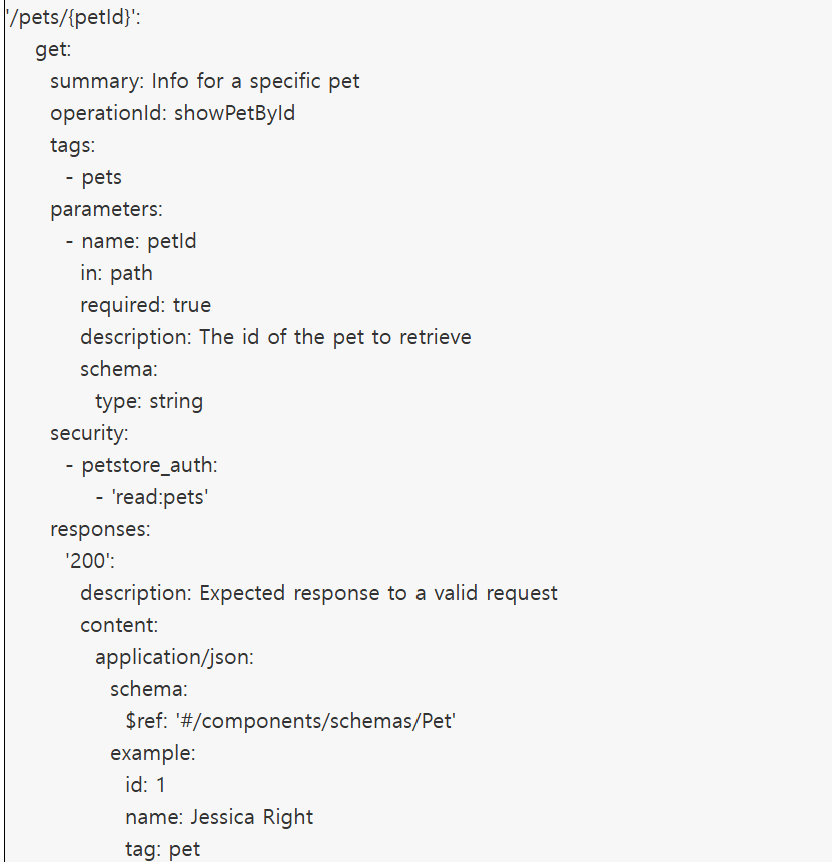
OpenAPI 3.0 스펙을 설계 우선 관점에서 작성하는 원칙과 주의점을 정리했습니다. 보안, 스키마 재사용, 예제, 코드 생성을 통해 API 계약 품질을 높이는 방법을 소개했습니다.
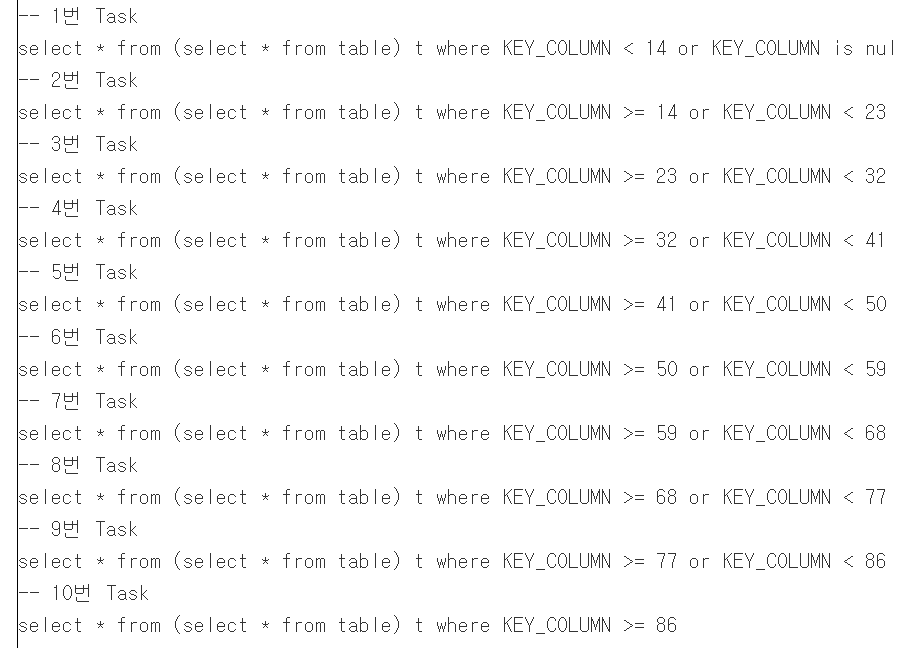
Spark JDBC 병렬처리의 기본 사용법과 파티션 분할 방식의 주의점을 설명했습니다. 소수점 버림으로 인한 skew를 줄이기 위해 upperBound 설정과 컬럼 분포 점검이 필요했습니다.
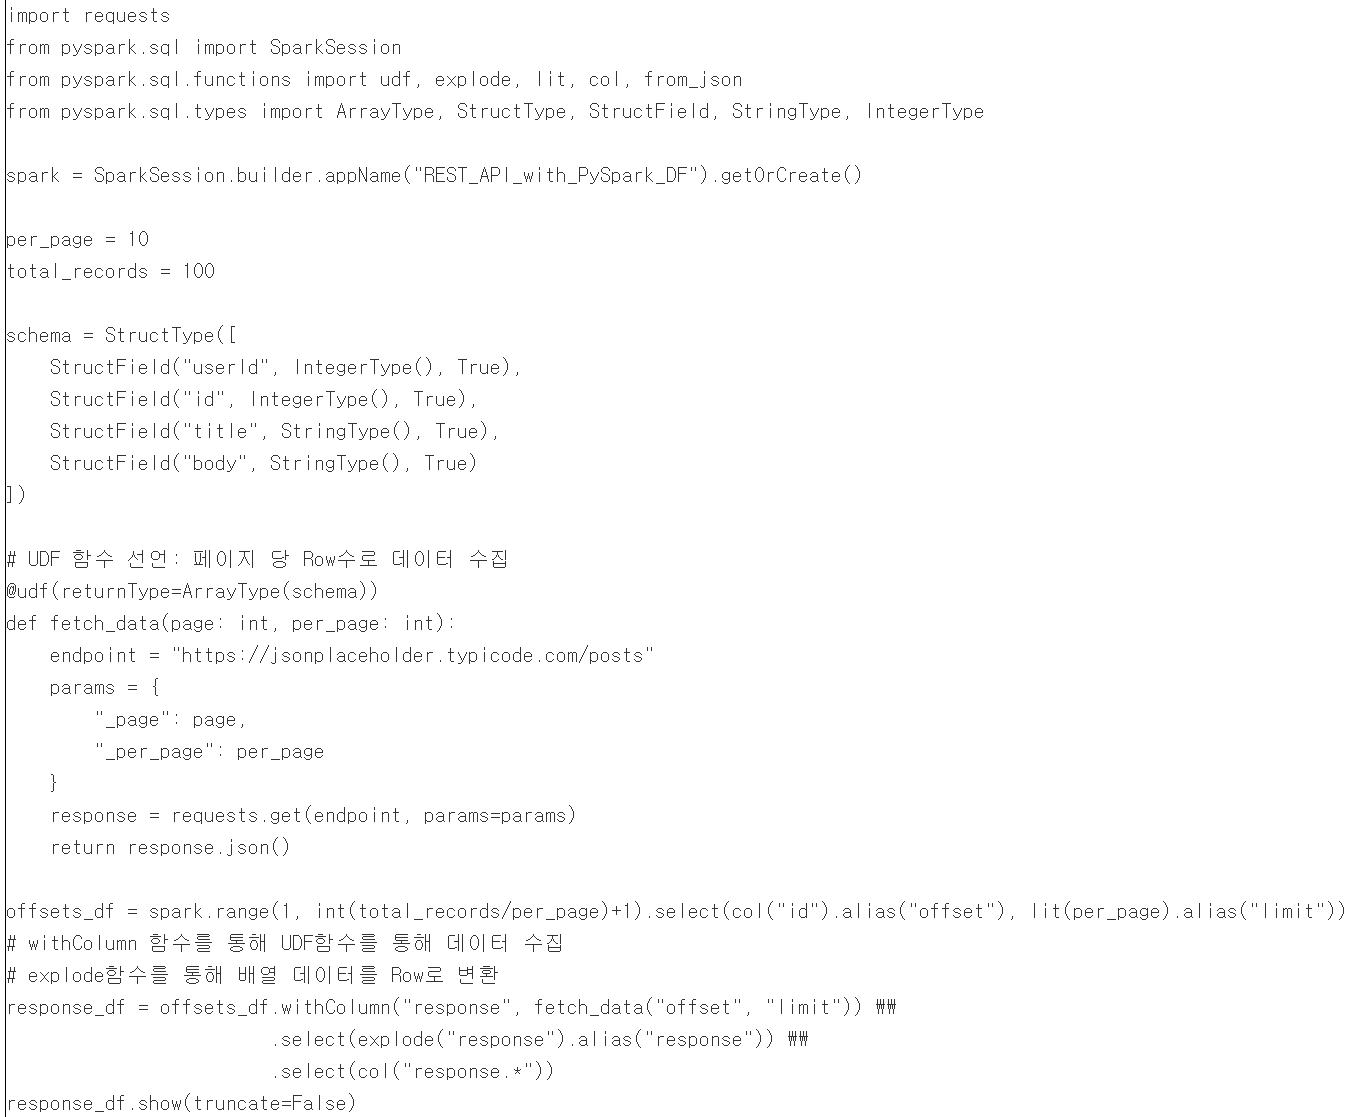
Spark에서 Rest API 데이터를 수집하는 두 가지 방법을 비교했습니다. 단순 requests 방식과 Spark UDF 방식의 장단점 및 대량 데이터 처리 시 고려점을 설명했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.


AUTO의 차량 내 음성 서비스 품질을 높이기 위해 잡음과 왜곡 요인을 분석하고 평가했습니다. 또한 POLQA 같은 객관적 지표로 음성 품질 판단 신뢰도를 높였습니다.
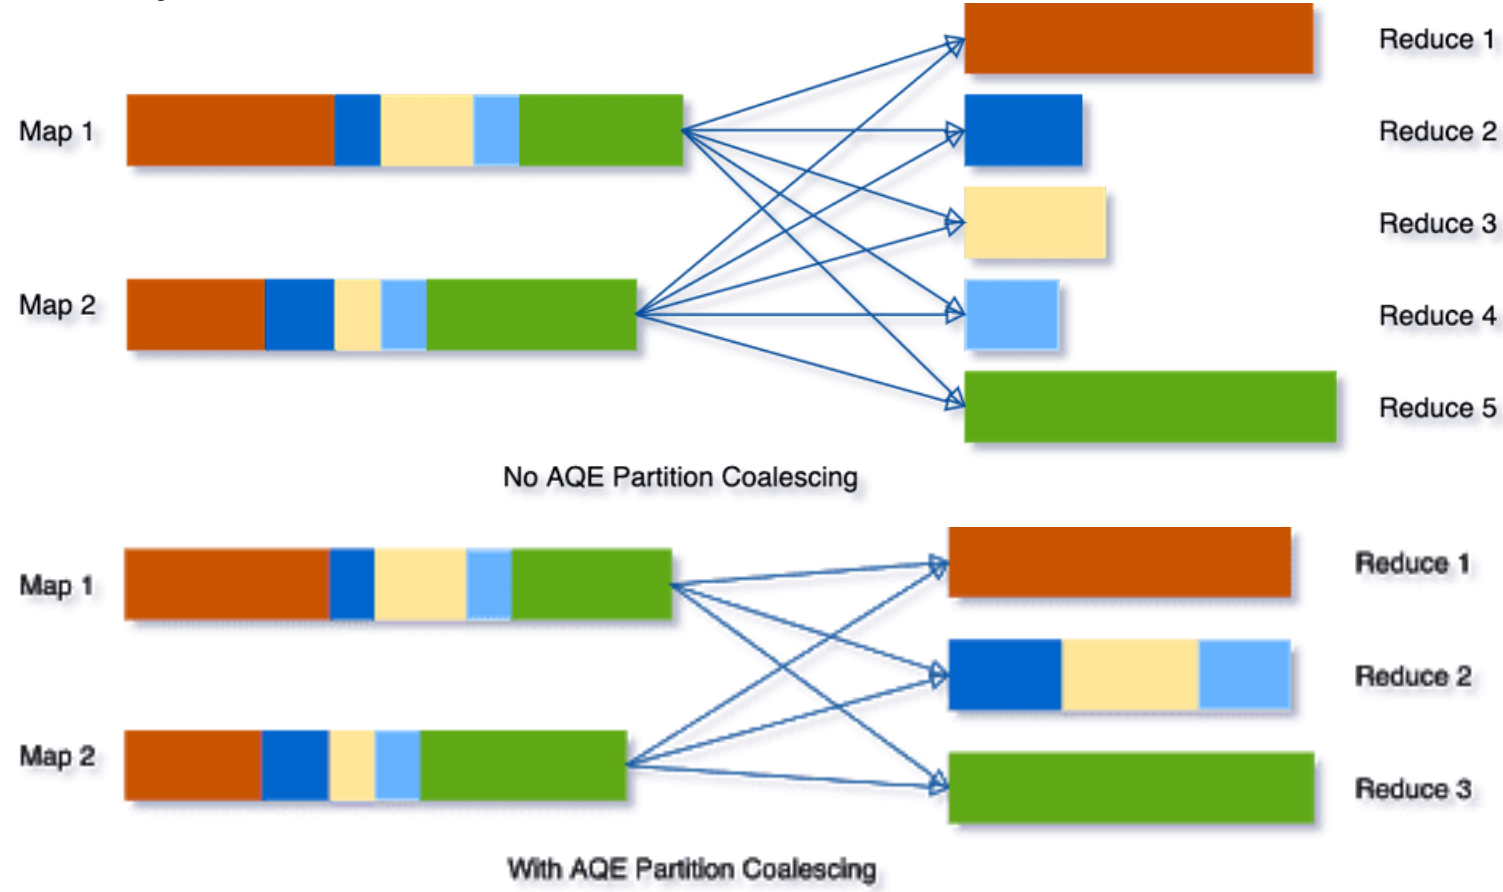
Spark 3.0의 AQE와 coalescePartitions로 셔플 파티션을 동적으로 최적화하는 내용을 소개했습니다. 셔플 파티션 크기에 따른 성능 저하 문제와 파티션 병합 방식도 설명했습니다.

Claude Desktop에 MCP를 연결하는 방법과 기본 설정 과정을 설명했습니다. 파일시스템부터 다양한 외부 서비스까지 LLM 연동 범위를 넓히는 활용 예시를 정리했습니다.

AWS HealthOmics의 핵심 구성요소와 워크플로우, 비용 체계를 소개했습니다. 연구자가 바이오데이터 분석을 더 쉽게 시작할 수 있는 관리형 서비스로 설명했습니다.
AWS Management Console의 Multi-Session 기능으로 하나의 브라우저에서 최대 5개 AWS 환경을 동시에 사용할 수 있음을 소개했습니다. 역할 전환, 세션 종료, 비활성화 방법까지 함께 설명했습니다.

Robot Framework로 웹 테스트 자동화를 도입한 과정과 운영 방식을 소개했습니다. 반복 검증을 키워드화·모듈화하고 Jenkins, Docker, Slack으로 모니터링까지 확장했습니다.

Elasticsearch 사각형 공간 검색에서 Box와 Polygon의 성능을 비교했습니다. 두 방식은 큰 차이 없이 유사했으며, 단순 검색에는 Box를 우선 고려할 수 있었습니다.
Flink 어플리케이션의 end-to-end latency 병목을 찾기 위해 operator 지표와 flame graph를 활용하는 방법을 소개했습니다. 처리 시간과 처리 외 시간을 분리해 관측하고, 병목 유형별로 다른 개선 방향을 제시했습니다.