Product Engineer: 하루 500건 분석 요청을 받아내는 데이터 에이전트, 일을 돕는 AI에서 일을 수행하는 AI로
슬랙 기반 데이터 에이전트로 반복 분석 요청을 자동 처리하는 구조를 소개했습니다.정확도와 안전성을 위해 지식 체계, 서브 에이전트, 평가 루프를 함께 설계했습니다.

PM 반복 업무를 재현 가능한 AI 워크플로우로 정리한 사례를 소개했습니다. 데이터 검증, 승인, 산출물 연결까지 포함해 조직 지식으로 축적하는 방법을 설명했습니다.

Dell Pro Max GB10 AI 워크스테이션의 구조와 실사용 성능을 검증한 리뷰였습니다. 로컬에서 70B급 모델을 빠르게 돌릴 수 있는 통합 메모리 기반 AI 노드로 소개했습니다.

생성형 AI가 개발 생산성과 학습 속도를 크게 높이는 실무 도구로 소개되었습니다. 다만 할루시네이션과 보안 문제를 막기 위해 인간 검증과 가이드라인이 필요합니다.

카카오페이와 토스의 TAM 담당자들이 처음 만나 기술지원의 고민과 운영 방식을 공유했습니다. 리더십, 자동화, 백업 시스템 등 실무 인사이트와 연대감을 나눈 교류 행사였습니다.
공공 AX를 실제 행정 업무에 적용하기 위한 네이버클라우드의 AI·협업 플랫폼 전략을 소개했습니다. 소버린 AI, 멀티 LLM, RAG 에이전트와 네이버웍스 도입 사례를 공유했습니다.


GraphRAG Toolkit으로 지식 그래프 기반 인덱싱 과정을 소개했습니다. 기존 RAG의 한계를 보완하는 어휘 그래프 구조와 추출·구축 흐름도 함께 설명했습니다.

답변 재생성 시그널을 정제해 DPO 학습용 선호 페어를 구성했습니다. 강한 거부 신호와 분포 조정으로 이용 시간·리텐션을 개선했습니다.
이 게시물은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

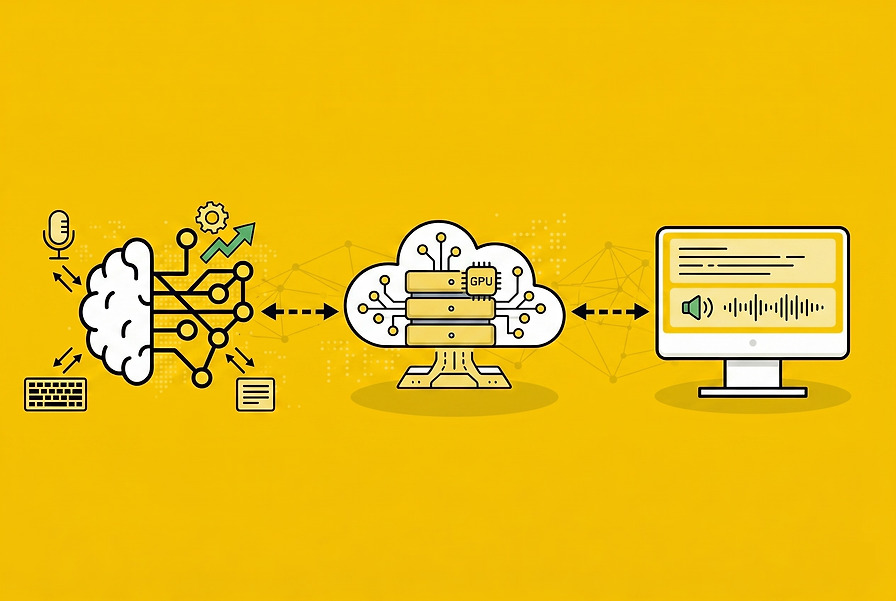
음성 AI 모델 Kanana-O를 프로덕션에 올리기 위한 서빙 최적화 여정을 다루는 글입니다. 발췌에는 모델 개요만 있어 세부 내용은 확인되지 않았습니다.


AI 코딩 도구의 ROI를 비용과 품질 지표로 나눠 측정하는 방법을 정리했습니다. 각 지표의 의미와 한계를 함께 살펴보며 정확한 판단 기준을 제안했습니다.

키다리스튜디오는 Amazon Bedrock과 LangGraph로 QA 테스트 케이스 생성 자동화를 구현했습니다. 수 시간 걸리던 작업을 분 단위로 줄이고, 멀티 에이전트와 Human-in-the-Loop로 품질을 보완했습니다.

kt cloud AI Foundry로 AI 서비스 구축 과정을 5단계로 정리했습니다. RAG, 가드레일, API 통합과 운영 고도화 흐름을 사례와 함께 소개했습니다.

온톨로지를 LLM 환각 완화용 지식 구조로 설명하고 RAG와의 차이를 정리했습니다. Graph RAG와 AWS 서비스 조합으로 하이브리드 활용 방안도 소개했습니다.


포스타입이 캐릭터톡 출시를 앞두고 4일간의 TF와 PoC로 사업 가능성을 검증했습니다. 시스템 프롬프트, 모델 선택, 비용과 품질 점검을 통해 출시 수준의 페르소나 챗을 만들었습니다.